PRINZIPIEN DES MP3-FORMATS ENCODIEREN.


Free Download Mp4Gain
picture

PRINZIPIEN DES MP3-FORMATS ENCODIEREN.
Mp3 Encoding

MP3 oder MPEG-1, 2 und 2.5 Layer 3 ist einer der beliebtesten und am weitesten verbreiteten Standards zum Speichern von Audiodaten.

MP3 ENCODING

In diesem Artikel werden wir uns nicht mit der Geschichte der Entstehung und Weiterentwicklung befassen, sondern die Grundprinzipien des Standards und Beispiele für dessen Umsetzung betrachten.

Der MP3-Standard legt keinen spezifischen Komprimierungsalgorithmus zum “Codieren” der Quelldaten fest, sondern beschreibt das Wesentliche der möglichen Methoden.

Die Qualität des erhaltenen Ergebnisses hängt von der Modifikation des verwendeten Algorithmus ab, der in ein beliebiges Codierungsprogramm des “Codecs” eingebettet ist, und von der Qualität der ursprünglichen Audiodaten.

Es gibt 3 häufigste Änderungen des MP3-Formats, die sich in den Komprimierungsverhältnisparametern der ursprünglichen Audiodaten unterscheiden.

Name
Änderung der Regel
Datenrate pro Sekunde (Bitrate) Mögliche Abtastraten
MPEG-1-Schicht 3
32 – 320 kbps 32000 Hz
44100 Hz
48000 Hz
MPEG-2 Layer 3 16 – 160 kbps 16000 Hz
22050 Hz
24000 Hz
MPEG-2.5 Layer 3 8 – bis zu 160 kbps 8000 Hz
11025 Hz

Die Verarbeitung beginnt mit der Aufteilung des ursprünglichen Audiosignals in gleiche Zeitintervalle: gleiche Bilder, beispielsweise 0,05 oder 0,26 Sekunden, wonach jedes Bild nach allgemeinen oder individuellen Parametern analysiert und komprimiert wird basierend auf den Daten des vorherigen und nächsten Frames.

Die meisten verwendeten Komprimierungsalgorithmen basieren auf den Wahrnehmungseigenschaften des menschlichen Ohrs. Betrachten wir die Hauptoptionen, die in der Regel auf komplexe Weise angewendet werden.

Es lohnt sich, mit der Tatsache zu beginnen, dass die durchschnittliche Person nach Gehör einen Frequenzbereich von ungefähr 10 Hz bis 20.000 Hz wahrnehmen kann. Mit dem Wachstum treten Änderungen im Hörgerät und für die meisten in der Empfindlichkeit auf Der höhere Frequenzbereich nimmt ab, wodurch bei einigen MP3-Modifikationen während der Komprimierung alle Frequenzen über 16000 Hertz abgeschnitten werden, was die Informationsmenge erheblich reduzieren kann.

Audioaufnahmen können in Stereo (ein Surround-Sound-Effekt, der separate Kanäle für den linken und rechten Lautsprecher verwendet) oder Mono (das Gegenteil von Stereo) codiert werden. Im MP3-Format werden nicht für jeden Ihrer Lautsprecher unterschiedliche Titel aufgezeichnet, sondern Informationen zu den Unterschieden zwischen dem linken und dem rechten Kanal.

In der Akustik gibt es ein Konzept wie “Harmonische”, dies sind die Frequenzen der “Klänge”, die zusammen mit dem Haupt- und dem prominentesten Ton klingen. Wenn Sie beispielsweise auf eine Trommel schlagen, ist der lauteste Klang der Ton und der kleinere, schwächere Klang die Harmonischen.

Nach einem so lauten Geräusch tritt die sogenannte “Periode der Taubheit” während eines Zeitraums auf, in dem das Gehör einer Person praktisch nicht auf Veränderungen reagiert.

Wenn in den Intervallen der “Taubheitsperiode” alle Frequenzen entfernt werden, können die Wahrnehmungsfehler ihre Abwesenheit praktisch nicht bemerken, da während der Komprimierung die schwächsten Harmonischen abgeschnitten werden, die sich in der Nähe der meisten Töne befinden. stark: Töne.

Ein Verfahren wird verwendet, um die Nahspitzenwerte des Signals “Spitzen” (in Bezug auf das Volumen) durch einen Durchschnittswert zu ersetzen.

Es gibt ein Konzept als Bitrate: Dies ist ein Wert, der die Anzahl der übertragenen Informationsbits “Einheiten” während eines Zeitraums, normalerweise einer Sekunde, kennzeichnet.
Je höher die Bitrate, desto besser sind die Audiodetails, solange die ursprünglichen, nicht komprimierten Audiodaten von hoher Qualität sind.

Wie Sie sich vorstellen können, bestehen digitale Formate aus bestimmten Codesequenzen, dh aus den Sequenzen 0 und 1.
Um Platz zu sparen, werden häufigen Verknüpfungen innerhalb einer Datei eindeutige Bezeichner zugewiesen, die lange Sequenzen ersetzen.

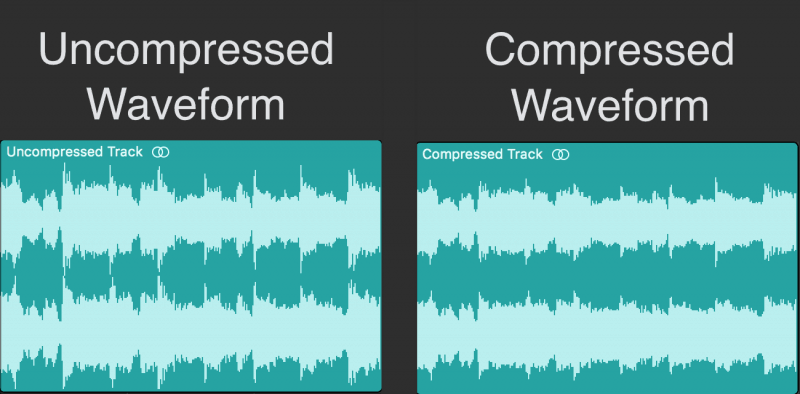
Dank dieser komplexen Einflüsse ist es möglich, das ursprüngliche Audiosignal mit Qualitätsverlust in eines der gängigen Formate zu komprimieren – das MP3-Format.

Verschiedene Experimente wurden viele Male durchgeführt, um zu zeigen, wie signifikant die Unterschiede vor und nach der Komprimierung in mp3 sind. Wie Tests gezeigt haben, waren Unterschiede, einige ähnliche Momente nicht immer möglich, schnell und zu unterscheiden, selbst wenn sie auf Geräten mit höherer Wiedergabetreue reproduziert wurden.

Für diejenigen, die noch nie die Möglichkeit hatten, die ursprüngliche und komprimierte Audioaufnahme direkt zu vergleichen, wird es in den meisten Fällen einige Zeit dauern oder sogar offensichtliche Unterschiede feststellen.

Free Download Mp4Gain
picture

Verbesserte Effizienz digitaler Audiodatenkomprimierungsalgorithmen.

Verbesserte Effizienz digitaler Audiodatenkomprimierungsalgorithmen.

audio compression

Die Relevanz der Arbeit. Verfahren zum Codieren von Audiosignalen hoher Qualität (HS) sind in den letzten zehn Jahren im Bereich Rundfunk, digitale Tonaufzeichnung sowie Heim-Audio- und -Videogeräte sehr weit verbreitet. Es gibt sogar eine schnell wachsende neue Klasse von Unterhaltungselektronik: tragbare MP3-Player.

Audio Compression:

Es werden digitale Fernseh- und Radioübertragungsnetze entwickelt, die den Verbrauchern qualitativ hochwertige Bilder und Töne mit einem breiten Versorgungsbereich bieten. Die Popularität von Radio- und Fernsehsendungen über das Internet und Mobilfunknetze nimmt zu. All diese technologischen Innovationen sind dank der Verwendung hocheffizienter digitaler Video- und Audiodatenkomprimierungsalgorithmen wie MPEG-1 ISO / IEC 11172, MPEG-2 TSO / IEC wirtschaftlich rentabel und in einigen Fällen sogar technisch möglich geworden 13818, MPEG-4 ISO / IEC FCD 14496, ATSC Dolby AC-3. Gleichzeitig ist es aufgrund der wirtschaftlichen Vorteile der Verwendung dieser Algorithmen, die es ermöglichen, die Bandbreitenanforderungen der Übertragungskanäle oder die Kapazität der Informationsträger um eine Größenordnung zu verringern, mit einer gewissen Verringerung der zu kompensieren Tonqualität. In der Zeit der Dominanz digitaler Audio-CDs haben die Verbraucher von allen Tonwiedergabegeräten eine hohe Klangqualität gefordert. Die Bemühungen der Algorithmusentwickler zur Codierung von Audiosignalen waren immer darauf ausgerichtet, sicherzustellen, dass die Qualität des decodierten Audiomaterials nicht schlechter ist als die einer CD. Die Klangqualität ist häufig der entscheidende Faktor für den wirtschaftlichen Erfolg digitaler Rundfunkdienste oder digitaler Tonverteilungsdienste wie iTunes. Des Weiteren,

Es ist offensichtlich, dass das Problem der Verbesserung der Qualität der Audiocodierung heute eines der Hauptprobleme für die Tonaufzeichnungsindustrie, die Audioübertragungsindustrie und die Hersteller verschiedener Multimedia-Systeme ist.

Das Grundprinzip des Betriebs hocheffizienter Audiokodierungssysteme besteht darin, die Eigenschaften des menschlichen Hörsystems zu nutzen, hauptsächlich das Phänomen der Maskierung. Das Phänomen der psychoakustischen Maskierung beruht auf der biophysikalischen und neuronalen Verarbeitung von Schallsignalen durch das menschliche Hörsystem [173]. Gleichzeitig beeinflusst ein Teil der Schallinformationen die akustische Wahrnehmung des Schallsignals nicht, da Komponenten mit größerer Intensität vorhanden sind. Daher bilden die stärksten Komponenten des Audiosignals die sogenannten Maskierungsschwellen. Schallinformationen mit einem Signalenergieniveau unterhalb der Maskierungsschwelle werden vom auditorischen System nicht wahrgenommen. Bei der herkömmlichen digitalen Darstellung von Audiosignalen unter Verwendung von Pulscodemodulation (PCM) werden zeitabgetastete Abtastwerte des ursprünglichen Signals unter Verwendung einer bestimmten Anzahl von Bits im Codewort dargestellt. Die endliche Genauigkeit der Momentanwerte eines kontinuierlichen analogen Signals führt zu einem Fehler im Signal, dem sogenannten Quantisierungsrauschen. Die Idee, Audiosignale unter Beseitigung der psychoakustischen Redundanz zu codieren, besteht darin, die psychoakustische Analyse und den Quantisierungsmechanismus von Audiosignalen zu kombinieren [112]. In diesem Fall wird das digital codierte Signal so nahe wie möglich an der Zeit-Frequenz-Auflösung des menschlichen Hörsystems in eine Zeit-Frequenz-Darstellung umgewandelt. Die psychoakustische Analyse bestimmt die Maskierungsschwellen an jedem Punkt in der Zeit-Frequenz-Darstellung des codierten Signals, und der Quantisierer quantisiert das Signal mit der minimal möglichen Anzahl von Bits pro Abtastung neu, wobei das zunehmende Quantisierungsrauschen auftritt immer noch unter den Maskierungsschwellen. Somit kann eine kompakte Darstellung von Audiosignalen ohne subjektive Verschlechterung der Klangqualität erreicht werden. Es ist offensichtlich, dass die Effizienz und Qualität solcher Systeme hauptsächlich von der Präzision der psychoakustischen Analyse abhängt. Eine kompakte Darstellung von Audiosignalen kann ohne subjektive Verschlechterung der Klangqualität erreicht werden. Es ist offensichtlich, dass die Effizienz und Qualität solcher Systeme hauptsächlich von der Präzision der psychoakustischen Analyse abhängt. Eine kompakte Darstellung von Audiosignalen kann ohne subjektive Verschlechterung der Klangqualität erreicht werden. Es ist offensichtlich, dass die Effizienz und Qualität solcher Systeme hauptsächlich von der Präzision der psychoakustischen Analyse abhängt.

Unterschiede zwischen analogem und digitalem Audio

Unterschiede zwischen analogem und digitalem Audio

Analog and Digita

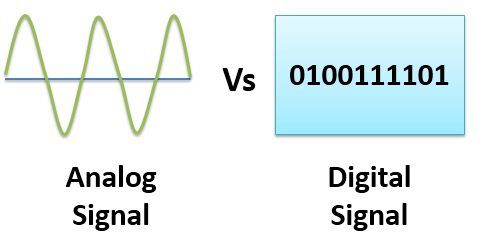
Sehr oft hören wir Definitionen wie “digitales” oder “diskretes” Signal. Wie unterscheidet es sich von “analog”?

Actual] Difference between Analog and Digital Signal with Examples -  ETechnoG

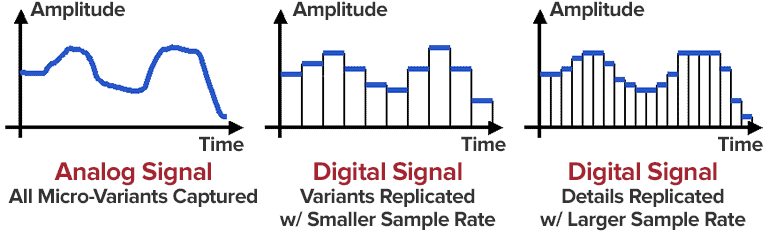
Der Unterschied besteht darin, dass das analoge Signal zeitlich kontinuierlich ist (blaue Linie), während das digitale Signal aus einem begrenzten Satz von Koordinaten (rote Punkte) besteht. Wenn alles auf Koordinaten reduziert ist, besteht jedes Segment eines analogen Signals aus einer unendlichen Anzahl von Koordinaten.

Bei einem digitalen Signal liegen die Koordinaten entlang der horizontalen Achse in regelmäßigen Abständen entsprechend der Abtastfrequenz. Im beliebten Audio-CD-Format sind dies 44.100 Punkte pro Sekunde. Vertikal entspricht die Genauigkeit der Koordinatenhöhe der Ziffernkapazität des digitalen Signals, für 8 Bit sind es 256 Ebenen, für 16 Bit = 65536 und für 24 Bit = 16777216 Ebenen. Je größer die Bittiefe (die Anzahl der Ebenen) ist, desto näher sind die vertikalen Koordinaten an der ursprünglichen Welle.

Analoge Quellen sind Kassetten und Vinyl. Digitale Quellen sind: CD-Audio, DVD-Audio, SA-CD (DSD) und Dateien in den Formaten WAVE und DSD (einschließlich der von APE, Flac, Mp3, Ogg usw. abgeleiteten).

Vor- und Nachteile des Analogsignals

Der Vorteil des analogen Signals besteht darin, dass wir in analoger Form Schall mit unseren Ohren wahrnehmen. Und obwohl unser auditorisches System den wahrgenommenen Schallstrom in digitale Form umwandelt und auf diese Weise an das Gehirn überträgt, haben Wissenschaft und Technologie noch nicht die Möglichkeit erreicht, Spieler und andere Schallquellen direkt auf diese Weise zu verbinden. Derzeit wird diese Forschung aktiv für Menschen mit Behinderungen durchgeführt, und wir genießen ausschließlich analogen Klang.

Der Nachteil eines analogen Signals ist die Fähigkeit, das Signal zu speichern, zu übertragen und zu replizieren. Bei der Aufnahme auf Band oder Vinyl hängt die Qualität des Signals von den Eigenschaften des Bandes oder Vinyls ab. Mit der Zeit wird das Band entmagnetisiert und die Qualität des aufgezeichneten Signals verschlechtert sich. Jeder Lesevorgang zerstört das Medium allmählich und das Umschreiben führt zu einer zusätzlichen Verzerrung, bei der das nächste Medium (Band oder Vinyl), Geräte zum Lesen, Aufzeichnen und Übertragen eines Signals, zusätzliche Abweichungen hinzufügt.

Das Erstellen einer Kopie eines analogen Signals ist wie das Aufnehmen eines anderen Fotos zum Kopieren eines Fotos.

Vor- und Nachteile eines digitalen Signals

Zu den Vorteilen eines digitalen Signals gehört die Präzision beim Kopieren und Übertragen eines Audiostreams, bei dem sich das Original nicht von der Kopie unterscheidet.

Der Hauptnachteil kann in Betracht gezogen werden, dass das digitale Signal eine Zwischenstufe ist und die Genauigkeit des endgültigen analogen Signals davon abhängt, wie detailliert und genau die Koordinaten der Schallwelle sind. Es ist ziemlich logisch, dass die Welle umso präziser ist, je mehr Punkte vorhanden sind und je genauer die Koordinaten sind. Es besteht jedoch immer noch kein Konsens darüber, wie viele Koordinaten und Datengenauigkeit ausreichen, um zu sagen, dass die digitale Darstellung des Signals ausreicht, um das analoge Signal genau zu rekonstruieren, das von unseren Ohren nicht vom Original unterschieden werden kann.

In Bezug auf das Datenvolumen beträgt die Kapazität einer herkömmlichen analogen Audiokassette nur 700-1,1 MB, während eine normale CD 700 MB beträgt. Dies gibt einen Hinweis auf den Bedarf an Medien mit hoher Kapazität. Dies führt zu einem separaten Kompromisskrieg mit unterschiedlichen Anforderungen an die Anzahl der Beschreibungspunkte und an die Genauigkeit der Koordinaten.

Heute wird es als ausreichend angesehen, eine Schallwelle mit einer Abtastfrequenz von 44,1 kHz und einer Bittiefe von 16 Bit darzustellen. Mit einer Abtastfrequenz von 44,1 kHz können Sie bis zu 22 kHz abrufen. Wie psychoakustische Studien zeigen, ist eine weitere Erhöhung der Abtastrate unauffällig, eine Erhöhung der Bittiefe bietet jedoch eine subjektive Verbesserung.

Wie DACs die Welle aufbauen

Ein DAC ist ein Digital-Analog-Wandler, der digitalen Ton in analogen umwandelt. Wir werden einen kurzen Blick auf die Grundlagen werfen. Wenn die Kommentare Interesse daran zeigen, verschiedene Punkte genauer zu betrachten, wird ein separates Material veröffentlicht.

Multibit-DAC

Am häufigsten wird die Welle in Form von Schritten dargestellt, was auf die Architektur der ersten Generation von R-2R-Mehrbit-DACs zurückzuführen ist, die ähnlich wie ein Relaisschalter funktionieren.

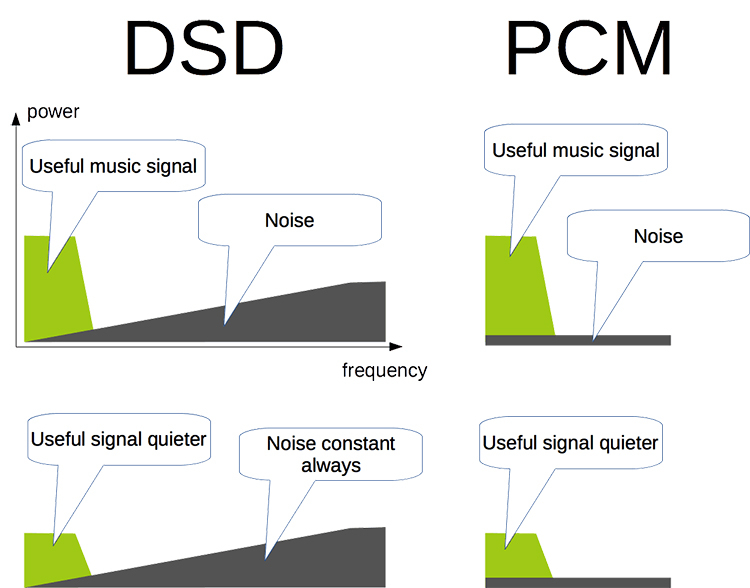
Digitaler Sound: DSD vs PCM

Digitaler Sound: DSD vs PCM

DSD vs. PCM: Myth vs. Truth | Audiofiles

Digitaler Sound. Wie viele Mythen drehen sich um diesen Satz. Wie viele Streitigkeiten sind zwischen Liebhabern von Komfort und digitaler Qualität und Befürwortern von “Live Airy” -Vinyl-Sound multipliziert mit “Warm Tube” -Sound aufgetreten? Darüber hinaus gibt es unter Liebhabern von “Zahlen” viele Kontroversen: Ist 16×44.1 genug oder ist 24×192 notwendig? Was ist besser: Multibit oder Delta Sigma? CDDA oder SACD? PCM oder DSD? In diesem Artikel werde ich versuchen, die Grundlagen des digitalen Klangs in einfacher Sprache zu erläutern und den Vergleich zweier Arten der Codierung eines analogen mit einem digitalen Signal genauer zu erläutern: DSD und PCM.

DSD Vs PCM - Real Competitors? | Headfonics Audio Reviews

Beantworten wir zunächst die Frage, was digitaler Sound ist. Wie unterscheidet es sich von analog? Kurz gesagt, mathematisch gesehen ist ein analoges Audiosignal eine kontinuierliche Funktion, ein digitales Audiosignal eine diskrete Funktion. Was bedeutet das?

Analogsignal

Wenn Sie in Ihrer Vorstellung ein Diagramm einer Sinuskurve zeichnen (so wird eine Schallwelle am häufigsten dargestellt): Unabhängig davon, wie wir sie vergrößern und versuchen, alle Details zu erkennen, sehen wir immer eine glatte, glatte Linie – das ist ein analoges Audiosignal (Abb. 1).

analog Analog (Aufnahme) Sound hat viele Parameter, mit denen die Qualität bewertet werden kann. Betrachten Sie die drei wichtigsten: Frequenzbereich, Dynamikbereich, Verzerrung.

Frequenzbereich – eine Reihe von Frequenzen, die im Ton enthalten sind. Es ist allgemein anerkannt, dass der Frequenzbereich des menschlichen Gehörs 20 … 20.000 Hz beträgt (manchmal werden 16 bis 22.000 Hz angezeigt). Der Frequenzbereich der Musik selbst ist für die Qualitätsbewertung nicht von Interesse (zum Beispiel ist der Frequenzbereich derselben abhebenden Ebene sehr breit und der Gesangsteil des Tenors ist viel enger). Ein qualitativer Parameter beispielsweise eines Kopfhörers ist der potentielle Frequenzbereich und wird unter Verwendung der Amplitudenfrequenzkennlinie (AFC) geschätzt. Der ideale Frequenzgang, eine gerade Linie über den gesamten Bereich der Hörfrequenzen, bedeutet, dass die Schallquelle keine einzelnen Frequenzen verstärkt oder dämpft, was bedeutet, dass der extrahierte Schall mit dem Original übereinstimmt.

Der Dynamikbereich (DD) ist der Unterschied zwischen dem niedrigsten und dem höchsten Klang. Die Lautstärke wird in Dezibel (dB) gemessen. Es ist allgemein anerkannt, dass die maximale Lautstärke, die eine Person nicht verletzt, 130 dB beträgt, das Geräusch eines Flugzeugs abhebt und die minimale hörbare Lautstärke 5 … 10 dB dem Rascheln der Blätter entspricht schwache Windverhältnisse. Natürlich ist es unmöglich, das Rascheln der Blätter vor dem Hintergrund eines abfliegenden Flugzeugs zu unterscheiden, und das Hören von Musik mit einem Pegel von 130 dB ist äußerst unangenehm. Daher wird allgemein angenommen, dass eine komfortable DD zum Musikhören 80 … 100 dB beträgt.

Die Verzerrung ist nichts anderes als eine Abweichung des Signals vom Original.