Verbesserte Effizienz digitaler Audiodatenkomprimierungsalgorithmen.


Free Download Mp4Gain
picture

Verbesserte Effizienz digitaler Audiodatenkomprimierungsalgorithmen.

audio compression

Die Relevanz der Arbeit. Verfahren zum Codieren von Audiosignalen hoher Qualität (HS) sind in den letzten zehn Jahren im Bereich Rundfunk, digitale Tonaufzeichnung sowie Heim-Audio- und -Videogeräte sehr weit verbreitet. Es gibt sogar eine schnell wachsende neue Klasse von Unterhaltungselektronik: tragbare MP3-Player.
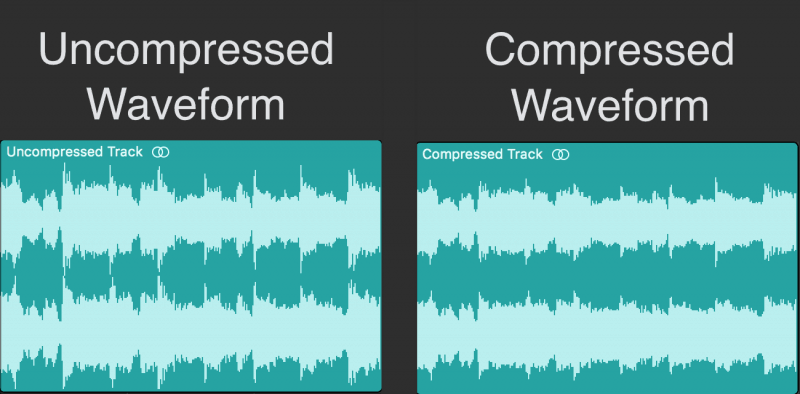
Audio Compression:

Es werden digitale Fernseh- und Radioübertragungsnetze entwickelt, die den Verbrauchern qualitativ hochwertige Bilder und Töne mit einem breiten Versorgungsbereich bieten. Die Popularität von Radio- und Fernsehsendungen über das Internet und Mobilfunknetze nimmt zu. All diese technologischen Innovationen sind dank der Verwendung hocheffizienter digitaler Video- und Audiodatenkomprimierungsalgorithmen wie MPEG-1 ISO / IEC 11172, MPEG-2 TSO / IEC wirtschaftlich rentabel und in einigen Fällen sogar technisch möglich geworden 13818, MPEG-4 ISO / IEC FCD 14496, ATSC Dolby AC-3. Gleichzeitig ist es aufgrund der wirtschaftlichen Vorteile der Verwendung dieser Algorithmen, die es ermöglichen, die Bandbreitenanforderungen der Übertragungskanäle oder die Kapazität der Informationsträger um eine Größenordnung zu verringern, mit einer gewissen Verringerung der zu kompensieren Tonqualität. In der Zeit der Dominanz digitaler Audio-CDs haben die Verbraucher von allen Tonwiedergabegeräten eine hohe Klangqualität gefordert. Die Bemühungen der Algorithmusentwickler zur Codierung von Audiosignalen waren immer darauf ausgerichtet, sicherzustellen, dass die Qualität des decodierten Audiomaterials nicht schlechter ist als die einer CD. Die Klangqualität ist häufig der entscheidende Faktor für den wirtschaftlichen Erfolg digitaler Rundfunkdienste oder digitaler Tonverteilungsdienste wie iTunes. Des Weiteren,

Es ist offensichtlich, dass das Problem der Verbesserung der Qualität der Audiocodierung heute eines der Hauptprobleme für die Tonaufzeichnungsindustrie, die Audioübertragungsindustrie und die Hersteller verschiedener Multimedia-Systeme ist.

Das Grundprinzip des Betriebs hocheffizienter Audiokodierungssysteme besteht darin, die Eigenschaften des menschlichen Hörsystems zu nutzen, hauptsächlich das Phänomen der Maskierung. Das Phänomen der psychoakustischen Maskierung beruht auf der biophysikalischen und neuronalen Verarbeitung von Schallsignalen durch das menschliche Hörsystem [173]. Gleichzeitig beeinflusst ein Teil der Schallinformationen die akustische Wahrnehmung des Schallsignals nicht, da Komponenten mit größerer Intensität vorhanden sind. Daher bilden die stärksten Komponenten des Audiosignals die sogenannten Maskierungsschwellen. Schallinformationen mit einem Signalenergieniveau unterhalb der Maskierungsschwelle werden vom auditorischen System nicht wahrgenommen. Bei der herkömmlichen digitalen Darstellung von Audiosignalen unter Verwendung von Pulscodemodulation (PCM) werden zeitabgetastete Abtastwerte des ursprünglichen Signals unter Verwendung einer bestimmten Anzahl von Bits im Codewort dargestellt. Die endliche Genauigkeit der Momentanwerte eines kontinuierlichen analogen Signals führt zu einem Fehler im Signal, dem sogenannten Quantisierungsrauschen. Die Idee, Audiosignale unter Beseitigung der psychoakustischen Redundanz zu codieren, besteht darin, die psychoakustische Analyse und den Quantisierungsmechanismus von Audiosignalen zu kombinieren [112]. In diesem Fall wird das digital codierte Signal so nahe wie möglich an der Zeit-Frequenz-Auflösung des menschlichen Hörsystems in eine Zeit-Frequenz-Darstellung umgewandelt. Die psychoakustische Analyse bestimmt die Maskierungsschwellen an jedem Punkt in der Zeit-Frequenz-Darstellung des codierten Signals, und der Quantisierer quantisiert das Signal mit der minimal möglichen Anzahl von Bits pro Abtastung neu, wobei das zunehmende Quantisierungsrauschen auftritt immer noch unter den Maskierungsschwellen. Somit kann eine kompakte Darstellung von Audiosignalen ohne subjektive Verschlechterung der Klangqualität erreicht werden. Es ist offensichtlich, dass die Effizienz und Qualität solcher Systeme hauptsächlich von der Präzision der psychoakustischen Analyse abhängt. Eine kompakte Darstellung von Audiosignalen kann ohne subjektive Verschlechterung der Klangqualität erreicht werden. Es ist offensichtlich, dass die Effizienz und Qualität solcher Systeme hauptsächlich von der Präzision der psychoakustischen Analyse abhängt. Eine kompakte Darstellung von Audiosignalen kann ohne subjektive Verschlechterung der Klangqualität erreicht werden. Es ist offensichtlich, dass die Effizienz und Qualität solcher Systeme hauptsächlich von der Präzision der psychoakustischen Analyse abhängt.


Free Download Mp4Gain
picture

Audiokomprimierung

Audiokomprimierung

Audio Compression

Gut etablierte Datenkomprimierungsmethoden wie RLE, Statistik- und Wörterbuchmethoden können verwendet werden, um verlustfreie Audiodateien zu komprimieren. Das Ergebnis hängt jedoch stark von den spezifischen Audiodaten ab. Einige Sounds werden mit RLE gut komprimiert, mit statistischen Algorithmen jedoch schlecht. Die statistische Komprimierung ist besser für andere Sounds geeignet, bei einem Wörterbuchansatz kann jedoch eine Erweiterung auftreten. Hier finden Sie eine kurze Übersicht über die Wirksamkeit dieser drei Methoden zum Komprimieren von Audiodateien.

Audio Compression

RLE funktioniert gut mit Sounds, die lange Serien sich wiederholender Sound Chunks enthalten – Samples. Bei 8-Bit-Abtastung kann dies ziemlich häufig vorkommen. Denken Sie daran, dass die Spannungsdifferenz zwischen zwei 8-Bit-Abtastwerten n und n – 1 ungefähr 4 mV beträgt. Einige Sekunden homogener Musik, bei der sich die Schallwelle um weniger als 4 mV ändert, erzeugen eine Folge von Tausenden identischer Samples. Bei der 16-Bit-Abtastung sind offensichtlich lange Wiederholungen weniger häufig und daher ist der RLE-Algorithmus weniger effizient.

Statistische Methoden weisen Audio-Samples Codes mit variabler Länge entsprechend ihrer Häufigkeit zu. Bei 8-Bit-Sampling gibt es nur 256 verschiedene Samples, sodass die Samples gleichmäßig in einer großen Audiodatei verteilt werden können. Eine Datei dieses Typs kann mit der Huffman-Methode nicht gut komprimiert werden. Bei 16-Bit-Sampling sind mehr als 65.000 Soundbits zulässig. In diesem Fall sind einige Proben möglicherweise häufiger und andere weniger häufig. Mit einem starken Wahrscheinlichkeitsversatz können mit Hilfe der arithmetischen Codierung gute Ergebnisse erzielt werden.

Wörterbuchbasierte Methoden setzen voraus, dass einige Phrasen häufig in der Datei vorkommen. Dies geschieht in einer Textdatei, in der einzelne Wörter oder Sequenzen davon viele Male wiederholt werden. Der Ton ist jedoch ein analoges Signal und die Werte der spezifisch erzeugten Abtastwerte hängen stark vom Betrieb des ADC ab. Beispielsweise wird bei einer 8-Bit-Abtastung eine 8-mV-Wellenform zu einer numerischen Abtastung von 2, aber eine nahegelegene Welle von beispielsweise 7,6 mV oder 8,5 mV kann in eine andere Zahl umgewandelt werden. Aus diesem Grund können sich Sprachausschnitte, die überlappende Phrasen enthalten und für uns gleich klingen, beim Digitalisieren geringfügig unterscheiden. Dann geben sie das Wörterbuch in Form verschiedener Phrasen ein, die nicht die erwartete Komprimierung ergeben. Daher sind Wörterbuchmethoden für die Audiokomprimierung nicht sehr geeignet.

Sie können bessere Ergebnisse bei verlustbehafteter Audiokomprimierung erzielen, indem Sie Komprimierungstechniken entwickeln, die die Wahrnehmung von Klang berücksichtigen. Sie entfernen den Teil der Daten, der für das Publikum unhörbar bleibt. Es ist wie das Komprimieren von Bildern und das Verwerfen von Informationen, die für das Auge unsichtbar sind. In beiden Fällen gehen wir davon aus, dass die Originalinformationen (Bild oder Ton) analog sind, dh ein Teil der Informationen ist bereits während der Quantisierung und Digitalisierung verloren gegangen. Wenn Sie vorsichtig etwas mehr Verlust zulassen, wird die Qualität der unkomprimierten Klangwiedergabe nicht beeinträchtigt, was sich nicht wesentlich vom Original unterscheidet. Wir werden kurz zwei Ansätze beschreiben, die als Stilleunterdrückung und Verdichtung bezeichnet werden.

Die Idee hinter der Unterdrückung der Stille besteht darin, kleine Proben so zu behandeln, als wären sie nicht da (dh sie sind Null). Eine solche Nullung erzeugt eine Reihe von Nullen, so dass das Verfahren zum Unterdrücken von Pausen tatsächlich eine Variante von RLE ist, die an die Audiokomprimierung angepasst ist. Diese Methode basiert auf der Besonderheit der Schallwahrnehmung, die aus der Toleranz des menschlichen Ohrs besteht, kaum hörbare Geräusche auszuschließen. Audiodateien mit langen, leisen Tonabschnitten werden mit der Stilleunterdrückungsmethode besser komprimiert als Dateien mit lauten Tönen. Diese Methode erfordert die Teilnahme des Benutzers, der die Parameter steuert, die die Lautstärkeschwelle für die Samples festlegen. Dies erfordert zwei weitere Parameter, die nicht unbedingt vom Benutzer gesteuert werden. Ein Parameter wird verwendet, um die kürzesten Sequenzen stiller Samples zu bestimmen, normalerweise 2 oder 3. Der zweite Parameter legt die kleinste Anzahl aufeinanderfolgender starker Samples fest, wenn Stille oder Pause auftritt. Zum Beispiel können 15 stille Samples von 2 starken und dann 13 stillen folgen,

Die Konsolidierung basiert auf der Eigenschaft, dass das Ohr Änderungen in der Amplitude leiser Töne besser unterscheidet als laute Töne. Ein typischer ADC für Computer-Soundkarten verwendet eine lineare Umwandlung, um die Spannung in eine numerische Form umzuwandeln. Wenn die Amplitude a zu n wird, wird die Amplitude 2 a zu 2 n.