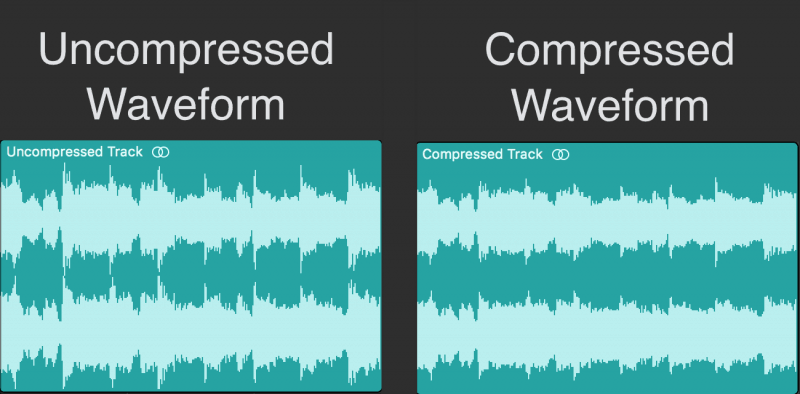
Verstehen Sie, was Audiokomprimierung ist

Ein Containerformat ist ein Datenformat, das andere codierte Daten “kapselt”. Es enthält häufig “Metainformationen” zu den codierten Daten oder bietet die Möglichkeit, mehrere separate Streams codierter Daten oder ähnliches zu speichern.

Die vom Codec erzeugte Codierung ist die eigentliche Essenz des Datenstroms.
Das häufigste Beispiel, an das ich denken kann, ist das Ogg / Vorbis-Format. Ogg ist das Containerformat und Vorbis ist die Codierung. Sie haben also eine Ogg-Datei und darin befinden sich diese kleinen Segmente, die codierte Daten enthalten. Jeder Block enthält einen Strom von Vorbis-codierten Daten und sonst nichts. Ein Würfel kann beispielsweise den Namen eines Künstlers und den Titel eines Songs enthalten.
Zurück zur Technologie:
Wenn Sie bereits verlustbehaftete Musik wie MP3 oder ogg / vorbis haben, nimmt die Konvertierung in ein verlustfreies Format nur (viel) Speicherplatz in Anspruch und verbessert die Audioqualität überhaupt nicht. Sie können keine Loyalität schaffen, wenn sie bereits verloren ist. Es sei denn, Sie schreiben eine Visual Basic-Benutzeroberfläche in einer beliebten TV-Show namens CSI, aber das ist Fantasie, nicht Realität.
Wenn Sie Musik in anderen verlustfreien Formaten haben und diese in FLAC konvertieren möchten, können Sie dies tun.
Seien Sie vorsichtig, wenn Sie den Begriff “WAV” verwenden. Wav muss nicht verlustfrei sein; Tatsächlich ist WAV nur ein Container für die verschiedenen möglichen Formate. In diesem Sinne ähnelt es AVI. Sie können verlustfreies WAV haben, wenn es sich nur um PCM-Rohdaten handelt, aber Sie können auch verlustbehaftete MPEG-1 Layer III-Daten in eine WAV-Datei einbetten.
Es ist möglich, Daten beim Konvertieren von einem verlustfreien Format in ein anderes zu verlieren, wenn Sie die Genauigkeit der Daten verringern. Wenn Sie beispielsweise einen vorzeichenlosen 16-Bit-PCM-Datenstrom mit 48000 Hz in 8-Bit-PCM-Daten mit 44100 Hz konvertieren, verlieren Sie auf zwei Arten an Genauigkeit: Samples werden von 48000 auf jeweils nur 44100 zusammengeführt. Zweitens (was zu Datenverlust führt), und die Daten müssen verschlüsselt werden, um die Informationen in nur 8 Bit anstatt in 16 Bit pro Abtastung zu passen, was die Qualität drastisch verschlechtert.
Jeder digitale Audiostream, selbst wenn er mit einem komprimierten Encoder (verlustbehaftet oder verlustfrei) codiert ist, verfügt über die folgenden Eigenschaften des Beispielformats, die wichtige Elemente sind, die die Eigenschaften des Streams beschreiben:
Ein Beispiel für Bitbreite und -tiefe, d. H. 8 Bit, 16 Bit usw. Bitbreiten und -tiefen unterscheiden sich geringfügig, und es gibt auch eine große Endian / Endian-Bytereihenfolge (die die Qualität nicht beeinflusst) und ein vorzeichenbehaftetes oder vorzeichenloses Vorzeichen (das ebenfalls keine Rolle spielt), das die Qualität beeinflusst, aber den Encoder / Decoder-Betrieb beeinflusst mit Daten). Der wichtigste Punkt, an den Sie sich erinnern sollten, ist “je mehr Bits desto besser”. 32-Bit ist also besser als 16-Bit usw.
Frequenz, auch als Abtastrate bekannt. Je mehr desto besser, denn pro Sekunde werden mehr „Samples“ abgespielt. Stellen Sie sich vor, Sie gleiten mit dem Finger über ein Kartenspiel und sehen, wie die Karten verschwimmen. Auf diese Weise entsteht im Wesentlichen digitaler Klang. Jedes Sample ist eine Karte. Wenn mehr Karten pro Sekunde fliegen, ist der Klang leiser. Zum Beispiel würden Sie wirklich bemerken, wenn Sie nur 5 Karten pro Sekunde umdrehen würden, aber alles wäre verschwommen, wenn Sie Tausende von Karten pro Sekunde umdrehen würden. Es ist also noch besser, weil es natürlicher und realitätsnaher ist, was analog und unendlich teilbar ist (bis zu Planck-Einheiten, aber dies ist umstritten und nicht thematisch).
Verlustfrei bedeutet einfach, dass Sie keine Daten verlieren, wenn Sie in der Ausgabe dasselbe oder ein besseres Beispielformat verwenden, das Sie in der Eingabe verwendet haben.
Wenn Sie also vom 16-Bit- zum 32-Bit-Beispielformat wechseln, gehen keine Daten verloren. Wenn Sie jedoch von 32 Bit auf 16 Bit wechseln, gehen Daten verloren.
Die Antwort auf Ihre Frage, ob die Verwendung von FLAC sinnvoll ist, hängt von den Originaldaten ab: Wenn Sie 64-Bit-WAV-Dateien haben, die ursprünglich in diesem Beispielformat mit 192.000 Hz (oder 192 kHz) aufgezeichnet wurden, und diese in das Format “konvertieren” Standard 16-Bit-FLAC mit 44,1 kHz, Sie verlieren eine Menge Daten. Wenn Ihre WAV-Datei jedoch 8-Bit mit 22100 Samples pro Sekunde ist und Sie sie in 16-Bit-FLAC mit 44100 Samples pro Sekunde konvertieren, verlieren Sie keine Daten. Sie können die Dateigröße sogar erhöhen, je nachdem, ob Sie eine verlustfreie Komprimierung oder ein kleineres Beispielformat erhalten.
Das Sample-Format wirkt sich auf den Speicherplatz aus, den die Datei belegt, sodass “größere” Bits und eine “schnellere” Samplerate mehr Speicherplatz beanspruchen.
Wenn es um praktische Überlegungen und menschliches Gehör geht, werden Sie es nicht bemerken, wenn Sie Originale von sehr hoher Qualität mit 44,1 kHz in 16-Bit-FLAC konvertieren. Sie werden jedoch keine Verbesserung bemerken, wenn Sie MP3 in FLAC konvertieren. Daher müssen Sie bewerten, in welchem Format Ihre Rohdaten vorliegen, bevor Sie entscheiden, was zu tun ist.