Audiodigitalisierung: So funktioniert es Teil 2


Free Download Mp4Gain
picture

Audiodigitalisierung: So funktioniert es Teil 2

Audio Digitization

Damit der Computer diese Zahlen versteht, übersetzen wir diese Zahlen in das binäre Zahlensystem. Der Einfachheit halber gehen wir davon aus, dass eine Zahl genau 1 Byte Speicherplatz belegt, aber in Wirklichkeit gilt: Je mehr Bytes der Zahl zugeordnet sind, desto genauer sind die Messung und die Klangqualität. Nach der Übersetzung erhalten wir:

Audio Digitization

00000101

00000111

00001010

…

11101011

Computer können diese Sequenz bereits verstehen und als Ton wiedergeben.

wie man jetzt Ton abspielt
• Verwenden Sie Lautsprecher oder Kopfhörer – alles, was „Luft drückt“ (dh Schallwellen erzeugt). In den Lautsprechern treten Luftvibrationen auf.
• Schalten Sie den Lautsprecher etwas ein. Je nach Stromstärke bewegt sich die Schwingspule des Lautsprechers unterschiedlich.
• Um diesen variablen Strom zu erhalten, ist ein spezieller Chip namens DAC, ein Digital-Analog-Wandler, erforderlich. Es nimmt eine Zahl als Eingabe und erzeugt einen Stream als Ausgabe. Alle Smartphones und Computer haben diese DACs.

Alle:

1. Der Prozessor sendet die Tondateinummern an den DAC.
2. Der DAC empfängt Zahlen und gibt basierend auf diesen Zahlen verschiedene Streams aus.
3. Der Strom wird an den Lautsprecher gesendet.
4. Der Lautsprecher beginnt, den Lautsprecherkegel aufgrund von Elektrizität zu bewegen.
5. Der Kegel beginnt, die Luft vor sich herzuschieben, wodurch Schallwellen entstehen.
6. Schallwellen erreichen unsere Ohren und wir nehmen sie als Schall wahr.

Was kommt als nächstes
Bei diesem Ansatz gibt es ein Problem: Die Datei ist zu groß, um bequem verwendet werden zu können. Stellen Sie sich vor: 44.000 Zahlen in einer Sekunde!

Um die Dateigröße zu reduzieren, schlagen sie zwei Lösungen vor: verlustbehaftete Komprimierung und verlustfreie Komprimierung. Im nächsten Artikel wird die verlustbehaftete und verlustfreie Komprimierung separat behandelt, obwohl sie viele Gemeinsamkeiten haben.


Free Download Mp4Gain
picture

Audio-Digitalisierung: So funktioniert es

Audio-Digitalisierung: So funktioniert es

Audio digitization

Wie kann man Sound ohne Seele in Nullen und Einsen übersetzen? . Werfen wir einen Blick auf vertraute Geräte: wie Computersound, Video, MP3s, Streaming und Streaming funktionieren, verschiedene Algorithmen und mehr.

Audio digitalization

ein bisschen Physik
Geräusche sind Schwingungen in der Luft. Wie Wellen im Wasser, in der Luft. Luftdruck dringt in das Ohr ein, das empfindliche Teile hat, die Vibrationen in der Luft subtil wahrnehmen können. Diese Schwingungen werden von Menschen als Geräusche wahrgenommen. Im Weltraum gibt es keinen Ton, weil es keine Luft gibt.

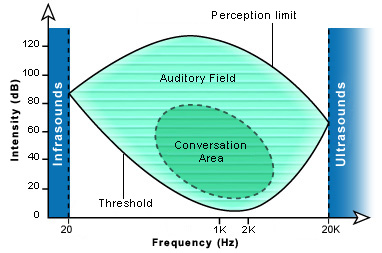
Frequenz. Je schneller die Vibration, desto schwächer der Ton, den wir wahrnehmen. Eine Person nimmt Schwingungen wahr, die zwischen 20 und 20.000 Schwingungen pro Sekunde liegen. Mit anderen Worten, dies wird als Schwingungsfrequenz bezeichnet: Hertz. Das heißt, der Bereich, den wir hören, reicht von 20 Hz bis 20 kHz.

Im Vergleich dazu hören Hunde Frequenzen von 40 Hz bis 60 kHz, sodass Menschen eine Hundepfeife nicht wahrnehmen, Hunde sie jedoch hören können. Der Ton einer Hundepfeife liegt nur im Bereich von 23-54 kHz.

Amplitude. Je stärker die Vibration, desto stärker der Ton und umgekehrt. Sie können sich dies als die Höhe der Wellen auf der Oberfläche des Teichs vorstellen: Es können kleine Wellen (weiche Geräusche) oder große, kraftvolle Wellen auftreten.
Teilen Sie den Ton in Segmente.

Lassen Sie uns nun Folgendes tun: Wir teilen den zweiten Teil in 4 Teile und finden den Betragswert für jeden Teil:

Wir messen den Zustand der quadratischen Welle in einer Sekunde. Dies wird als Probenahme bezeichnet.

Wir haben die Größe jedes der vier Punkte gemessen und relativ gesehen vier Zahlen erhalten: +30, -50, -50 und -60. Wenn wir Strom durchlassen und diese vier Spannungen an den Lautsprecher anlegen würden, könnten wir theoretisch denselben Klang reproduzieren. Aber es gibt mehrere Probleme:

• Da wir nur an vier Stellen messen, geht jede Schwingung verloren.
• Am Ende hatten wir einen sehr verzerrten Klang im Vergleich zum Original.

Sampling mit einer Rate von 4 ist zu wenig für den Sound. Um zumindest verständliche Sprache zu erhalten, muss eine Sekunde in 8.000 Segmente unterteilt werden, bei Musik reichen meist 41.000 Segmente aus.

Lassen Sie uns die Abtastrate erhöhen: Schneiden Sie den Sound in der gleichen Zeiteinheit in kleinere Teile:

Die Messungen sind jetzt genauer und der resultierende Klang ist natürlicher.

in Zahl umwandeln
Nachdem wir den Ton in kleine Segmente unterteilt und den Amplitudenwert jedes Segments gemessen haben, können wir ihn in Tabellenform aufzeichnen:

Zeit ⠀⠀⠀⠀⠀ Amplitude

0,01 Sekunden. ⠀⠀⠀⠀ 5

0,02 Sekunden. ⠀⠀⠀⠀ 7

0,03 Sekunden. ⠀⠀⠀⠀ 10

Wenn wir den ganzen Ton in gleiche Segmente teilen, dann kann die Zeit nicht geschrieben werden, da wir wissen, wie sie sich ändert, reicht es, den Amplitudenwert auf eine Linie zu schreiben:

5 7 10 … −21

Wie bringt man eine Maschine dazu, wie ein Mensch zu klingen? Teil 2
Wie bringt man eine Maschine dazu, wie ein Mensch zu klingen? Teil 2

Human perception

Neuronale Netze (NNs) sind sehr gut darin, abstrakte Darstellungen von Daten zu extrahieren und sind daher ideal, um kognitive Eigenschaften in Geräuschen zu erkennen. Um ein System für diesen Zweck zu bauen, wollen wir zunächst untersuchen, wie Schall im menschlichen Hörorgan repräsentiert wird, was wir verwenden können, um neuronale Netze zu motivieren, Repräsentationen von Klangbedeutungen zu verarbeiten.

Human perception

cochleäre Darstellung
Das menschliche Hören beginnt mit dem äußeren Ohr, das zunächst aus dem Vorhof besteht. Der Ohrhörer fungiert als eine Form der spektralen Vorverarbeitung des Klangs, bei der der Eingangsschall basierend auf seiner Ausrichtung relativ zum Zuhörer modifiziert wird. Der Schall tritt dann durch eine Öffnung im Atrium in den Gehörgang ein und modifiziert anschließend die spektralen Eigenschaften des eingehenden Schalls, indem er diese verstärkte Frequenz (im Bereich von ~ 1-6 kHz) in Resonanz bringt [1].

Wie man eine Maschine dazu bringt, wie ein Mensch zuzuhören

Darstellung des menschlichen Gehörs

Wenn die Schallwellen das Ende des Gehörgangs erreichen, erregen sie das Trommelfell, an dem die Gehörknöchelchen (die kleinsten Knochen im menschlichen Körper) befestigt sind. Diese Knochen übertragen den Druck vom Gehörgang auf die mit Flüssigkeit gefüllte Cochlea des Innenohrs [1]. Die Cochlea spielt eine wichtige Rolle bei der Lenkung der Darstellung von Klangbedeutungen für neuronale Netze (NN), da dies das Organ ist, das für die Übersetzung akustischer Schwingungen in menschliche neuronale Aktivität verantwortlich ist.

Es ist ein gewickelter Schlauch, der entlang seiner Länge durch zwei Membranen getrennt ist, die Reisner-Membran und die Basalmembran. In der gesamten Cochlea gibt es eine Reihe von etwa 3.500 inneren Haarzellen [1]. Wenn Druck in die Cochlea eindringt, drücken sich ihre beiden Membranen zusammen. Die Basalmembran ist an der Basis schmaler und steifer, an ihrer Spitze jedoch breiter und lockerer, wodurch die Reaktion bei einer bestimmten Frequenz an jeder Stelle entlang ihrer Länge stärker wird.

Einfach ausgedrückt kann man sich die Basilarmembran als einen Satz kontinuierlicher Bandpassfilter in Membranlänge vorstellen, die Töne in ihre Spektralkomponenten zerlegen.

Wie man eine Maschine dazu bringt, wie ein Mensch zuzuhören

Abbildung der menschlichen Cochlea

Dies ist der grundlegendste Mechanismus, durch den Menschen Schalldruck in neuronale Aktivität umwandeln. Daher ist davon auszugehen, dass die spektrale Darstellung von Schall vorteilhaft ist, wenn Modelle der Schallwahrnehmung mit künstlicher Intelligenz erstellt werden. Da der Frequenzgang in der Basilarmembran exponentiell variiert, ist eine logarithmische Darstellung der Frequenz wahrscheinlich am effizientesten. Eine solche Frequenzdarstellung kann unter Verwendung einer Filterbank von Gammatönen erzeugt werden. Diese Filter werden üblicherweise bei der Spektralfiltermodellierung des Hörsystems verwendet, da sie die Impulsantwort menschlicher Hörfilter abschätzen können, die von Hörnervenfasern als Reaktion auf eine Art von weißem Rauschen entstehen, das als “Revcor” -Funktion bezeichnet wird.

Wie man eine Maschine dazu bringt, wie ein Mensch zuzuhören

Vergleich der vereinfachten menschlichen Profiltransduktion und der digitalisierten Profiltransduktion

Die Cochlea hat etwa 3.500 innere Haarzellen, und Menschen können Lücken in Geräuschen von 2 bis 5 ms Länge erkennen, so dass die spektrale Zerlegung mit 3.500 Gammatonfiltern, die in 2-ms-Fenster unterteilt sind, wie eine Maschine erscheint, um ein dem Menschen ähnliches Spektrum zu erreichen bester darzustellender Parameter. In realen Szenarien glaube ich jedoch, dass eine geringere Spektralzerlegung bei den meisten Analyse- und Verarbeitungsaufgaben auch wünschenswerte Ergebnisse erzielt, während sie rechnerisch besser machbar ist.

Verschiedene Softwarebibliotheken für die Höranalyse sind online verfügbar. Ein wichtiges Beispiel ist das Gammatone Filterbank Toolkit von Jason Heeris, das nicht nur abstimmbare Filter bereitstellt, sondern auch Werkzeuge für die Spektralanalyse von Tonsignalen unter Verwendung von Gammatone-Filtern bereitstellt.

neuronale Kodierung
Wenn sich die neurale Aktivität von der Cochlea zum Hörnerv und den aufsteigenden Hörbahnen bewegt, finden mehrere Prozesse in den Kernen des Hirnstamms statt, bevor sie den Hörkortex erreichen.

Diese Verfahren bilden einen neuronalen Code, der die Interaktion zwischen dem Reiz und der Wahrnehmung darstellt. Viel mehr über die spezifischen Jobs innerhalb dieser Kernel sind noch Vermutungen oder unbekannt, also werde ich behandeln, wie sie auf hohem Niveau funktionieren.