Wie bringt man eine Maschine dazu, wie ein Mensch zu klingen? Teil 2


Free Download Mp4Gain
picture

Wie bringt man eine Maschine dazu, wie ein Mensch zu klingen? Teil 2
Human perception

Neuronale Netze (NNs) sind sehr gut darin, abstrakte Darstellungen von Daten zu extrahieren und sind daher ideal, um kognitive Eigenschaften in Geräuschen zu erkennen. Um ein System für diesen Zweck zu bauen, wollen wir zunächst untersuchen, wie Schall im menschlichen Hörorgan repräsentiert wird, was wir verwenden können, um neuronale Netze zu motivieren, Repräsentationen von Klangbedeutungen zu verarbeiten.

Human perception

cochleäre Darstellung
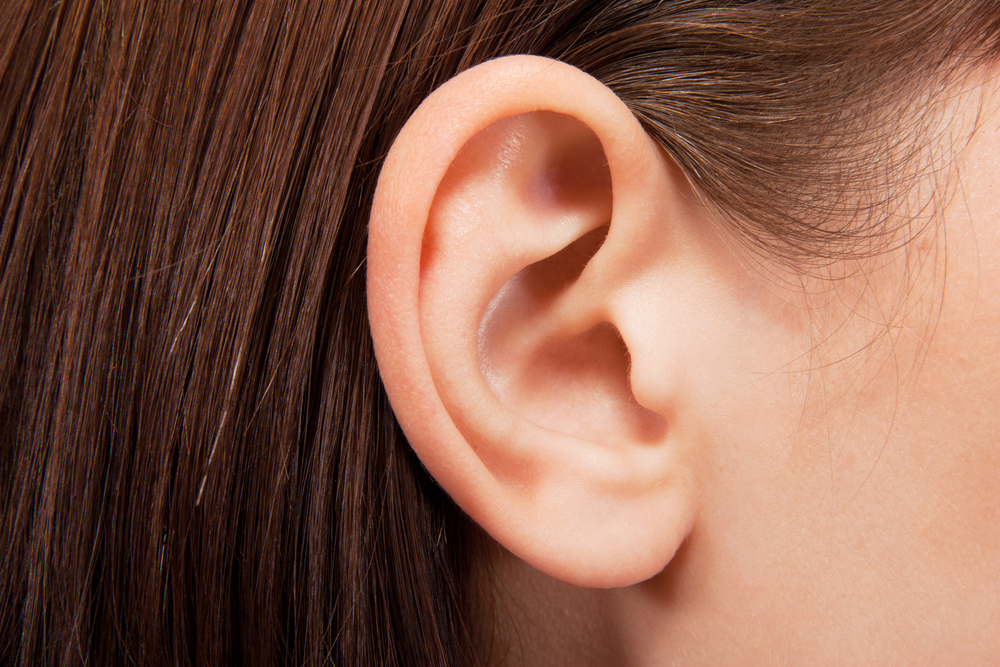
Das menschliche Hören beginnt mit dem äußeren Ohr, das zunächst aus dem Vorhof besteht. Der Ohrhörer fungiert als eine Form der spektralen Vorverarbeitung des Klangs, bei der der Eingangsschall basierend auf seiner Ausrichtung relativ zum Zuhörer modifiziert wird. Der Schall tritt dann durch eine Öffnung im Atrium in den Gehörgang ein und modifiziert anschließend die spektralen Eigenschaften des eingehenden Schalls, indem er diese verstärkte Frequenz (im Bereich von ~ 1-6 kHz) in Resonanz bringt [1].

Wie man eine Maschine dazu bringt, wie ein Mensch zuzuhören

Darstellung des menschlichen Gehörs

Wenn die Schallwellen das Ende des Gehörgangs erreichen, erregen sie das Trommelfell, an dem die Gehörknöchelchen (die kleinsten Knochen im menschlichen Körper) befestigt sind. Diese Knochen übertragen den Druck vom Gehörgang auf die mit Flüssigkeit gefüllte Cochlea des Innenohrs [1]. Die Cochlea spielt eine wichtige Rolle bei der Lenkung der Darstellung von Klangbedeutungen für neuronale Netze (NN), da dies das Organ ist, das für die Übersetzung akustischer Schwingungen in menschliche neuronale Aktivität verantwortlich ist.

Es ist ein gewickelter Schlauch, der entlang seiner Länge durch zwei Membranen getrennt ist, die Reisner-Membran und die Basalmembran. In der gesamten Cochlea gibt es eine Reihe von etwa 3.500 inneren Haarzellen [1]. Wenn Druck in die Cochlea eindringt, drücken sich ihre beiden Membranen zusammen. Die Basalmembran ist an der Basis schmaler und steifer, an ihrer Spitze jedoch breiter und lockerer, wodurch die Reaktion bei einer bestimmten Frequenz an jeder Stelle entlang ihrer Länge stärker wird.

Einfach ausgedrückt kann man sich die Basilarmembran als einen Satz kontinuierlicher Bandpassfilter in Membranlänge vorstellen, die Töne in ihre Spektralkomponenten zerlegen.

Wie man eine Maschine dazu bringt, wie ein Mensch zuzuhören

Abbildung der menschlichen Cochlea

Dies ist der grundlegendste Mechanismus, durch den Menschen Schalldruck in neuronale Aktivität umwandeln. Daher ist davon auszugehen, dass die spektrale Darstellung von Schall vorteilhaft ist, wenn Modelle der Schallwahrnehmung mit künstlicher Intelligenz erstellt werden. Da der Frequenzgang in der Basilarmembran exponentiell variiert, ist eine logarithmische Darstellung der Frequenz wahrscheinlich am effizientesten. Eine solche Frequenzdarstellung kann unter Verwendung einer Filterbank von Gammatönen erzeugt werden. Diese Filter werden üblicherweise bei der Spektralfiltermodellierung des Hörsystems verwendet, da sie die Impulsantwort menschlicher Hörfilter abschätzen können, die von Hörnervenfasern als Reaktion auf eine Art von weißem Rauschen entstehen, das als “Revcor” -Funktion bezeichnet wird.

Wie man eine Maschine dazu bringt, wie ein Mensch zuzuhören

Vergleich der vereinfachten menschlichen Profiltransduktion und der digitalisierten Profiltransduktion

Die Cochlea hat etwa 3.500 innere Haarzellen, und Menschen können Lücken in Geräuschen von 2 bis 5 ms Länge erkennen, so dass die spektrale Zerlegung mit 3.500 Gammatonfiltern, die in 2-ms-Fenster unterteilt sind, wie eine Maschine erscheint, um ein dem Menschen ähnliches Spektrum zu erreichen bester darzustellender Parameter. In realen Szenarien glaube ich jedoch, dass eine geringere Spektralzerlegung bei den meisten Analyse- und Verarbeitungsaufgaben auch wünschenswerte Ergebnisse erzielt, während sie rechnerisch besser machbar ist.

Verschiedene Softwarebibliotheken für die Höranalyse sind online verfügbar. Ein wichtiges Beispiel ist das Gammatone Filterbank Toolkit von Jason Heeris, das nicht nur abstimmbare Filter bereitstellt, sondern auch Werkzeuge für die Spektralanalyse von Tonsignalen unter Verwendung von Gammatone-Filtern bereitstellt.

neuronale Kodierung
Wenn sich die neurale Aktivität von der Cochlea zum Hörnerv und den aufsteigenden Hörbahnen bewegt, finden mehrere Prozesse in den Kernen des Hirnstamms statt, bevor sie den Hörkortex erreichen.

Diese Verfahren bilden einen neuronalen Code, der die Interaktion zwischen dem Reiz und der Wahrnehmung darstellt. Viel mehr über die spezifischen Jobs innerhalb dieser Kernel sind noch Vermutungen oder unbekannt, also werde ich behandeln, wie sie auf hohem Niveau funktionieren.
Free Download Mp4Gain
picture

Wie bringt man eine Maschine dazu, wie ein Mensch zu klingen?

Wie bringt man eine Maschine dazu, wie ein Mensch zu klingen?

Human Ears

Ein großer Fortschritt in der Technologie der künstlichen Intelligenz wurde durch die Modellierung menschlicher Systeme erzielt.

Human Perception

Obwohl künstliche neuronale Netze mathematische Modelle sind, die nur grob simulieren können, wie menschliche Neuronen tatsächlich funktionieren, ist ihre Anwendung zur Lösung komplexer und mehrdeutiger realer Probleme weitreichend. Darüber hinaus eröffnet die Modellierung der strukturellen Tiefe des menschlichen Gehirns in einem neuronalen Netzwerk eine Vielzahl von Möglichkeiten, um eine sinnvollere Bedeutung hinter den Daten zu erfahren.

Bei der Bilderkennung und -verarbeitung hat die Inspiration durch die komplexen und räumlich invarianten Neuronen in den Convolutional Neural Networks (CNNs) des visuellen Systems ebenfalls zu wesentlichen Verbesserungen unserer Technik geführt. Wenn Sie daran interessiert sind, Bilderkennungstechniken auf Audiospektrogramme anzuwenden, lesen Sie meinen Artikel “Was ist falsch an Convolutional Neural Networks (CNN) und Spektrogrammen für die Audioverarbeitung?”

Solange die menschliche Wahrnehmung die von Maschinen übertrifft, können wir lernen, vom Verständnis der Prinzipien menschlicher Systeme zu profitieren. Menschen sind sehr geschickt bei Wahrnehmungsaufgaben, und im Bereich des maschinellen Hörens ist der Kontrast zwischen menschlichem Verständnis und aktuellen KI-Technologien besonders stark. In Anbetracht der Vorteile, sich von menschlichen Systemen im Bereich der Bildverarbeitung inspirieren zu lassen, schlage ich vor, dass wir neuronale Netze auf ähnliche Prozesse im Bereich des Sehens anwenden können, und es wird Vorteile im Bereich des maschinellen Hörens geben.

Wie man eine Maschine dazu bringt, wie ein Mensch zuzuhören

Der Prozessrahmen dieses Artikels

In dieser Artikelserie werde ich ein Framework für die Audiosignalverarbeitung in Echtzeit mit KI beschreiben, das in Zusammenarbeit zwischen der Universität Aarhus und dem Hersteller von intelligenten Lautsprechern, Dynaudio A/S, entwickelt wurde. Es stützt sich stark auf die Kognitionswissenschaft, die versucht, Perspektiven aus Biologie, Neurowissenschaften, Psychologie und Philosophie zu kombinieren, um unsere kognitiven Fähigkeiten besser zu verstehen.

Kognitive Eigenschaften des Klangs.
Die vielleicht abstrakteste Art, über Klang nachzudenken, ist, wie wir Menschen ihn verstehen. Während Lösungen für Signalverarbeitungsprobleme innerhalb der Grenzen von Eigenschaftsparametern auf niedriger Ebene wie Intensität, Spektrum und Zeit funktionieren müssen, ist das Endziel oft erkennbar: das Signal auf eine bestimmte Weise umzuwandeln, die für uns kognitiv bedeutsam ist Bedeutung, die in The Sound enthalten ist.

Wenn man beispielsweise das Geschlecht des Sprechers eines Diskurses programmatisch ändern möchte, muss das Problem sinnvoller beschrieben werden, bevor seine untergeordneten Merkmale definiert werden. Das Geschlecht eines Sprechers kann als ein kognitives Attribut angesehen werden, das aus vielen Faktoren besteht: dem Ton und der Klangfarbe der Sprache, Unterschieden in der Aussprache, Unterschieden in der Wort- und Sprachwahl und dem Verständnis, wie diese Attribute miteinander in Beziehung stehen.

Diese Parameter können durch Merkmale auf niedrigerer Ebene wie Intensität, spektrale und zeitliche Eigenschaften beschrieben werden, aber nur in komplexeren Kombinationen können sie Bedeutungsdarstellungen auf höherer Ebene bilden. Dies bildet eine Hierarchie von Audiomerkmalen, aus denen auf die “Bedeutung” des Tons geschlossen werden kann. Die kognitiven Eigenschaften menschlicher Stimmen können als durch die kombinierten Zeitreihenmuster von Intensität, Spektrum und statistischen Schalleigenschaften repräsentiert betrachtet werden.

Musikähnlichkeitsmessung mit verlustbehafteter Komprimierung

Musikähnlichkeitsmessung mit verlustbehafteter Komprimierung

Informationsverarbeitungsalgorithmus

formats

Es gibt zwei Soundclips.

Es ist sehr ähnlich. Ich möchte messen, wie ähnlich sie wahrnehmungsmäßig sind, das heißt, wie ähnlich Menschen sie wahrnehmen. Gibt es eine Möglichkeit, zwei Clips mit einem verlustbehafteten Komprimierungsalgorithmus wie MP3, AAC oder dem Ogg Vorbis-Encoder zu vergleichen?

Mir ist aufgefallen, dass in Audiokompressoren bereits sehr viel Wissen über Psychoakustik und menschliche Klangwahrnehmung eingebaut ist. Gibt es eine gute Möglichkeit, sie zu verwenden, um zu messen, wie ähnlich zwei Clips sind?

vielleicht etwas wie L(C1||C2)/(L(C1)+L(C2))L(C1||C2)/(L(C1)+L(C2)), wobei L(X)L(X ) ist die komprimierte Dauer des Soundclips XX, und C1||C2C1||C2Ist das Ergebnis der Verkettung der beiden Clips? Oder finden Sie vielleicht die höchste Bitrate, wie diese F(C1)F(C1)nearF(C2))F(C2))Durch eine einfache Metrik (z. B. die auf das FFT-Spektrum angewendete L2-Norm), wobei F( C)F (C) ist das Ergebnis der Komprimierung von CCat diese Bitrate und die anschließende Dekomprimierung? Oder sowas ähnliches? Hat das jemand untersucht?

Wenn es darauf ankommt, die beiden Clips sind sich sehr ähnlich: Einer wird durch Transformation des anderen erhalten. Sie sind zeitlich ausgerichtet und haben die gleiche Länge. Jeder ist relativ kurz (höchstens einige Sekunden). Ich habe ein bisschen herumgesucht, aber keine Referenzen oder Forschungsarbeiten gefunden, die diesen Ansatz diskutiert haben, obwohl ich es vielleicht nicht getan habe.

Gibt es eine gute Möglichkeit, sie zu verwenden, um zu messen, wie ähnlich zwei Clips sind?

Es ist eine ziemlich vernünftige Intuition, aber eine, die ich selten in der Literatur sehe, abgesehen von der peripheren Idee der Feature-Extraktion aus einem komprimierten Stream (die Motivation hier ist einfach, die Rechenlast zu reduzieren).

Ich denke, der Hauptgrund ist, dass Audio-Codecs keine Wahrnehmungsdarstellungen von Audiodaten speichern. Stattdessen speichern sie eine sehr codezentrische Darstellung des Audiomaterials (Entropiecodierung, Quantisierung, Transformationskoeffizienten), die so gewählt ist, dass die Verzerrung zwischen dem ursprünglichen und dem codierten Signal unter einer wahrnehmbaren Schwelle liegt. In gewisser Weise sagt Ihnen das Betrachten eines komprimierten Audiostreams nicht, wie ein Mensch ein Audiosignal wahrnehmen würde. Es sagt Ihnen einfach, dass etwas unterhalb der Wahrnehmungsschwelle genommen wurde. Der Codec “formt” ein sinnvolles Audiosignal, berührt es aber nie.

wobei L(x) die komprimierte Dauer des Soundclips x ist und C1||C2 das Ergebnis der Verkettung der beiden Clips ist.

Das macht bei Saiten Sinn, ich denke, die Idee findet sich in einigen Cilibrasi- oder Vitanyi-Artikeln, aber so funktionieren Audio-Codecs nicht. Die von Ihnen erwähnten Audio-Codecs sind so konzipiert, dass sie Streaming-Audio mit geringer Latenz verarbeiten, sodass sie jeweils nur ein kurzes Fenster des Signals “sehen” und nicht versuchen, Redundanzen langfristig zu beseitigen. Als JPEG eines Bildes. Das Kopieren von 10 Instanzen derselben Notiz nacheinander führt zu einer 10-mal größeren Datei. Audio-Codecs haben entweder eine feste Bitrate oder eine adaptive Bitrate, die sich basierend darauf anpasst, was der Codec in einem schmalen Signalfenster sieht.

Die Redundanz, die Audio-Codecs eliminieren, ist sehr kurzfristig.

Ihre Idee erfordert einen komplexeren “objektorientierten” Codec, der versucht, Audio in eine Hierarchie von Objekten wie Musiknoten zu zerlegen. Die Idee steckt in der akademischen Welt noch in den Kinderschuhen.

Eine andere Betrachtungsweise besteht darin, zu prüfen, ob der Decodierungsprozess dem generativen Modell des Signals ähnlich ist. Dies ist bei einigen String-Komprimierungsalgorithmen der Fall, bei denen der Komprimierungsprozess eine stringartige generative Grammatik wiederherstellt (Sequitur, Faktororakel …). Dies ist bei LPC-basierten Sprachcodecs der Fall, bei denen die LP-Koeffizienten das Wissen über die Aussprache und das verbleibende Wissen über Prosodie und Vokalisierung/Fehlen von Sprache enthalten: Der komprimierte Strom kann als Daten für einen Sprachsynthesizer betrachtet werden. Dies ist jedoch bei den von Ihnen erwähnten generischen Audio-Codecs nicht der Fall: Codecs ähneln nicht dem Musikproduktionsprozess.

Wahrnehmungsqualität von audiovisuellen Inhalten mit Common Video and Audio Degradation Applied Sciences.

Wahrnehmungsqualität von audiovisuellen Inhalten mit Common Video and Audio Degradation Applied Sciences.

compression

Audiovisuelle Qualitätsbewertung bleibt ein komplexes Forschungsgebiet.

digital audio

Es werden Anstrengungen unternommen, um zu verstehen, wie Menschen die visuellen und auditiven Domänen integrieren und verarbeiten. In dieser Arbeit analysieren und vergleichen wir die Ergebnisse von drei psychologischen Experimenten, die Qualitäts- und Inhaltsbewertungen einer Gruppe von Probanden sammeln. Die Experimente umfassen audiovisuelles Material aus einer Vielzahl von Inhalten wie Sport, Fernsehwerbung, Talkshows, Musik, Dokumentationen und Zeichentrickfilme, die einer Vielzahl von visuellen Effekten (Bitratenkomprimierung, Paketverlust und Frame-Freezing) unterliegen. ) und auditiv (Hintergrundgeräusche). , Echos, Clips, Schnitte) Verzerrung. Jedes Experiment untersucht einen bestimmten Bereich. In Experiment 1 wurde die Videokomponente aufgrund visueller Artefakte verschlechtert, während die Audiokomponente überhaupt nicht verschlechtert wurde. In Experiment 2 wird die Audiokomponente verschlechtert, während die Videokomponente unverändert bleibt. Schließlich werden in Experiment 3 sowohl die Audio- als auch die Videokomponenten verschlechtert. Wie erwartet bestätigten die Ergebnisse die Dominanz der visuellen Komponente in der audiovisuellen Gesamtqualität. Eine detaillierte Analyse zeigt jedoch, dass bei einigen Arten von Audioverzerrungen die Audiokomponenten eine wichtigere Rolle beim Aufbau der gesamten Wahrnehmungsqualität spielen.