Vergleich der Audio-(Audio-)Komprimierung [mp3, wma, ogg, atrac] Teil 2


Free Download Mp4Gain
picture

Vergleich der Audio-(Audio-)Komprimierung [mp3, wma, ogg, atrac] Teil 2
AUDIO COMPRESSION

[Verwendete Tonquelle und Sehenswürdigkeiten]
・ 1-kHz-Sinuswelle
Auf Rauschen oder Korrektur prüfen. Untersuchen Sie, ob anormale Klänge durch Betonung oder Rauschen gemischt werden, die sich vom ursprünglich erzeugten Bereich unterscheiden.

Audio Compression

· Weißes Rauschen
Überprüfen Sie die Frequenzeigenschaften. Verwenden Sie für alle Töne von 0 bis 20 kHz Töne, die mit dem gleichen Pegel ausgegeben werden, und prüfen Sie, ob sie korrekt wiedergegeben werden.

·Musik
Verwenden Sie echte Musik und untersuchen Sie die Unterschiede zum Original.

[Bitrate-Einstellungen]
Feste Bitrate: 96 kHz, 128 kHz, 256 kHz, 320 kHz Variable Bitrate: 96–160 kHz, 192–320 kHz.
Je nach Software können jedoch 320 kHz nicht fest und 350 eingestellt werden, oder die Ober- und Untergrenze in der Variable nicht angegeben werden, und der Tonqualitätsstandard kann in mehreren Stufen angegeben werden (mittlere Tonqualität, hoher Ton Qualität). Qualität).be. Außerdem gibt es einige, die mit einer durchschnittlichen Bitrate anstelle einer variablen Bitrate konfiguriert sind, verstehen Sie also, dass dies kein ganz fairer Vergleich ist.

[Verwendete Software [Encoder]]
・ MP3-System
Nachmittag Koda Ver.3.11a [gogo.exe ver.3.11]
Lame Ivy Frontend Encoder Ver.2.91 [Lame.exe Ver.3.93]
B’s GOLD Ver.7.12 [Unbekannt]
RipAudiCO Ver.3.70 [leme_enc.dll Ver.3.93]

・OGG-System
oggdropXPd Ver.1.7.11 [Unbekannt]
B’s GOLD Ver.7.12 [Unbekannt]

・ WMA
B’s GOLD Ver.7.12 [Unbekannt]
(Für WMA habe ich 3 Arten von Software in meiner Umgebung ausprobiert, aber das Ergebnis war genau das gleiche (vielleicht verwendet der Encoder selbst dasselbe?) Und es entspricht der Software, da der Bitratenbereich eng war, nur ein Typ verwendet).

・ ATRAC
nichts Besonderes. Für ATRAC nahmen wir analog von einem CD-Player auf ein MD-Deck auf, verbanden ein MD-Deck optisch mit einem PC und maßen, was von WAV aufgenommen wurde.

· Messen
Wellenraum Ver.1.31

【Andere】
Obwohl es sich vom Hauptthema unterscheidet, habe ich es für die visuelle Messung jedes Standards in WAV konvertiert (weil WaveSpace nur wav unterstützt), aber die Position, an der der Ton der WAV-Daten endet, und die gesamte Wiedergabe. Wir stellten fest, dass es einen Zeitunterschied gab. , also haben wir es auch untersucht.

3. Hardware 3.
Ursprünglich sollte hier das verwendete Equipment detailliert beschrieben werden, aber die Hardwareumgebung ist bei jedem individuell anders und diese Übersicht ist in erster Linie nur ein Anhaltspunkt, und es wird anders sein, wenn andere dasselbe tun. ist eine Möglichkeit von Ergebnissen, ich werde die detaillierte Beschreibung der Hardware weglassen. (Die Sache ist, dass ich nicht genug Ausrüstung habe, um sie zu veröffentlichen)

【Ergebnisse des Tests】
Nachfolgend finden Sie eine Zusammenfassung der Ergebnisse der einzelnen Umfragen.
・Messergebnis des weißen Rauschens
・1-kHz-Sinuswellen-Messergebnis
・Ergebnisse der Musikmessung
・Einfache Dateigröße und Kommentarliste

[Diskussion]
ah Es scheint keinen großen Unterschied in der Dateigröße zu geben (zwischen der gleichen Bitrate)
Magen. Die Tonqualität scheint MP3 < WMA < OGG bei niedrigen Bitraten zu sein
(MP3: 128 = WMA: 96 < OGG: 96).
Hase. Bei hohen Bitraten gibt es kaum einen Unterschied
(Es gibt einen kleinen Unterschied im Höhenbereich, aber es scheint, dass Sie den Unterschied nicht bemerken werden, es sei denn, Sie befinden sich in einer sehr guten Umgebung).
Arbeiter. Der Unterschied in der Encoder-Software war größer als ich erwartet hatte
(besonders bei MP3)

“Meine Schlussfolgerung”
[Weniger als 128]
Wenn Sie sich Sorgen um die Popularisierung (Kompatibilität) machen, ist [WMA] gut, und wenn Sie es im Grunde alleine verwenden, ist [OGG] gut.
(Ich mache mir Sorgen um die Menge an Rauschen oder die Korrektur, aber ich habe trotzdem ein bisschen bei der Klangqualität geopfert, also habe ich mich für die entschieden, die so wie sie ist bis in den Höhenbereich abdeckt. Auch wegen der Beziehung zwischen ① und ② , mp3 ist ein anderes mit der gleichen Klangqualität. Die Dateigröße ist größer als

[Mit 256 und mehr]
Die variable Bitrate (192-320) von [Afternoon Koda] ist gut.
Der feste 320 ist gut für die Klangqualität, aber es gibt kaum einen Unterschied zwischen dem festen 256 und dem variablen hochwertigen Klang, und es scheint, dass Sie ihn kaum verstehen können, selbst wenn Sie ihn hören. Wenn die Tonqualität ungefähr gleich ist, gilt: Je kleiner die Dateigröße, desto besser.

[Andere Impressionen]
Über OGG
Ich hatte hohe Erwartungen an OGG, aber ich war besorgt über das Messergebnis bei 1 kHz, ob es Rauschen oder Korrektur war. Allerdings finde ich das Verhältnis zwischen Tonqualität (breites Wiedergabeband) bei niedrigen Bitraten und Dateigröße hervorragend. Bei hohen Bitraten sind die Klangqualität und die Dateigröße etwa gleich wie bei MP3s, daher denke ich, dass MP3s in Anbetracht der Durchdringungsrate vorteilhaft sind, aber ich denke, dass sie ziemlich gut abschneiden, wenn man bedenkt, dass sie gerade erst entwickelt wurden. in der Zukunft erwartet

Free Download Mp4Gain
picture

Vergleich der Audio-(Audio-)Komprimierung [mp3, wma, ogg, atrac]

Vergleich der Audio-(Audio-)Komprimierung [mp3, wma, ogg, atrac]

Compressed Audio

MP3-artiges Audio usw. zum Speichern von Musik, die auf Kassetten aufgenommen wurde, von CD-Verleihen ausgeliehene oder gekaufte Musik-CDs oder zum einfachen Genuss mit einem tragbaren Player oder Auto.

compressed audio

Immer mehr Menschen nehmen mit Kompressionstechnologie auf. Es gibt jedoch viele Standards wie WMA, die von Microsoft empfohlen werden, sowie MP3, wenn es um Audiokomprimierung geht. Da sich außerdem die Tonqualität und die Komprimierungsrate jedes Standards in Abhängigkeit von der Bitrateneinstellung und dergleichen ändern, gibt es je nach Kombination des Standards und der Einstellung eine große Vielfalt von Komprimierungsverfahren.

Ich wollte also überprüfen, wie die Klangqualität und Dateigröße bei der Aufnahme mit welchem ​​Standard und mit welchen Einstellungen wäre, und den Standard auswählen, der für meine Zwecke geeignet ist, also habe ich an dieser Umfrage teilgenommen. Aufgrund der Untersuchung der Ideen von Fans wurden jedoch die verwendete Software und Ausrüstung von denen abgedeckt, die frei erhältlich oder im Internet erhältlich sind, sodass das Ergebnis möglicherweise von der ursprünglichen Leistung abweicht. , aber es ist nur eine. Nehmen Sie es als Beispiel.
Da sich dieser Test auf die Tonqualität konzentriert, wird er nicht mit einer niedrigen Bitrate getestet, was die Tonqualität verschlechtert.

Schließlich habe ich bei der Durchführung dieser Umfrage auf viele Dokumente im Internet verwiesen. Wir möchten jeder Person (Einzelperson/Körperschaft) unseren Dank dafür aussprechen, dass sie es uns ermöglicht, Materialien, die mit beträchtlichem Aufwand recherchiert und erstellt wurden, aus ihrer jeweiligen Sichtweise zu überprüfen. Die Seiten, auf die ich hauptsächlich verwiesen habe, werden unten auf dieser Seite aufgeführt, daher empfehle ich denen, die sich diese Seite ansehen, auch einen Blick darauf zu werfen.

[Übersicht der Umfrage]
1. 1. Bestimmungsortstandards
Wie oben erwähnt, gibt es viele Audiokomprimierungsstandards, aber hier haben wir sie auf MP3, WMA, OGG und ATRAC beschränkt. Die Standards und Gründe für die Umfrage sind unten aufgeführt.

・MP3 (Moving Picture Experts Group 1 Audio Layer – 3)
Ich habe es gewählt, weil es wahrscheinlich der bekannteste und beliebteste Standard ist und es aus dem gleichen Grund viele kompatible Player gibt.

・WMA (Windows Media Audio) _ _
Es ist neben MP3 weithin bekannt. Seit kurzem ist es mit Autoradios und DVD-Playern kompatibel. Außerdem soll laut einer Theorie die gleiche Bitrate eine höhere Klangqualität und Komprimierung als MP3 haben, also habe ich mich dafür entschieden.

・OGG (Ogg-Vorbis)
Es ist Ihnen vielleicht noch nicht vertraut, aber obwohl MP3 eine Lizenz erfordert, nimmt die Zahl der kompatiblen Player allmählich zu, da es nicht lizenziert ist, aber eine hohe Klangqualität und hohe Komprimierung bietet. Da es (anscheinend) leistungsstark und lizenzfrei ist, ist es einfach, Encoder und Wiedergabesoftware zu entwickeln, daher haben wir es in der Erwartung ausgewählt, dass es sich in Zukunft verbreiten wird.

・ATRAC (Advanced TR Transform Acoustic Coding) _ _
Dieser Name ist Ihnen vielleicht nicht vertraut, aber Sie können den von MD übernommenen Standard verstehen. Viele Leute denken, dass MD die gleiche hohe Klangqualität wie CD hat, und da sie als Speichermedium für Musik weit verbreitet ist, wurde sie als Vergleichsreferenz herangezogen.

・ Grund, warum andere Standards nicht ins Visier genommen werden
Es gibt viele Komprimierungsstandards zusätzlich zu den oben genannten, aber es gibt nur wenige kompatible Software und Player, und in Anbetracht der Interaktion mit anderen (obwohl ich das nicht öffentlich sagen kann), urteilte ich, dass der Vergleich mit den drei oben genannten Typen angemessen ist. Darüber hinaus gibt es einen Standard namens OpenMG (ATRAC3), der von SONY usw. empfohlen wird, und es besteht keine Notwendigkeit, andere als SONY in mobilen Playern usw. zu übernehmen, aber es gibt immer noch wenige (begrenzte) unterstützte Player, und die Aufzeichnung ist fertig. mit Ausnahme von VAIO-Benutzern, da dies schwierig ist, wurde es vom Ziel ausgeschlossen.

2. 2. Erhebungsmethode
Die drei für die Befragung ausgewählten Tonarten wurden in verschiedene Bitraten der jeweiligen Standards umgewandelt, visuell mit den Originaltönen verglichen, angehört und bewertet. Außerdem habe ich Gerüchte gehört, dass, obwohl der Standard derselbe ist, es je nach Konvertierungssoftware Unterschiede gibt, also habe ich verschiedene Arten von Software (Encoder) verwendet. das Detail ist gleich unten.

Digitale Audiokomprimierung

Digitale Audiokomprimierung

Digital Audio Compression

Das Konzept der Lautstärke ist nicht nur für einen Musiker nah und verständlich, sondern auch für Menschen, die nicht mit Musik verbunden sind. Die Beziehung zwischen der Lautstärke der Teile eines Stücks und der Lautstärke der Instrumente, die gleichzeitig spielen, wird als Dynamikbereich bezeichnet. Eines der wichtigsten Werkzeuge, mit denen Produzenten und Musiker den Dynamikbereich beeinflussen, ist der Kompressor.

Digital Audio Compression

Obwohl der Kompressor mit einem bekannten Phänomen, der Lautstärke, arbeitet, erfolgt seine Verwendung in den meisten Fällen spontan und zufällig, ohne die Essenz des Geschehens zu verstehen. Sie können das allgemeine Prinzip des Kompressors und den Zweck jedes Griffs kennen, aber dies beseitigt nicht die Betäubung auf den ersten Blick.

Warum brauchst du einen Kompressor?

Der Hauptzweck des Kompressors besteht darin, den Signalpegel automatisch zu ändern. Es funktioniert ungefähr so, als ob Sie Ihre Hand ständig auf dem Lautstärkeregler halten und ihn auf und ab drehen würden. Der Unterschied besteht darin, dass ein Kompressor sehr schnell auf Änderungen reagieren kann, viel schneller und genauer als ein Mensch.

Bis zu diesem Zeitpunkt bedeutete das Wort Kompressor eine ganze Klasse dynamischer Geräte. Nach den gleichen Grundprinzipien wie bei einem herkömmlichen Kompressor arbeiten verschiedene Instrumente für unterschiedliche Zwecke: Begrenzer, Expander, Tore usw. Sie werden durch die Arbeit mit der Lautstärke einzelner Sounds oder der Mischung als Ganzes vereint.

Der klassische Kompressor ist schon mit seinem Namen umstritten. Jeder weiß, dass er den lautesten Ton macht. Der Name stammt jedoch von compress, was “Komprimierung” bedeutet. Wenn Sie einen Tontechniker fragen, was ein Kompressor tut, hören Sie die Antwort: “Squash the Signal”. Der Kompressor reduziert die Amplitude der dynamischen Bursts und macht sie leiser. Was ist der Hauptzweck des Kompressors: ihn leiser oder lauter zu machen? Die Antwort ist beides gleichzeitig.

Nehmen wir ein Beispiel für die Sprachaufzeichnung. Sehr oft werden beim Singen Silben oder Geräusche unterschiedlicher Lautstärke gehört. Wenn der Sänger die Dynamik seiner Aufführung nicht sehr gut kontrolliert, verursachen solche Unterschiede Probleme für den Toningenieur und wirken sich negativ auf das Endergebnis der Arbeit aus. Stille Silben verschwinden in der Mischung, Text wird schwer zu unterscheiden, und wenn Sie die Lautstärke für einen ruhigen Bereich einstellen, beginnt die Stimme an anderen Stellen “hervorzuheben”.

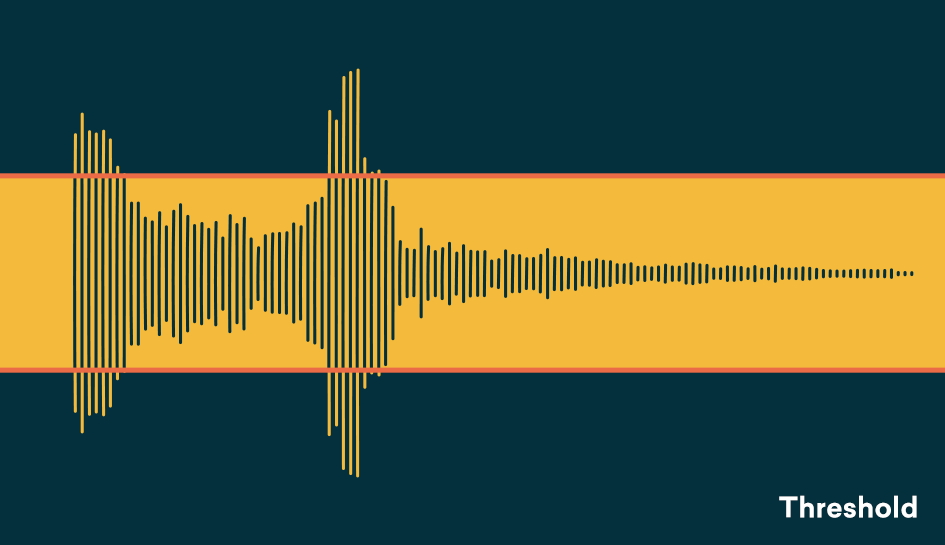
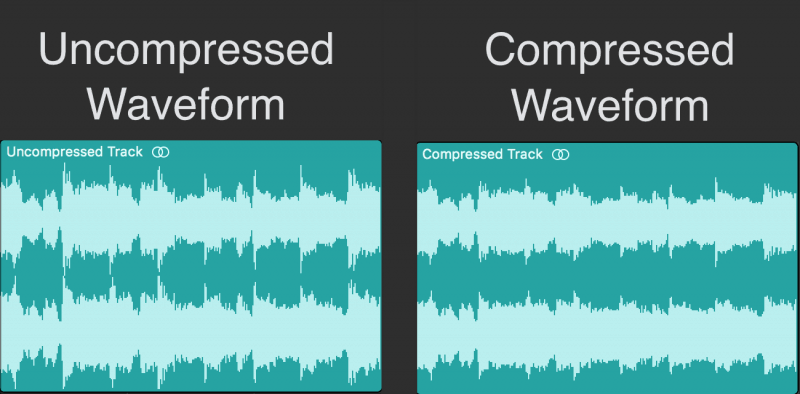
Hier kommt der Kompressor ins Spiel. Es ermöglicht Ihnen, starke Bursts zu unterdrücken und sie mit stillen Fragmenten auszugleichen. Jetzt können Sie die Lautstärke des Tracks erhöhen, ohne befürchten zu müssen, dass Silben herausragen. Der Kompressor macht den Klang gleichzeitig niedriger und höher. Drei Bilder zeigen die Phasen der Arbeit mit Ton: eine Quelle mit großen Spitzen (a), ein komprimiertes Signal (b) und eine Erhöhung des Lautstärkepegels der gesamten Datei (c).

Es ist besonders wichtig, die Komprimierung anzuwenden, wenn Sie in einer digitalen Umgebung aufnehmen, wenn wir gezwungen sind, einen Maximalpegel von 0 dB einzuhalten, da das Überschreiten dieses Schwellenwerts zu Clips und Verzerrungen führt. Wenn Clips angezeigt werden, verringern wir den Vorverstärkerpegel, was bedeutet, dass wir nicht nur die Lautstärke von Bursts, sondern auch von ruhigen Bereichen verringern, was zu einer Signalverschlechterung aufgrund von Quantisierung und Aliasing-Rauschen führt.

Der Kompressor, der zwischen dem Vorverstärker und dem digitalen Aufnahmesystem positioniert ist, arbeitet nur mit den lautesten Bursts, reduziert deren Lautstärke und sorgt für einen gleichmäßigen Soundtrack. Dank dessen haben wir die Möglichkeit, die Gesamtlautstärke des aufgenommenen Signals nicht zu reduzieren und die Klangqualität beizubehalten.

Leider verwenden viele moderne Musiker den Kompressor überall, ohne auf die technischen Eigenschaften des Kompressors einzugehen, und glauben, dass Sie mit seiner Hilfe jeden Klang in der Mischung “dehnen” können. Unter extremen Bedingungen sind Kompressoren häufig auf der Straße enthalten. Sie werden nur von erfahrenen Toningenieuren eingesetzt, wenn ein wirklicher Bedarf besteht.

Der Kompressor hilft, Aufnahmeprobleme zu vermeiden. Die häufigsten Ursachen für Probleme können folgende sein:

Nichtprofessionalität des Dolmetschers (dynamische Ungleichmäßigkeit).
Nicht übereinstimmender Pfad (schlechte, nicht übereinstimmende oder unzureichende Mikrofone, Vorverstärker).
Nachteile der digitalen Umgebung (begrenzt auf 0 dB).
Unbequeme Bedingungen für den Sänger (kleiner und stickiger Raum, schlechte Überwachung).
Geringe Qualifikation eines Toningenieurs.
Wenn ein Darsteller eine Stimme hat und in ein Mikrofon singen kann und ein Toningenieur seine Arbeit gut kennt und weiß, wie man Mikrofone richtig positioniert und Geräte aufstellt, ist möglicherweise überhaupt kein Kompressor erforderlich. Dies ist jedoch die ideale Situation.

Digitale Audiokomprimierung

Digitale Audiokomprimierung

Digital Audio Compression

Die Komprimierung von Audiodaten ist heute ein echtes Problem. Es gibt zwei Gründe für die Notwendigkeit, Audiodaten zu komprimieren: Speichereinsparungen beim Speichern von Audioinformationen, geringe Bandbreite der digitalen Fernübertragungskanäle für Informationen. Die Komprimierung löst effektiv die beiden oben genannten Probleme. Die Datenkomprimierung ist eine algorithmische Transformation von Daten, die durchgeführt wird, um deren Volumen zu reduzieren.

Data Compression

Es wird für eine rationellere Verwendung von Datenspeicherungs- und -übertragungsgeräten verwendet. Die Komprimierung basiert auf der Beseitigung der in den Originaldaten enthaltenen Redundanz. Um die für die Übertragung von Sprachsignalen (Musik) über moderne digitale Kommunikationskanäle mit niedriger Geschwindigkeit erforderlichen Parameter zu gewährleisten und die angegebene Störfestigkeit zu gewährleisten, müssen hocheffiziente Datenkomprimierungsalgorithmen verwendet werden. Der Übertragungskanal zeichnet sich durch ein Konzept wie die Kapazität des Kanals aus: Und das Signal – durch die Lautstärke (Signal): …

Beide oben genannten Merkmale umfassen den Dynamikbereich D, die Kanalbreite (Signalspektrum) und die Laufzeit T. Digitale Audiokompressoren werden verwendet, um den Dynamikbereich zu verringern. Um die spektrale Effizienz zu verbessern, werden digitale Filter verwendet, um das Spektrum des Encoder-Ausgangssignals zu begrenzen (gemäß Nyquist-Kriterien). Unter anderem werden Codierer verwendet, die auf den Prinzipien der Beseitigung von Redundanz (Huffman-Codes) basieren, um eine bestimmte Informationsübertragungsgeschwindigkeit zu gewährleisten. Das Wesentliche davon ist wie folgt: Codes, die auf dem Prinzip basieren, wahrscheinlichere Werte der Amplituden der Codewörter mit kürzerer Länge als die unwahrscheinlichen zuzuweisen.

Betrachten wir, wie die oben beschriebenen Redundanztypen beseitigt werden.
Struktur eines verlustbehafteten Audiokomprimierungscodierers Das ursprüngliche digitale Audiosignal wird in Frequenzteilbänder unterteilt und zeitlich in einen Zeit-Frequenz-Segmentierungsblock segmentiert. Die Länge des codierten Samples hängt von der Form der zeitlichen Funktion des Audiosignals ab. In Abwesenheit scharfer Amplitudenspitzen wird eine lange Probe verwendet, die eine hochfrequente Auflösung liefert. Bei abrupten Änderungen der Signalamplitude nimmt die Länge der codierten Probe dramatisch ab, was zu einer höheren Zeitauflösung führt. Die Entscheidung, die Länge der codierten Probe zu ändern, wird von der psychoakustischen Analyseeinheit getroffen, die den Wert der psychoakustischen Entropie des Signals berechnet.
Nach der Segmentierung werden die Frequenzteilbandsignale normalisiert, quantisiert und codiert. Bei den effizientesten Komprimierungsalgorithmen werden nicht die Abtastwerte des Audiosignals codiert, sondern die entsprechenden MDCT-Koeffizienten. (Die Differenz zwischen den Koeffizienten ist kleiner.) Die Abrechnung der auditorischen Wahrnehmungsmuster eines Tonsignals erfolgt in der psychoakustischen Analyseeinheit. Hier wird nach einem speziellen Verfahren für jedes Frequenzteilband der maximal zulässige Pegel der Quantisierungsverzerrung (Rauschen) berechnet, in dem sie noch durch das Nutzsignal dieses Teilbandes maskiert sind.

Der Block der dynamischen Verteilung von Bits gemäß den Anforderungen des psychoakustischen Modells für jedes codierende Teilband wählt eine minimal mögliche Anzahl von ihnen aus, bei denen der Grad der durch die Quantisierung verursachten Verzerrungen den vom Modell berechneten Schwellenwert ihrer Hörbarkeit nicht überschreitet psychoakustisch.

In diesem Artikel werden die Funktionsdiagramme der Audiodatenkomprimierungsalgorithmen basierend auf den µ-Gesetzen A betrachtet. Das Funktionsdiagramm des Komprimierungsalgorithmus basierend auf dem A-Level-Komprimierungsgesetz ist in Abb. 2 dargestellt. Abbildung 2. Funktionsdiagramm des Komprimierungsalgorithmus basierend auf dem A-Pegel-Komprimierungsgesetz Ein Signal (diskreter Sinus) wird an den Eingang des Kompressors angelegt. Nach der Komprimierung gelangt das Signal zum Addierer, wo das Rauschen dem zweiten Eingang des Addierers zugeführt wird, wodurch das additive Rauschen des Übertragungskanals simuliert wird.

Dann tritt das verrauschte Signal in den Eingang des Expanders ein, am Ausgang erhalten wir das rekonstruierte Signal. Das rekonstruierte und ursprüngliche Signal wird dann dem Addierer zugeführt, wonach die Leistung des spektralen Rauschens beobachtet wird.

Simulationsergebnisse (A = 87,6)
Die folgenden Grafiken werden dargestellt: 1 Originalsignal, 2 durch den Kompressor geleitete Signale, 3 wiederhergestellte Signale, 4 Rauschleistungen am Ausgang des Rauschgenerators, 5 Rauschleistungen nach dem Expander.