Digitale Audiokomprimierung


Free Download Mp4Gain
picture

Digitale Audiokomprimierung

Digital Audio Compression

Das Konzept der Lautstärke ist nicht nur für einen Musiker nah und verständlich, sondern auch für Menschen, die nicht mit Musik verbunden sind. Die Beziehung zwischen der Lautstärke der Teile eines Stücks und der Lautstärke der Instrumente, die gleichzeitig spielen, wird als Dynamikbereich bezeichnet. Eines der wichtigsten Werkzeuge, mit denen Produzenten und Musiker den Dynamikbereich beeinflussen, ist der Kompressor.

Digital Audio Compression

Obwohl der Kompressor mit einem bekannten Phänomen, der Lautstärke, arbeitet, erfolgt seine Verwendung in den meisten Fällen spontan und zufällig, ohne die Essenz des Geschehens zu verstehen. Sie können das allgemeine Prinzip des Kompressors und den Zweck jedes Griffs kennen, aber dies beseitigt nicht die Betäubung auf den ersten Blick.

Warum brauchst du einen Kompressor?

Der Hauptzweck des Kompressors besteht darin, den Signalpegel automatisch zu ändern. Es funktioniert ungefähr so, als ob Sie Ihre Hand ständig auf dem Lautstärkeregler halten und ihn auf und ab drehen würden. Der Unterschied besteht darin, dass ein Kompressor sehr schnell auf Änderungen reagieren kann, viel schneller und genauer als ein Mensch.

Bis zu diesem Zeitpunkt bedeutete das Wort Kompressor eine ganze Klasse dynamischer Geräte. Nach den gleichen Grundprinzipien wie bei einem herkömmlichen Kompressor arbeiten verschiedene Instrumente für unterschiedliche Zwecke: Begrenzer, Expander, Tore usw. Sie werden durch die Arbeit mit der Lautstärke einzelner Sounds oder der Mischung als Ganzes vereint.

Der klassische Kompressor ist schon mit seinem Namen umstritten. Jeder weiß, dass er den lautesten Ton macht. Der Name stammt jedoch von compress, was “Komprimierung” bedeutet. Wenn Sie einen Tontechniker fragen, was ein Kompressor tut, hören Sie die Antwort: “Squash the Signal”. Der Kompressor reduziert die Amplitude der dynamischen Bursts und macht sie leiser. Was ist der Hauptzweck des Kompressors: ihn leiser oder lauter zu machen? Die Antwort ist beides gleichzeitig.

Nehmen wir ein Beispiel für die Sprachaufzeichnung. Sehr oft werden beim Singen Silben oder Geräusche unterschiedlicher Lautstärke gehört. Wenn der Sänger die Dynamik seiner Aufführung nicht sehr gut kontrolliert, verursachen solche Unterschiede Probleme für den Toningenieur und wirken sich negativ auf das Endergebnis der Arbeit aus. Stille Silben verschwinden in der Mischung, Text wird schwer zu unterscheiden, und wenn Sie die Lautstärke für einen ruhigen Bereich einstellen, beginnt die Stimme an anderen Stellen “hervorzuheben”.

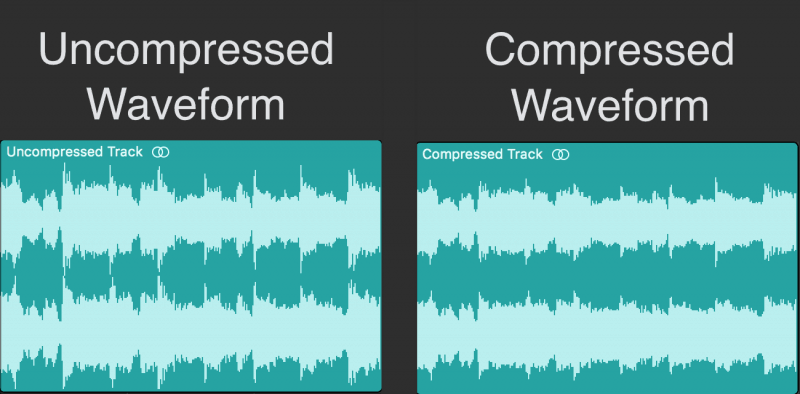
Hier kommt der Kompressor ins Spiel. Es ermöglicht Ihnen, starke Bursts zu unterdrücken und sie mit stillen Fragmenten auszugleichen. Jetzt können Sie die Lautstärke des Tracks erhöhen, ohne befürchten zu müssen, dass Silben herausragen. Der Kompressor macht den Klang gleichzeitig niedriger und höher. Drei Bilder zeigen die Phasen der Arbeit mit Ton: eine Quelle mit großen Spitzen (a), ein komprimiertes Signal (b) und eine Erhöhung des Lautstärkepegels der gesamten Datei (c).

Es ist besonders wichtig, die Komprimierung anzuwenden, wenn Sie in einer digitalen Umgebung aufnehmen, wenn wir gezwungen sind, einen Maximalpegel von 0 dB einzuhalten, da das Überschreiten dieses Schwellenwerts zu Clips und Verzerrungen führt. Wenn Clips angezeigt werden, verringern wir den Vorverstärkerpegel, was bedeutet, dass wir nicht nur die Lautstärke von Bursts, sondern auch von ruhigen Bereichen verringern, was zu einer Signalverschlechterung aufgrund von Quantisierung und Aliasing-Rauschen führt.

Der Kompressor, der zwischen dem Vorverstärker und dem digitalen Aufnahmesystem positioniert ist, arbeitet nur mit den lautesten Bursts, reduziert deren Lautstärke und sorgt für einen gleichmäßigen Soundtrack. Dank dessen haben wir die Möglichkeit, die Gesamtlautstärke des aufgenommenen Signals nicht zu reduzieren und die Klangqualität beizubehalten.

Leider verwenden viele moderne Musiker den Kompressor überall, ohne auf die technischen Eigenschaften des Kompressors einzugehen, und glauben, dass Sie mit seiner Hilfe jeden Klang in der Mischung “dehnen” können. Unter extremen Bedingungen sind Kompressoren häufig auf der Straße enthalten. Sie werden nur von erfahrenen Toningenieuren eingesetzt, wenn ein wirklicher Bedarf besteht.

Der Kompressor hilft, Aufnahmeprobleme zu vermeiden. Die häufigsten Ursachen für Probleme können folgende sein:

Nichtprofessionalität des Dolmetschers (dynamische Ungleichmäßigkeit).
Nicht übereinstimmender Pfad (schlechte, nicht übereinstimmende oder unzureichende Mikrofone, Vorverstärker).
Nachteile der digitalen Umgebung (begrenzt auf 0 dB).
Unbequeme Bedingungen für den Sänger (kleiner und stickiger Raum, schlechte Überwachung).
Geringe Qualifikation eines Toningenieurs.
Wenn ein Darsteller eine Stimme hat und in ein Mikrofon singen kann und ein Toningenieur seine Arbeit gut kennt und weiß, wie man Mikrofone richtig positioniert und Geräte aufstellt, ist möglicherweise überhaupt kein Kompressor erforderlich. Dies ist jedoch die ideale Situation.


Free Download Mp4Gain
picture

Digitale Audiokomprimierung

Digitale Audiokomprimierung

Digital Audio Compression

Die Komprimierung von Audiodaten ist heute ein echtes Problem. Es gibt zwei Gründe für die Notwendigkeit, Audiodaten zu komprimieren: Speichereinsparungen beim Speichern von Audioinformationen, geringe Bandbreite der digitalen Fernübertragungskanäle für Informationen. Die Komprimierung löst effektiv die beiden oben genannten Probleme. Die Datenkomprimierung ist eine algorithmische Transformation von Daten, die durchgeführt wird, um deren Volumen zu reduzieren.

Data Compression

Es wird für eine rationellere Verwendung von Datenspeicherungs- und -übertragungsgeräten verwendet. Die Komprimierung basiert auf der Beseitigung der in den Originaldaten enthaltenen Redundanz. Um die für die Übertragung von Sprachsignalen (Musik) über moderne digitale Kommunikationskanäle mit niedriger Geschwindigkeit erforderlichen Parameter zu gewährleisten und die angegebene Störfestigkeit zu gewährleisten, müssen hocheffiziente Datenkomprimierungsalgorithmen verwendet werden. Der Übertragungskanal zeichnet sich durch ein Konzept wie die Kapazität des Kanals aus: Und das Signal – durch die Lautstärke (Signal): …

Beide oben genannten Merkmale umfassen den Dynamikbereich D, die Kanalbreite (Signalspektrum) und die Laufzeit T. Digitale Audiokompressoren werden verwendet, um den Dynamikbereich zu verringern. Um die spektrale Effizienz zu verbessern, werden digitale Filter verwendet, um das Spektrum des Encoder-Ausgangssignals zu begrenzen (gemäß Nyquist-Kriterien). Unter anderem werden Codierer verwendet, die auf den Prinzipien der Beseitigung von Redundanz (Huffman-Codes) basieren, um eine bestimmte Informationsübertragungsgeschwindigkeit zu gewährleisten. Das Wesentliche davon ist wie folgt: Codes, die auf dem Prinzip basieren, wahrscheinlichere Werte der Amplituden der Codewörter mit kürzerer Länge als die unwahrscheinlichen zuzuweisen.

Betrachten wir, wie die oben beschriebenen Redundanztypen beseitigt werden.
Struktur eines verlustbehafteten Audiokomprimierungscodierers Das ursprüngliche digitale Audiosignal wird in Frequenzteilbänder unterteilt und zeitlich in einen Zeit-Frequenz-Segmentierungsblock segmentiert. Die Länge des codierten Samples hängt von der Form der zeitlichen Funktion des Audiosignals ab. In Abwesenheit scharfer Amplitudenspitzen wird eine lange Probe verwendet, die eine hochfrequente Auflösung liefert. Bei abrupten Änderungen der Signalamplitude nimmt die Länge der codierten Probe dramatisch ab, was zu einer höheren Zeitauflösung führt. Die Entscheidung, die Länge der codierten Probe zu ändern, wird von der psychoakustischen Analyseeinheit getroffen, die den Wert der psychoakustischen Entropie des Signals berechnet.
Nach der Segmentierung werden die Frequenzteilbandsignale normalisiert, quantisiert und codiert. Bei den effizientesten Komprimierungsalgorithmen werden nicht die Abtastwerte des Audiosignals codiert, sondern die entsprechenden MDCT-Koeffizienten. (Die Differenz zwischen den Koeffizienten ist kleiner.) Die Abrechnung der auditorischen Wahrnehmungsmuster eines Tonsignals erfolgt in der psychoakustischen Analyseeinheit. Hier wird nach einem speziellen Verfahren für jedes Frequenzteilband der maximal zulässige Pegel der Quantisierungsverzerrung (Rauschen) berechnet, in dem sie noch durch das Nutzsignal dieses Teilbandes maskiert sind.

Der Block der dynamischen Verteilung von Bits gemäß den Anforderungen des psychoakustischen Modells für jedes codierende Teilband wählt eine minimal mögliche Anzahl von ihnen aus, bei denen der Grad der durch die Quantisierung verursachten Verzerrungen den vom Modell berechneten Schwellenwert ihrer Hörbarkeit nicht überschreitet psychoakustisch.

In diesem Artikel werden die Funktionsdiagramme der Audiodatenkomprimierungsalgorithmen basierend auf den µ-Gesetzen A betrachtet. Das Funktionsdiagramm des Komprimierungsalgorithmus basierend auf dem A-Level-Komprimierungsgesetz ist in Abb. 2 dargestellt. Abbildung 2. Funktionsdiagramm des Komprimierungsalgorithmus basierend auf dem A-Pegel-Komprimierungsgesetz Ein Signal (diskreter Sinus) wird an den Eingang des Kompressors angelegt. Nach der Komprimierung gelangt das Signal zum Addierer, wo das Rauschen dem zweiten Eingang des Addierers zugeführt wird, wodurch das additive Rauschen des Übertragungskanals simuliert wird.

Dann tritt das verrauschte Signal in den Eingang des Expanders ein, am Ausgang erhalten wir das rekonstruierte Signal. Das rekonstruierte und ursprüngliche Signal wird dann dem Addierer zugeführt, wonach die Leistung des spektralen Rauschens beobachtet wird.

Simulationsergebnisse (A = 87,6)
Die folgenden Grafiken werden dargestellt: 1 Originalsignal, 2 durch den Kompressor geleitete Signale, 3 wiederhergestellte Signale, 4 Rauschleistungen am Ausgang des Rauschgenerators, 5 Rauschleistungen nach dem Expander.

Verstehen Sie, was Audiokomprimierung ist

Verstehen Sie, was Audiokomprimierung ist

Audio Compresion

Ein Containerformat ist ein Datenformat, das andere codierte Daten “kapselt”. Es enthält häufig “Metainformationen” zu den codierten Daten oder bietet die Möglichkeit, mehrere separate Streams codierter Daten oder ähnliches zu speichern.

Adio Compression

Die vom Codec erzeugte Codierung ist die eigentliche Essenz des Datenstroms.

Das häufigste Beispiel, an das ich denken kann, ist das Ogg / Vorbis-Format. Ogg ist das Containerformat und Vorbis ist die Codierung. Sie haben also eine Ogg-Datei und darin befinden sich diese kleinen Segmente, die codierte Daten enthalten. Jeder Block enthält einen Strom von Vorbis-codierten Daten und sonst nichts. Ein Würfel kann beispielsweise den Namen eines Künstlers und den Titel eines Songs enthalten.

Zurück zur Technologie:

Wenn Sie bereits verlustbehaftete Musik wie MP3 oder ogg / vorbis haben, nimmt die Konvertierung in ein verlustfreies Format nur (viel) Speicherplatz in Anspruch und verbessert die Audioqualität überhaupt nicht. Sie können keine Loyalität schaffen, wenn sie bereits verloren ist. Es sei denn, Sie schreiben eine Visual Basic-Benutzeroberfläche in einer beliebten TV-Show namens CSI, aber das ist Fantasie, nicht Realität.

Wenn Sie Musik in anderen verlustfreien Formaten haben und diese in FLAC konvertieren möchten, können Sie dies tun.

Seien Sie vorsichtig, wenn Sie den Begriff “WAV” verwenden. Wav muss nicht verlustfrei sein; Tatsächlich ist WAV nur ein Container für die verschiedenen möglichen Formate. In diesem Sinne ähnelt es AVI. Sie können verlustfreies WAV haben, wenn es sich nur um PCM-Rohdaten handelt, aber Sie können auch verlustbehaftete MPEG-1 Layer III-Daten in eine WAV-Datei einbetten.

Es ist möglich, Daten beim Konvertieren von einem verlustfreien Format in ein anderes zu verlieren, wenn Sie die Genauigkeit der Daten verringern. Wenn Sie beispielsweise einen vorzeichenlosen 16-Bit-PCM-Datenstrom mit 48000 Hz in 8-Bit-PCM-Daten mit 44100 Hz konvertieren, verlieren Sie auf zwei Arten an Genauigkeit: Samples werden von 48000 auf jeweils nur 44100 zusammengeführt. Zweitens (was zu Datenverlust führt), und die Daten müssen verschlüsselt werden, um die Informationen in nur 8 Bit anstatt in 16 Bit pro Abtastung zu passen, was die Qualität drastisch verschlechtert.

Jeder digitale Audiostream, selbst wenn er mit einem komprimierten Encoder (verlustbehaftet oder verlustfrei) codiert ist, verfügt über die folgenden Eigenschaften des Beispielformats, die wichtige Elemente sind, die die Eigenschaften des Streams beschreiben:

Ein Beispiel für Bitbreite und -tiefe, d. H. 8 Bit, 16 Bit usw. Bitbreiten und -tiefen unterscheiden sich geringfügig, und es gibt auch eine große Endian / Endian-Bytereihenfolge (die die Qualität nicht beeinflusst) und ein vorzeichenbehaftetes oder vorzeichenloses Vorzeichen (das ebenfalls keine Rolle spielt), das die Qualität beeinflusst, aber den Encoder / Decoder-Betrieb beeinflusst mit Daten). Der wichtigste Punkt, an den Sie sich erinnern sollten, ist “je mehr Bits desto besser”. 32-Bit ist also besser als 16-Bit usw.

Frequenz, auch als Abtastrate bekannt. Je mehr desto besser, denn pro Sekunde werden mehr „Samples“ abgespielt. Stellen Sie sich vor, Sie gleiten mit dem Finger über ein Kartenspiel und sehen, wie die Karten verschwimmen. Auf diese Weise entsteht im Wesentlichen digitaler Klang. Jedes Sample ist eine Karte. Wenn mehr Karten pro Sekunde fliegen, ist der Klang leiser. Zum Beispiel würden Sie wirklich bemerken, wenn Sie nur 5 Karten pro Sekunde umdrehen würden, aber alles wäre verschwommen, wenn Sie Tausende von Karten pro Sekunde umdrehen würden. Es ist also noch besser, weil es natürlicher und realitätsnaher ist, was analog und unendlich teilbar ist (bis zu Planck-Einheiten, aber dies ist umstritten und nicht thematisch).

Verlustfrei bedeutet einfach, dass Sie keine Daten verlieren, wenn Sie in der Ausgabe dasselbe oder ein besseres Beispielformat verwenden, das Sie in der Eingabe verwendet haben.

Wenn Sie also vom 16-Bit- zum 32-Bit-Beispielformat wechseln, gehen keine Daten verloren. Wenn Sie jedoch von 32 Bit auf 16 Bit wechseln, gehen Daten verloren.

Die Antwort auf Ihre Frage, ob die Verwendung von FLAC sinnvoll ist, hängt von den Originaldaten ab: Wenn Sie 64-Bit-WAV-Dateien haben, die ursprünglich in diesem Beispielformat mit 192.000 Hz (oder 192 kHz) aufgezeichnet wurden, und diese in das Format “konvertieren” Standard 16-Bit-FLAC mit 44,1 kHz, Sie verlieren eine Menge Daten. Wenn Ihre WAV-Datei jedoch 8-Bit mit 22100 Samples pro Sekunde ist und Sie sie in 16-Bit-FLAC mit 44100 Samples pro Sekunde konvertieren, verlieren Sie keine Daten. Sie können die Dateigröße sogar erhöhen, je nachdem, ob Sie eine verlustfreie Komprimierung oder ein kleineres Beispielformat erhalten.

Das Sample-Format wirkt sich auf den Speicherplatz aus, den die Datei belegt, sodass “größere” Bits und eine “schnellere” Samplerate mehr Speicherplatz beanspruchen.

Wenn es um praktische Überlegungen und menschliches Gehör geht, werden Sie es nicht bemerken, wenn Sie Originale von sehr hoher Qualität mit 44,1 kHz in 16-Bit-FLAC konvertieren. Sie werden jedoch keine Verbesserung bemerken, wenn Sie MP3 in FLAC konvertieren. Daher müssen Sie bewerten, in welchem ​​Format Ihre Rohdaten vorliegen, bevor Sie entscheiden, was zu tun ist.

Verbesserte Effizienz digitaler Audiodatenkomprimierungsalgorithmen.

Verbesserte Effizienz digitaler Audiodatenkomprimierungsalgorithmen.

audio compression

Die Relevanz der Arbeit. Verfahren zum Codieren von Audiosignalen hoher Qualität (HS) sind in den letzten zehn Jahren im Bereich Rundfunk, digitale Tonaufzeichnung sowie Heim-Audio- und -Videogeräte sehr weit verbreitet. Es gibt sogar eine schnell wachsende neue Klasse von Unterhaltungselektronik: tragbare MP3-Player.

Audio Compression:

Es werden digitale Fernseh- und Radioübertragungsnetze entwickelt, die den Verbrauchern qualitativ hochwertige Bilder und Töne mit einem breiten Versorgungsbereich bieten. Die Popularität von Radio- und Fernsehsendungen über das Internet und Mobilfunknetze nimmt zu. All diese technologischen Innovationen sind dank der Verwendung hocheffizienter digitaler Video- und Audiodatenkomprimierungsalgorithmen wie MPEG-1 ISO / IEC 11172, MPEG-2 TSO / IEC wirtschaftlich rentabel und in einigen Fällen sogar technisch möglich geworden 13818, MPEG-4 ISO / IEC FCD 14496, ATSC Dolby AC-3. Gleichzeitig ist es aufgrund der wirtschaftlichen Vorteile der Verwendung dieser Algorithmen, die es ermöglichen, die Bandbreitenanforderungen der Übertragungskanäle oder die Kapazität der Informationsträger um eine Größenordnung zu verringern, mit einer gewissen Verringerung der zu kompensieren Tonqualität. In der Zeit der Dominanz digitaler Audio-CDs haben die Verbraucher von allen Tonwiedergabegeräten eine hohe Klangqualität gefordert. Die Bemühungen der Algorithmusentwickler zur Codierung von Audiosignalen waren immer darauf ausgerichtet, sicherzustellen, dass die Qualität des decodierten Audiomaterials nicht schlechter ist als die einer CD. Die Klangqualität ist häufig der entscheidende Faktor für den wirtschaftlichen Erfolg digitaler Rundfunkdienste oder digitaler Tonverteilungsdienste wie iTunes. Des Weiteren,

Es ist offensichtlich, dass das Problem der Verbesserung der Qualität der Audiocodierung heute eines der Hauptprobleme für die Tonaufzeichnungsindustrie, die Audioübertragungsindustrie und die Hersteller verschiedener Multimedia-Systeme ist.

Das Grundprinzip des Betriebs hocheffizienter Audiokodierungssysteme besteht darin, die Eigenschaften des menschlichen Hörsystems zu nutzen, hauptsächlich das Phänomen der Maskierung. Das Phänomen der psychoakustischen Maskierung beruht auf der biophysikalischen und neuronalen Verarbeitung von Schallsignalen durch das menschliche Hörsystem [173]. Gleichzeitig beeinflusst ein Teil der Schallinformationen die akustische Wahrnehmung des Schallsignals nicht, da Komponenten mit größerer Intensität vorhanden sind. Daher bilden die stärksten Komponenten des Audiosignals die sogenannten Maskierungsschwellen. Schallinformationen mit einem Signalenergieniveau unterhalb der Maskierungsschwelle werden vom auditorischen System nicht wahrgenommen. Bei der herkömmlichen digitalen Darstellung von Audiosignalen unter Verwendung von Pulscodemodulation (PCM) werden zeitabgetastete Abtastwerte des ursprünglichen Signals unter Verwendung einer bestimmten Anzahl von Bits im Codewort dargestellt. Die endliche Genauigkeit der Momentanwerte eines kontinuierlichen analogen Signals führt zu einem Fehler im Signal, dem sogenannten Quantisierungsrauschen. Die Idee, Audiosignale unter Beseitigung der psychoakustischen Redundanz zu codieren, besteht darin, die psychoakustische Analyse und den Quantisierungsmechanismus von Audiosignalen zu kombinieren [112]. In diesem Fall wird das digital codierte Signal so nahe wie möglich an der Zeit-Frequenz-Auflösung des menschlichen Hörsystems in eine Zeit-Frequenz-Darstellung umgewandelt. Die psychoakustische Analyse bestimmt die Maskierungsschwellen an jedem Punkt in der Zeit-Frequenz-Darstellung des codierten Signals, und der Quantisierer quantisiert das Signal mit der minimal möglichen Anzahl von Bits pro Abtastung neu, wobei das zunehmende Quantisierungsrauschen auftritt immer noch unter den Maskierungsschwellen. Somit kann eine kompakte Darstellung von Audiosignalen ohne subjektive Verschlechterung der Klangqualität erreicht werden. Es ist offensichtlich, dass die Effizienz und Qualität solcher Systeme hauptsächlich von der Präzision der psychoakustischen Analyse abhängt. Eine kompakte Darstellung von Audiosignalen kann ohne subjektive Verschlechterung der Klangqualität erreicht werden. Es ist offensichtlich, dass die Effizienz und Qualität solcher Systeme hauptsächlich von der Präzision der psychoakustischen Analyse abhängt. Eine kompakte Darstellung von Audiosignalen kann ohne subjektive Verschlechterung der Klangqualität erreicht werden. Es ist offensichtlich, dass die Effizienz und Qualität solcher Systeme hauptsächlich von der Präzision der psychoakustischen Analyse abhängt.