mp3-Audioformat, das beliebteste


Free Download Mp4Gain
picture

mp3-Audioformat, das beliebteste
mp3 audio format

Mit der rasanten Entwicklung der Dateikomprimierungstechnologie ist MP3 heute zum beliebtesten Musikformat geworden.
mp3 audio format

Hochwertige Musik verbreitet sich mit dem Arrangement von 0 und 1 schnell in alle Teile der Welt und erschüttert die Herzen der Menschen. Was ist MP3? Der vollständige Name von MP3 lautet MPEG Audio Layer 3. Es ist ein effizientes Computer-Audiocodierungsschema, das Audiodateien in kleinere Dateien mit der Erweiterung .MP3 mit einer höheren Komprimierungsrate konvertiert und im Wesentlichen die Klangqualität der Originaldatei beibehält. MP3 ist Teil des ISO/MPEG-Standards. Der ISO/MPEG-Standard beschreibt die Audiokomprimierung unter Verwendung eines hochleistungsfähigen Wahrnehmungscodierungsschemas. Dieser Standard wurde kontinuierlich aktualisiert, um dem Streben nach “hoher Qualität und kleiner Quantität” gerecht zu werden, und hat nun MPEG Layer 1, Layer 2, Layer 3 drei Audiocodierungs- und -decodierungsschemata gebildet. Die Kompressionsrate von MPEG Layer 3 kann von 1:10 bis 1:12 reichen. Eine 1 MB große MP3-Datei kann 1 Minute lang abgespielt werden, während eine 1 Minute lange WAV-Datei in CD-Qualität (44100 Hz, 16 Bit, 2 Kanäle, 60 Sek.) 10 MB Speicherplatz belegt, also sollte die Zeit berechnet werden. Die Wiedergabezeit einer 650 MB MP3-Disc sollte länger sein als 10 Stunden, während die Wiedergabezeit einer CD mit der gleichen Kapazität etwa 70 Minuten beträgt. Die Vorteile von MP3 werden von CD nicht erreicht. 2 Analyse des Prinzips von MP3 2.1 MPEG-Audiostandard MPEG (Moving Picture Experts Group) ist eine Expertengruppe für bewegte Bilder unter ISO, und der von ihr formulierte MPEG-Standard ist in verschiedenen Multimediabereichen weit verbreitet. MPEG-Standards umfassen Video- und Audiostandards, unter denen MPEG-1-, MPEG-2-, MPEG-2-AAC- und MPEG-4-Audiostandards entwickelt wurden. Die MPEG-1- und MPEG-2-Standards verwenden die gleiche Familie von Audio-Codecs: Layer 1, 2 und 3. Eine neue Funktion von MPEG-2 ist die Verwendung von Erweiterungskits mit niedriger Abtastrate, um den Datenverkehr zu reduzieren, und eine weitere Funktion ist die Mehrkanal-Erweiterungskit, das die Anzahl der Hauptkanäle auf fünf erhöht. Fraunhofer IIS und AT&T veröffentlichten 1997 den Standard MPEG-2 AAC (MPEG-2 Advanced Audio Coding), um den Datenverkehr deutlich zu reduzieren. Der von MPEG-2 AAC übernommene MDCT-Algorithmus (Modified Discrete Cosine Transform). Die Abtastfrequenz kann zwischen 8 KHz und 96 KHz liegen, und die Anzahl der Kanäle kann zwischen 1 und 48 liegen. MPEG Audio Layer 1, 2 und 3 verwenden die gleiche Filterbank, Bitstream-Struktur und Header-Informationen, und die Abtastrate beträgt entweder 32 KHz, 44,1 KHz oder 48 KHz. Schicht 1 ist für digitales Kompressionsband DCC (Digital Compact Cassette) ausgelegt, die Datenrate beträgt 384 kbps, und Schicht 2 ist ein Kompromiss zwischen Komplexität und Leistung eingegangen, und die Datenrate wurde auf 256 kbps bis 192 kbps reduziert. Layer 3 wurde von Anfang an für niedrige Datenraten entwickelt, und die Datenrate beträgt 128 Kbps-112 Kbps. Layer 3 fügt MDCT-Transformation hinzu, wodurch seine Frequenzauflösung 18-mal höher ist als die von Layer 2. Layer 3 verwendet auch Informationsmittelung ähnlich wie MPEG Video-Entropie-Codierung zur Reduzierung redundanter Informationen. Die überwiegende Mehrheit von MP3 verwendet den MPEG-1-Standard. 2.2 Der Zweck der Audiokomprimierung Das MP3-Format begann Mitte der 1980er Jahre, und das Fraunhofer-Institut in Erlangen, Deutschland, engagierte sich für eine hochwertige Audiocodierung mit niedriger Datenrate. Schauen wir uns ein Beispiel an: Sie möchten einen etwa 4 Minuten langen Song Ihrer Wahl sampeln, auf einer Disc speichern und im WAV-Format in CD-Qualität mit einer Abtastrate von 44,1 kHz sampeln, was bedeutet, dass Sie 44100 pro Sekunde empfangen . , Stereo, jede Sample-Datengröße beträgt 16 Bit (2 Byte), der von diesem Song belegte Speicherplatz beträgt also: 44100 x 2 Kanäle x 2 Byte x 60 Sekunden x 4 Minuten = 40,4 MB Wenn Sie diesen Song aus dem Internet herunterladen, gehen Sie davon aus, dass die Übertragungsgeschwindigkeit 56 kbps beträgt , die Downloadzeit beträgt: 40,4 x 106 x 8/56 x 103 x 60 = 96 Minuten. Selbst ein 1M-Breitbandnetz benötigt mehr als 5 Minuten. Es ist ersichtlich, dass die Audiokomprimierung besonders wichtig ist, um den Speicherplatz von Audiodaten zu reduzieren. 2.3 MP3-Codierung und -Decodierung Die MP3-Audiokomprimierung umfasst die Codierung und Decodierung in zwei Teilen. Beim Codieren werden die Daten in einer WAV-Datei in einen stark komprimierten Bitstream umgewandelt, und beim Decodieren wird der Bitstream genommen und in eine WAV-Datei rekonstruiert. MP3 verwendet einen Verzerrungsalgorithmus namens Perceptual Audio Coding. Der Frequenzbereich des vom menschlichen Ohr wahrgenommenen Schalls reicht von 20 Hz bis 20 kHz. MP3 schneidet viele redundante und irrelevante Signale heraus.
Free Download Mp4Gain
picture

MP3-Encoder

MP3-Encoder

Mp3 Encoder

1. Häufig gestellte Fragen zum MP3-Encoder

Mp3 Encoder

: Was ist ein MP3-Encoder?
Ein MP3-Encoder ist eine Software, die den MP3-Codec-Algorithmus (Komprimierung/Dekomprimierung) verwendet, um MP3-Dateien zu erstellen. Die meisten Encoder konvertieren nur
eine WAV-Datei in eine MP3-Datei, obwohl viele andere Formate wie WMA, Real Audio, Ogg usw. konvertieren können.

Es gibt nur wenige eigenständige Encoder, und viele Software verwendet auch nur 4 Hauptcodierungs-Engines, hauptsächlich aufgrund von
Patente der Fraunhofer Gesellschaft und verschiedene Unternehmen, die mit ISO-Quellen helfen. Obwohl kein Unternehmen die Lizenz besitzt, die
Entwickler müssen teure Lizenzgebühren bezahlen, egal welchen proprietären MP3-Encoder sie verwenden. Zu den wichtigsten MP3-Encoding-Engines gehören: LAME (
Nicht-ISO-Quelle), BladeEnc, Fraunhofer und Xing-Encoder von Real Networks.

– Wie funktioniert der MP3-Encoder?
Die Kerntechnologie unter MPEG-Layer 3 ist im MP3-Encoder enthalten. Der Dekodierungsprozess verwendet eine Reihe von Algorithmen und Regeln, um Audio zu komprimieren.
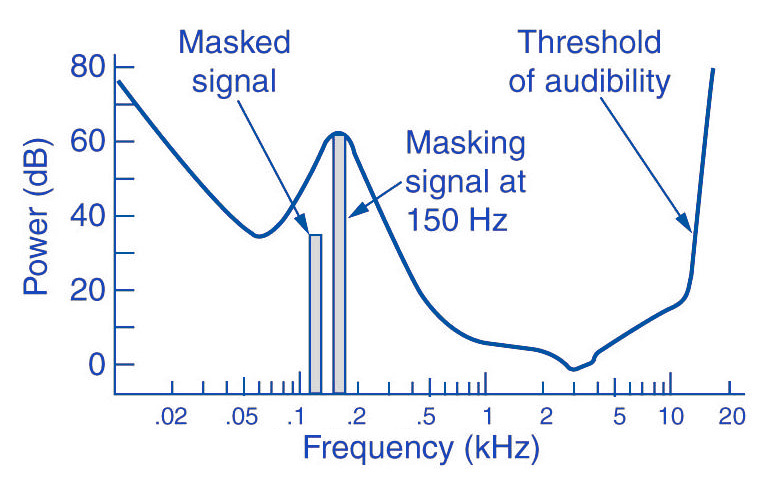
Der Encoder erkennt auch Geräusche, die gleichzeitig auftreten
und sie versuchen, alle auszuschließen, die durch andere Geräusche “maskiert” oder “unhörbar” sein könnten.

– Was ist ein guter MP3-Encoder?
Xing ist der schnellste Encoder in Bezug auf die Geschwindigkeit, aber der schlechteste in der Qualität. Für kleinere Dateigrößen bietet Fraunhofer FastEnc
bietet die beste Qualität. LAME ist ein sehr guter Encoder, und eine Version ist schneller als die vorherige, BladeEnc
es ist die beste Qualität für große Dateien, aber sehr langsam.

2. Dissektion von MP3-Dateien
Neben der Beherrschung der grundlegenden Funktionen des MP3-Encoders müssen normale Benutzer nicht wissen, wie die interne Struktur der MP3-Datei codiert ist, genau wie die Situation, wenn
face JPEG- oder DOC-Dateien. Aus morbider Neugier hier eine Röntgenansicht einer MP3-Datei:

– Boxkopf
Wie oben erwähnt, bestehen MP3-Dateien aus Tausenden von „Frame Frames“, wobei jeder Frame einen Teil (zweiten Teil) wertvoller Audiodaten enthält.
damit der Decoder die Audiodaten rekonstruieren kann. Der erste Teil oben ist der Box-Header. (Frame Header), der aus 32-Bit-Metadaten besteht, die sich auf die beziehen
spätere Daten, siehe Abbildung unten. Der MP3-Header beginnt mit einem 11-Bit-„Sync-Timing“-Block, der es dem Player ermöglicht, den ersten zu suchen und zu sperren
rechtlicher Rahmen verfügbar, der beim MP3-Streaming nützlich ist und ID3 schnell vom Wiedergabequellblock zu einem normalen verschieben oder springen kann.
Stellung . Das bloße Erkennen von synchronisierten Blöcken reicht jedoch theoretisch nicht aus, sodass eine Überprüfung des Headers erforderlich ist.

– Übertragungssperre
MP3 wurde ursprünglich für den Rundfunk entwickelt, und daher wurde es wichtig, dass der MP3-Empfänger an jedem Teil der Sendung mit dem Signal synchronisiert werden kann.
Der Frame-Header wird also am Anfang jeder Frame-Übertragung platziert. Wenn sich ein MP3-Empfänger auf einen Datenstrom „einstellt“, nimmt er den auf
Signal sofort und Sie können es sofort spielen. Interessanterweise ermöglicht es diese Tatsache, MPEG-Dateien in kleine Segmente zu schneiden, von denen jedes unabhängig abgespielt werden kann. Aber leider
nicht möglich in 3-Layer-Dateien (MP3), bei denen Frames oft von anderen Frames abhängen, also können Sie nicht einfach
Bearbeiten .

– Bilder pro Sekunde
So wie die Filmindustrie einen Standard für die Anzahl der Bilder pro Sekunde im Film hat, um eine korrekte Anzeige auf jedem Projektor zu gewährleisten,
Ein ähnlicher Standard wird im MP3-Standard verwendet, unabhängig von der Bitrate der Datei, MPEG-1 Ein Frame in der Datei hat 26 ms, ungefähr 38 fps Frames pro Sekunde. Wenn die Bitrate
ist, ist die Rahmengröße entsprechend größer und umgekehrt. Außerdem ist die Anzahl der in einem MP3-Frame enthaltenen Samples konstant, 1152 Samples pro Frame.

Die Gesamtgröße eines bestimmten Rahmens kann mit der folgenden Formel berechnet werden:

FrameSize = 144 * BitRate / (SampleRate + Padding).

MP3 codieren

MP3 codieren

encoding mp3

Was ist Maskierung?

mp3 encoding


Der verlustbehaftete MP3-Audiokomprimierungsalgorithmus verwendet eine Einschränkung der menschlichen Hörwahrnehmung, die als auditive Maskierung bezeichnet wird. 1894 berichtete der amerikanische Physiker Alfred M. Mayer, dass ein Ton durch einen anderen Ton mit niedrigerer Frequenz unhörbar gemacht werden könnte. 1959 beschrieb Richard Amer einen vollständigen Satz von Hörkurven, die mit diesem Phänomen zusammenhängen. Zwischen 1967 und 1974 arbeitete Eberhard Zwicker an der Abstimmung und Maskierung kritischer Frequenzbänder, die wiederum auf der Grundlagenforschung von Harvey Fletcher und seinen Mitarbeitern bei Bell Labs in diesem Bereich aufbauten. Perceptual Coding wurde erstmals 1966 verwendet, um die Sprachcodierung mit Linear Prediction Coding (LPC) zu komprimieren, die ihren Ursprung in den Werken Fuminada Itakura (Nagoya University) und Shuji Saito (von Nippon Telegraph and Telephone) hat. 1978 schlugen Bishnu S. Atal und Manfred R. Schroeder von Bell Labs einen LPC-Sprachcodec vor, der als adaptive prädiktive Codierung bezeichnet wird. , die einen psychoakustischen Codierungsalgorithmus unter Verwendung der Maskierungseigenschaften des menschlichen Ohrs verwendeten. Die weitere Optimierung von Schroeder und Atal mit J.L. Hall wurde später in einem Artikel von 1979 beschrieben. Im selben Jahr wurde M.A. Krasner schlug einen psychoakustischen Maskierungscodec vor, der Hardware für Sprache veröffentlichte und produzierte (nicht zum Komprimieren von Musikstücken verwendet), aber die Veröffentlichung seiner Ergebnisse in einem relativ undurchsichtigen technischen Bericht des Lincoln Laboratory hatte keinen unmittelbaren Einfluss auf den Mainstream des Entwicklung psychoakustischer Codecs. Die von Nasir Ahmed 1972 vorgeschlagene diskrete Cosinustransformation (DCT), eine Art Transformationscodierung für verlustbehaftete Komprimierung, wurde 1973 von Ahmed mit T. Natarajan und KR Rao entwickelt. veröffentlichten ihre Ergebnisse 1974. Dies führte zur Entwicklung der Modified Discrete Cosine Transform (MDCT), die JP Princen, AW Johnson und AB Bradley 1987 nach früheren Arbeiten von Princen und Bradley 1986 vorgeschlagen hatten. MDCT wurde später der Hauptteil des MP3-Algorithmus. Ernst Terhardt et al. Entwickelten 1982 einen Algorithmus, der die auditive Maskierung mit hoher Präzision beschreibt. Diese Arbeit ergänzt viele Berichte von Autoren, die auf Fletcher zurückgehen, sowie Arbeiten, die ursprünglich kritische Verhältnisse und kritische Bandbreite definiert haben. 1985 führten Atal und Schroeder Code Excited Linear Prediction (CELP) ein, einen LPC-basierten Algorithmus für die auditive Maskierung der Wahrnehmungs-Sprachcodierung, der für seine Zeit einen signifikanten Grad an Datenkomprimierung erreichte. Die von Experten begutachtete IEEE-Zeitschrift “Favorite Communications” berichtete 1988 über eine Vielzahl von Audiokomprimierungsalgorithmen (hauptsächlich Wahrnehmungsalgorithmen). Die Februarausgabe 1988 von Voice Coding for Communication berichtete über eine Vielzahl von Audiokomprimierungsalgorithmen bitbasiert etabliert und betriebsbereit. Technologien, von denen einige die auditive Maskierung als Teil ihres Kerndesigns verwenden und einige Echtzeit-Hardware-Implementierungen zeigen. – https://ru.qaz.wiki/wiki/MP3

PRINZIPIEN DES MP3-FORMATS ENCODIEREN.

PRINZIPIEN DES MP3-FORMATS ENCODIEREN.

Mp3 Encoding

MP3 oder MPEG-1, 2 und 2.5 Layer 3 ist einer der beliebtesten und am weitesten verbreiteten Standards zum Speichern von Audiodaten.

MP3 ENCODING

In diesem Artikel werden wir uns nicht mit der Geschichte der Entstehung und Weiterentwicklung befassen, sondern die Grundprinzipien des Standards und Beispiele für dessen Umsetzung betrachten.

Der MP3-Standard legt keinen spezifischen Komprimierungsalgorithmus zum “Codieren” der Quelldaten fest, sondern beschreibt das Wesentliche der möglichen Methoden.

Die Qualität des erhaltenen Ergebnisses hängt von der Modifikation des verwendeten Algorithmus ab, der in ein beliebiges Codierungsprogramm des “Codecs” eingebettet ist, und von der Qualität der ursprünglichen Audiodaten.

Es gibt 3 häufigste Änderungen des MP3-Formats, die sich in den Komprimierungsverhältnisparametern der ursprünglichen Audiodaten unterscheiden.

Name
Änderung der Regel
Datenrate pro Sekunde (Bitrate) Mögliche Abtastraten
MPEG-1-Schicht 3
32 – 320 kbps 32000 Hz
44100 Hz
48000 Hz
MPEG-2 Layer 3 16 – 160 kbps 16000 Hz
22050 Hz
24000 Hz
MPEG-2.5 Layer 3 8 – bis zu 160 kbps 8000 Hz
11025 Hz

Die Verarbeitung beginnt mit der Aufteilung des ursprünglichen Audiosignals in gleiche Zeitintervalle: gleiche Bilder, beispielsweise 0,05 oder 0,26 Sekunden, wonach jedes Bild nach allgemeinen oder individuellen Parametern analysiert und komprimiert wird basierend auf den Daten des vorherigen und nächsten Frames.

Die meisten verwendeten Komprimierungsalgorithmen basieren auf den Wahrnehmungseigenschaften des menschlichen Ohrs. Betrachten wir die Hauptoptionen, die in der Regel auf komplexe Weise angewendet werden.

Es lohnt sich, mit der Tatsache zu beginnen, dass die durchschnittliche Person nach Gehör einen Frequenzbereich von ungefähr 10 Hz bis 20.000 Hz wahrnehmen kann. Mit dem Wachstum treten Änderungen im Hörgerät und für die meisten in der Empfindlichkeit auf Der höhere Frequenzbereich nimmt ab, wodurch bei einigen MP3-Modifikationen während der Komprimierung alle Frequenzen über 16000 Hertz abgeschnitten werden, was die Informationsmenge erheblich reduzieren kann.

Audioaufnahmen können in Stereo (ein Surround-Sound-Effekt, der separate Kanäle für den linken und rechten Lautsprecher verwendet) oder Mono (das Gegenteil von Stereo) codiert werden. Im MP3-Format werden nicht für jeden Ihrer Lautsprecher unterschiedliche Titel aufgezeichnet, sondern Informationen zu den Unterschieden zwischen dem linken und dem rechten Kanal.

In der Akustik gibt es ein Konzept wie “Harmonische”, dies sind die Frequenzen der “Klänge”, die zusammen mit dem Haupt- und dem prominentesten Ton klingen. Wenn Sie beispielsweise auf eine Trommel schlagen, ist der lauteste Klang der Ton und der kleinere, schwächere Klang die Harmonischen.

Nach einem so lauten Geräusch tritt die sogenannte “Periode der Taubheit” während eines Zeitraums auf, in dem das Gehör einer Person praktisch nicht auf Veränderungen reagiert.

Wenn in den Intervallen der “Taubheitsperiode” alle Frequenzen entfernt werden, können die Wahrnehmungsfehler ihre Abwesenheit praktisch nicht bemerken, da während der Komprimierung die schwächsten Harmonischen abgeschnitten werden, die sich in der Nähe der meisten Töne befinden. stark: Töne.

Ein Verfahren wird verwendet, um die Nahspitzenwerte des Signals “Spitzen” (in Bezug auf das Volumen) durch einen Durchschnittswert zu ersetzen.

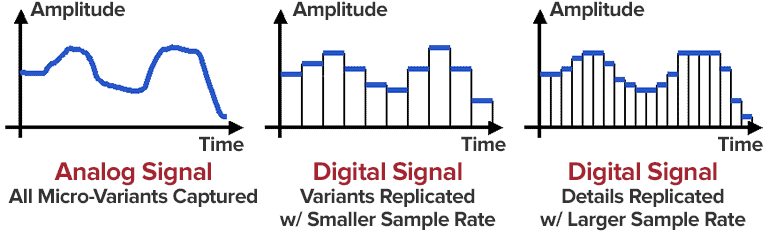
Es gibt ein Konzept als Bitrate: Dies ist ein Wert, der die Anzahl der übertragenen Informationsbits “Einheiten” während eines Zeitraums, normalerweise einer Sekunde, kennzeichnet.
Je höher die Bitrate, desto besser sind die Audiodetails, solange die ursprünglichen, nicht komprimierten Audiodaten von hoher Qualität sind.

Wie Sie sich vorstellen können, bestehen digitale Formate aus bestimmten Codesequenzen, dh aus den Sequenzen 0 und 1.
Um Platz zu sparen, werden häufigen Verknüpfungen innerhalb einer Datei eindeutige Bezeichner zugewiesen, die lange Sequenzen ersetzen.

Dank dieser komplexen Einflüsse ist es möglich, das ursprüngliche Audiosignal mit Qualitätsverlust in eines der gängigen Formate zu komprimieren – das MP3-Format.

Verschiedene Experimente wurden viele Male durchgeführt, um zu zeigen, wie signifikant die Unterschiede vor und nach der Komprimierung in mp3 sind. Wie Tests gezeigt haben, waren Unterschiede, einige ähnliche Momente nicht immer möglich, schnell und zu unterscheiden, selbst wenn sie auf Geräten mit höherer Wiedergabetreue reproduziert wurden.

Für diejenigen, die noch nie die Möglichkeit hatten, die ursprüngliche und komprimierte Audioaufnahme direkt zu vergleichen, wird es in den meisten Fällen einige Zeit dauern oder sogar offensichtliche Unterschiede feststellen.