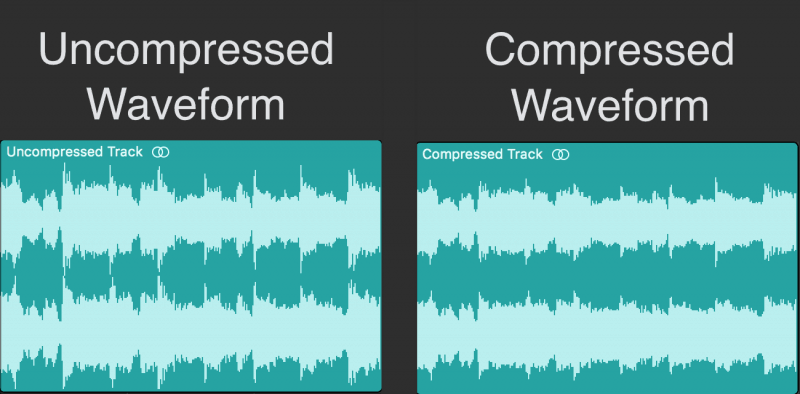
Digitale Audiokomprimierung

Die Komprimierung von Audiodaten ist heute ein echtes Problem. Es gibt zwei Gründe für die Notwendigkeit, Audiodaten zu komprimieren: Speichereinsparungen beim Speichern von Audioinformationen, geringe Bandbreite der digitalen Fernübertragungskanäle für Informationen. Die Komprimierung löst effektiv die beiden oben genannten Probleme. Die Datenkomprimierung ist eine algorithmische Transformation von Daten, die durchgeführt wird, um deren Volumen zu reduzieren.

Es wird für eine rationellere Verwendung von Datenspeicherungs- und -übertragungsgeräten verwendet. Die Komprimierung basiert auf der Beseitigung der in den Originaldaten enthaltenen Redundanz. Um die für die Übertragung von Sprachsignalen (Musik) über moderne digitale Kommunikationskanäle mit niedriger Geschwindigkeit erforderlichen Parameter zu gewährleisten und die angegebene Störfestigkeit zu gewährleisten, müssen hocheffiziente Datenkomprimierungsalgorithmen verwendet werden. Der Übertragungskanal zeichnet sich durch ein Konzept wie die Kapazität des Kanals aus: Und das Signal – durch die Lautstärke (Signal): …
Beide oben genannten Merkmale umfassen den Dynamikbereich D, die Kanalbreite (Signalspektrum) und die Laufzeit T. Digitale Audiokompressoren werden verwendet, um den Dynamikbereich zu verringern. Um die spektrale Effizienz zu verbessern, werden digitale Filter verwendet, um das Spektrum des Encoder-Ausgangssignals zu begrenzen (gemäß Nyquist-Kriterien). Unter anderem werden Codierer verwendet, die auf den Prinzipien der Beseitigung von Redundanz (Huffman-Codes) basieren, um eine bestimmte Informationsübertragungsgeschwindigkeit zu gewährleisten. Das Wesentliche davon ist wie folgt: Codes, die auf dem Prinzip basieren, wahrscheinlichere Werte der Amplituden der Codewörter mit kürzerer Länge als die unwahrscheinlichen zuzuweisen.
Betrachten wir, wie die oben beschriebenen Redundanztypen beseitigt werden.
Struktur eines verlustbehafteten Audiokomprimierungscodierers Das ursprüngliche digitale Audiosignal wird in Frequenzteilbänder unterteilt und zeitlich in einen Zeit-Frequenz-Segmentierungsblock segmentiert. Die Länge des codierten Samples hängt von der Form der zeitlichen Funktion des Audiosignals ab. In Abwesenheit scharfer Amplitudenspitzen wird eine lange Probe verwendet, die eine hochfrequente Auflösung liefert. Bei abrupten Änderungen der Signalamplitude nimmt die Länge der codierten Probe dramatisch ab, was zu einer höheren Zeitauflösung führt. Die Entscheidung, die Länge der codierten Probe zu ändern, wird von der psychoakustischen Analyseeinheit getroffen, die den Wert der psychoakustischen Entropie des Signals berechnet.
Nach der Segmentierung werden die Frequenzteilbandsignale normalisiert, quantisiert und codiert. Bei den effizientesten Komprimierungsalgorithmen werden nicht die Abtastwerte des Audiosignals codiert, sondern die entsprechenden MDCT-Koeffizienten. (Die Differenz zwischen den Koeffizienten ist kleiner.) Die Abrechnung der auditorischen Wahrnehmungsmuster eines Tonsignals erfolgt in der psychoakustischen Analyseeinheit. Hier wird nach einem speziellen Verfahren für jedes Frequenzteilband der maximal zulässige Pegel der Quantisierungsverzerrung (Rauschen) berechnet, in dem sie noch durch das Nutzsignal dieses Teilbandes maskiert sind.
Der Block der dynamischen Verteilung von Bits gemäß den Anforderungen des psychoakustischen Modells für jedes codierende Teilband wählt eine minimal mögliche Anzahl von ihnen aus, bei denen der Grad der durch die Quantisierung verursachten Verzerrungen den vom Modell berechneten Schwellenwert ihrer Hörbarkeit nicht überschreitet psychoakustisch.
In diesem Artikel werden die Funktionsdiagramme der Audiodatenkomprimierungsalgorithmen basierend auf den µ-Gesetzen A betrachtet. Das Funktionsdiagramm des Komprimierungsalgorithmus basierend auf dem A-Level-Komprimierungsgesetz ist in Abb. 2 dargestellt. Abbildung 2. Funktionsdiagramm des Komprimierungsalgorithmus basierend auf dem A-Pegel-Komprimierungsgesetz Ein Signal (diskreter Sinus) wird an den Eingang des Kompressors angelegt. Nach der Komprimierung gelangt das Signal zum Addierer, wo das Rauschen dem zweiten Eingang des Addierers zugeführt wird, wodurch das additive Rauschen des Übertragungskanals simuliert wird.
Dann tritt das verrauschte Signal in den Eingang des Expanders ein, am Ausgang erhalten wir das rekonstruierte Signal. Das rekonstruierte und ursprüngliche Signal wird dann dem Addierer zugeführt, wonach die Leistung des spektralen Rauschens beobachtet wird.
Simulationsergebnisse (A = 87,6)
Die folgenden Grafiken werden dargestellt: 1 Originalsignal, 2 durch den Kompressor geleitete Signale, 3 wiederhergestellte Signale, 4 Rauschleistungen am Ausgang des Rauschgenerators, 5 Rauschleistungen nach dem Expander.