Digitale Audiokomprimierung


Free Download Mp4Gain
picture

Digitale Audiokomprimierung

Digital Audio Compression

Die Komprimierung von Audiodaten ist heute ein echtes Problem. Es gibt zwei Gründe für die Notwendigkeit, Audiodaten zu komprimieren: Speichereinsparungen beim Speichern von Audioinformationen, geringe Bandbreite der digitalen Fernübertragungskanäle für Informationen. Die Komprimierung löst effektiv die beiden oben genannten Probleme. Die Datenkomprimierung ist eine algorithmische Transformation von Daten, die durchgeführt wird, um deren Volumen zu reduzieren.

Data Compression

Es wird für eine rationellere Verwendung von Datenspeicherungs- und -übertragungsgeräten verwendet. Die Komprimierung basiert auf der Beseitigung der in den Originaldaten enthaltenen Redundanz. Um die für die Übertragung von Sprachsignalen (Musik) über moderne digitale Kommunikationskanäle mit niedriger Geschwindigkeit erforderlichen Parameter zu gewährleisten und die angegebene Störfestigkeit zu gewährleisten, müssen hocheffiziente Datenkomprimierungsalgorithmen verwendet werden. Der Übertragungskanal zeichnet sich durch ein Konzept wie die Kapazität des Kanals aus: Und das Signal – durch die Lautstärke (Signal): …

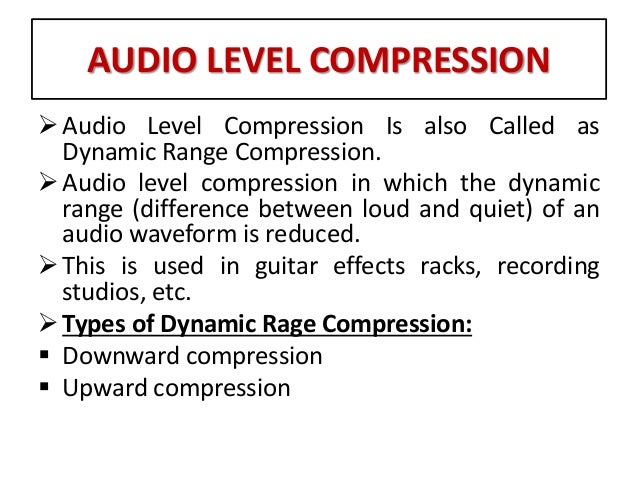
Beide oben genannten Merkmale umfassen den Dynamikbereich D, die Kanalbreite (Signalspektrum) und die Laufzeit T. Digitale Audiokompressoren werden verwendet, um den Dynamikbereich zu verringern. Um die spektrale Effizienz zu verbessern, werden digitale Filter verwendet, um das Spektrum des Encoder-Ausgangssignals zu begrenzen (gemäß Nyquist-Kriterien). Unter anderem werden Codierer verwendet, die auf den Prinzipien der Beseitigung von Redundanz (Huffman-Codes) basieren, um eine bestimmte Informationsübertragungsgeschwindigkeit zu gewährleisten. Das Wesentliche davon ist wie folgt: Codes, die auf dem Prinzip basieren, wahrscheinlichere Werte der Amplituden der Codewörter mit kürzerer Länge als die unwahrscheinlichen zuzuweisen.

Betrachten wir, wie die oben beschriebenen Redundanztypen beseitigt werden.
Struktur eines verlustbehafteten Audiokomprimierungscodierers Das ursprüngliche digitale Audiosignal wird in Frequenzteilbänder unterteilt und zeitlich in einen Zeit-Frequenz-Segmentierungsblock segmentiert. Die Länge des codierten Samples hängt von der Form der zeitlichen Funktion des Audiosignals ab. In Abwesenheit scharfer Amplitudenspitzen wird eine lange Probe verwendet, die eine hochfrequente Auflösung liefert. Bei abrupten Änderungen der Signalamplitude nimmt die Länge der codierten Probe dramatisch ab, was zu einer höheren Zeitauflösung führt. Die Entscheidung, die Länge der codierten Probe zu ändern, wird von der psychoakustischen Analyseeinheit getroffen, die den Wert der psychoakustischen Entropie des Signals berechnet.
Nach der Segmentierung werden die Frequenzteilbandsignale normalisiert, quantisiert und codiert. Bei den effizientesten Komprimierungsalgorithmen werden nicht die Abtastwerte des Audiosignals codiert, sondern die entsprechenden MDCT-Koeffizienten. (Die Differenz zwischen den Koeffizienten ist kleiner.) Die Abrechnung der auditorischen Wahrnehmungsmuster eines Tonsignals erfolgt in der psychoakustischen Analyseeinheit. Hier wird nach einem speziellen Verfahren für jedes Frequenzteilband der maximal zulässige Pegel der Quantisierungsverzerrung (Rauschen) berechnet, in dem sie noch durch das Nutzsignal dieses Teilbandes maskiert sind.

Der Block der dynamischen Verteilung von Bits gemäß den Anforderungen des psychoakustischen Modells für jedes codierende Teilband wählt eine minimal mögliche Anzahl von ihnen aus, bei denen der Grad der durch die Quantisierung verursachten Verzerrungen den vom Modell berechneten Schwellenwert ihrer Hörbarkeit nicht überschreitet psychoakustisch.

In diesem Artikel werden die Funktionsdiagramme der Audiodatenkomprimierungsalgorithmen basierend auf den µ-Gesetzen A betrachtet. Das Funktionsdiagramm des Komprimierungsalgorithmus basierend auf dem A-Level-Komprimierungsgesetz ist in Abb. 2 dargestellt. Abbildung 2. Funktionsdiagramm des Komprimierungsalgorithmus basierend auf dem A-Pegel-Komprimierungsgesetz Ein Signal (diskreter Sinus) wird an den Eingang des Kompressors angelegt. Nach der Komprimierung gelangt das Signal zum Addierer, wo das Rauschen dem zweiten Eingang des Addierers zugeführt wird, wodurch das additive Rauschen des Übertragungskanals simuliert wird.

Dann tritt das verrauschte Signal in den Eingang des Expanders ein, am Ausgang erhalten wir das rekonstruierte Signal. Das rekonstruierte und ursprüngliche Signal wird dann dem Addierer zugeführt, wonach die Leistung des spektralen Rauschens beobachtet wird.

Simulationsergebnisse (A = 87,6)
Die folgenden Grafiken werden dargestellt: 1 Originalsignal, 2 durch den Kompressor geleitete Signale, 3 wiederhergestellte Signale, 4 Rauschleistungen am Ausgang des Rauschgenerators, 5 Rauschleistungen nach dem Expander.


Free Download Mp4Gain
picture

Audiokomprimierung

Audiokomprimierung

Audio Compression

Gut etablierte Datenkomprimierungsmethoden wie RLE, Statistik- und Wörterbuchmethoden können verwendet werden, um verlustfreie Audiodateien zu komprimieren. Das Ergebnis hängt jedoch stark von den spezifischen Audiodaten ab. Einige Sounds werden mit RLE gut komprimiert, mit statistischen Algorithmen jedoch schlecht. Die statistische Komprimierung ist besser für andere Sounds geeignet, bei einem Wörterbuchansatz kann jedoch eine Erweiterung auftreten. Hier finden Sie eine kurze Übersicht über die Wirksamkeit dieser drei Methoden zum Komprimieren von Audiodateien.

Audio Compression

RLE funktioniert gut mit Sounds, die lange Serien sich wiederholender Sound Chunks enthalten – Samples. Bei 8-Bit-Abtastung kann dies ziemlich häufig vorkommen. Denken Sie daran, dass die Spannungsdifferenz zwischen zwei 8-Bit-Abtastwerten n und n – 1 ungefähr 4 mV beträgt. Einige Sekunden homogener Musik, bei der sich die Schallwelle um weniger als 4 mV ändert, erzeugen eine Folge von Tausenden identischer Samples. Bei der 16-Bit-Abtastung sind offensichtlich lange Wiederholungen weniger häufig und daher ist der RLE-Algorithmus weniger effizient.

Statistische Methoden weisen Audio-Samples Codes mit variabler Länge entsprechend ihrer Häufigkeit zu. Bei 8-Bit-Sampling gibt es nur 256 verschiedene Samples, sodass die Samples gleichmäßig in einer großen Audiodatei verteilt werden können. Eine Datei dieses Typs kann mit der Huffman-Methode nicht gut komprimiert werden. Bei 16-Bit-Sampling sind mehr als 65.000 Soundbits zulässig. In diesem Fall sind einige Proben möglicherweise häufiger und andere weniger häufig. Mit einem starken Wahrscheinlichkeitsversatz können mit Hilfe der arithmetischen Codierung gute Ergebnisse erzielt werden.

Wörterbuchbasierte Methoden setzen voraus, dass einige Phrasen häufig in der Datei vorkommen. Dies geschieht in einer Textdatei, in der einzelne Wörter oder Sequenzen davon viele Male wiederholt werden. Der Ton ist jedoch ein analoges Signal und die Werte der spezifisch erzeugten Abtastwerte hängen stark vom Betrieb des ADC ab. Beispielsweise wird bei einer 8-Bit-Abtastung eine 8-mV-Wellenform zu einer numerischen Abtastung von 2, aber eine nahegelegene Welle von beispielsweise 7,6 mV oder 8,5 mV kann in eine andere Zahl umgewandelt werden. Aus diesem Grund können sich Sprachausschnitte, die überlappende Phrasen enthalten und für uns gleich klingen, beim Digitalisieren geringfügig unterscheiden. Dann geben sie das Wörterbuch in Form verschiedener Phrasen ein, die nicht die erwartete Komprimierung ergeben. Daher sind Wörterbuchmethoden für die Audiokomprimierung nicht sehr geeignet.

Sie können bessere Ergebnisse bei verlustbehafteter Audiokomprimierung erzielen, indem Sie Komprimierungstechniken entwickeln, die die Wahrnehmung von Klang berücksichtigen. Sie entfernen den Teil der Daten, der für das Publikum unhörbar bleibt. Es ist wie das Komprimieren von Bildern und das Verwerfen von Informationen, die für das Auge unsichtbar sind. In beiden Fällen gehen wir davon aus, dass die Originalinformationen (Bild oder Ton) analog sind, dh ein Teil der Informationen ist bereits während der Quantisierung und Digitalisierung verloren gegangen. Wenn Sie vorsichtig etwas mehr Verlust zulassen, wird die Qualität der unkomprimierten Klangwiedergabe nicht beeinträchtigt, was sich nicht wesentlich vom Original unterscheidet. Wir werden kurz zwei Ansätze beschreiben, die als Stilleunterdrückung und Verdichtung bezeichnet werden.

Die Idee hinter der Unterdrückung der Stille besteht darin, kleine Proben so zu behandeln, als wären sie nicht da (dh sie sind Null). Eine solche Nullung erzeugt eine Reihe von Nullen, so dass das Verfahren zum Unterdrücken von Pausen tatsächlich eine Variante von RLE ist, die an die Audiokomprimierung angepasst ist. Diese Methode basiert auf der Besonderheit der Schallwahrnehmung, die aus der Toleranz des menschlichen Ohrs besteht, kaum hörbare Geräusche auszuschließen. Audiodateien mit langen, leisen Tonabschnitten werden mit der Stilleunterdrückungsmethode besser komprimiert als Dateien mit lauten Tönen. Diese Methode erfordert die Teilnahme des Benutzers, der die Parameter steuert, die die Lautstärkeschwelle für die Samples festlegen. Dies erfordert zwei weitere Parameter, die nicht unbedingt vom Benutzer gesteuert werden. Ein Parameter wird verwendet, um die kürzesten Sequenzen stiller Samples zu bestimmen, normalerweise 2 oder 3. Der zweite Parameter legt die kleinste Anzahl aufeinanderfolgender starker Samples fest, wenn Stille oder Pause auftritt. Zum Beispiel können 15 stille Samples von 2 starken und dann 13 stillen folgen,

Die Konsolidierung basiert auf der Eigenschaft, dass das Ohr Änderungen in der Amplitude leiser Töne besser unterscheidet als laute Töne. Ein typischer ADC für Computer-Soundkarten verwendet eine lineare Umwandlung, um die Spannung in eine numerische Form umzuwandeln. Wenn die Amplitude a zu n wird, wird die Amplitude 2 a zu 2 n.

Wie erfolgt die Dateikomprimierung?

Wie erfolgt die Dateikomprimierung?

Audio and Video Compression

Da es viele Computer gibt, verfügen ihre Besitzer nicht über genügend Speicher auf internen und Wechseldatenträgern, um ihre Daten aufzunehmen. Das schnelle Wachstum des Festplattenvolumens löst dieses Problem nicht. Wenn wir vor 10 Jahren noch keine 20 Megabyte auf der Festplatte hatten, sind heute 20 Gigabyte gleich.

Audio and Video Compression

Die Größe der von uns verwendeten Programme und Daten wächst mit dem Wachstum der Festplatten. Wir können es uns bereits leisten, eine Bibliothek mit Zehntausenden von Büchern auf unserer Festplatte zu speichern. Wir können jedoch Musikkompositionen für mehrere hundert Stunden Ton und Video auf der Festplatte speichern, nur einige zehn Stunden. Daher ist das Problem der Archivierung oder Komprimierung von Daten nach wie vor so dringend wie vor 10 und 20 Jahren.

Wie erfolgt die Informationskomprimierung?

Geben wir Ihnen wie üblich eine grobe, aber verständliche Analogie. Die Datenkomprimierung ähnelt der Herstellung von Milchpulver oder Trockenfrüchten. Das heißt, es ist der Prozess des Entfernens von Wasser, das dann hinzugefügt werden kann, um dem Produkt sein ursprüngliches Aussehen zu verleihen.

Und welche Art von Wasser kann in den Daten enthalten sein? Dieses Wasser ist informativ. Es gibt viele Wiederholungen in den Daten. Dies kann zum Komprimieren von Daten verwendet werden.

Das Komprimieren von Textdateien sieht beispielsweise so aus. Eine Tabelle mit Wörtern und Ausdrücken im Text wird zusammengestellt. Dann erhalten alle Wörter und Ausdrücke in dieser Tabelle Zahlen. Der gesamte Text in der Datei wird durch Zahlen aus der Wort- und Ausdruckstabelle ersetzt. Mit dieser Methode können Sie die Größe einer Textdatei 2-3 Mal reduzieren. Manchmal wird der Text bis zu 10 Mal komprimiert, wenn er viele Wiederholungen enthält.

Ein Programm, das eine Textdatei in ein “komprimiertes” Format konvertiert, wird als Wrapper bezeichnet. Die aus der Komprimierung resultierende Datei wird als gepackte oder komprimierte Datei bezeichnet.

Komprimierte Dateien werden oft als Archive oder Archive bezeichnet, was streng genommen eine falsche Bezeichnung ist. Die Dateien wurden ursprünglich als Dateien bezeichnet, die speziell während Sicherungsprozessen erstellt wurden. Während dieses Vorgangs wurde eine einzelne Datei erstellt, die mehrere Quelldateien und Ordner enthält. Dies war die Datei. Es wurde keine Komprimierung durchgeführt. Eine ähnliche Situation besteht immer noch im Linux-Betriebssystem, wo Archivierung und Datenkomprimierung zwei unabhängige Prozesse sind. Unter dem MS-DOS-Betriebssystem und später unter MS Windows unterstützten die Datenkomprimierungsprogramme ihrer frühen Versionen sowohl die Komprimierung als auch die Datenarchivierung, dh sie erstellten eine komprimierte Datei, die nicht eine, sondern mehrere enthielt Quelldateien und Ordner (archiviert). … Seitdem ist in diesen Betriebssystemen das Konzept von ”

Da die Archivdatei nicht im Textformat geschrieben ist, können Texteditoren nicht damit arbeiten. Vor dem Öffnen der Archivdatei mit einem Texteditor muss dieses Archiv entpackt werden. Die Dekomprimierung erfolgt mit demselben Programm: einem Aktenschrank. Nach dem Entpacken erhält die Textdatei genau das gleiche Aussehen und die gleiche Größe wie zuvor.

Textablageschränke können auch Programmdateien archivieren. Nur Programme sind viel weniger komprimiert als Text.

Die zum Komprimieren von Text und Programmen verwendeten Packer können Audio-, Grafik- oder Videodateien nicht effizient komprimieren. Andere komplexere Algorithmen wurden für ihre Komprimierung entwickelt. Nach dem Entpacken unterscheiden sich die resultierenden Dateien jedoch geringfügig von den Originalen (diese Komprimierung wird als verlustbehaftete Komprimierung bezeichnet). Aber das gemeinsame menschliche Ohr nimmt dies nicht wahr und das gemeinsame Auge bemerkt es nicht auf dem Bildschirm.

Eine kurze Geschichte der Aktenschränke
Soweit ich mich erinnere, war das erste populäre Datendatei das Archiv mit dem Namen “ARJ”. Erstellt Archivdateien mit einer ähnlichen Erweiterung “ARJ”. Es war in den späten 80ern, frühen 90ern des letzten Jahrhunderts. Diese Dateien existieren noch heute. Sie sind in der Regel in DOS-Codierung geschrieben.

Dann erschienen die beiden beliebtesten Archivare auf dem Gebiet der GUS: “RAR” und “ZIP”. Sie werden jetzt durch die Programme “WinRAR” und “WinZIP” dargestellt. Das Programm “WinRAR” kann auch Archive “RAR” und “ZIP” erstellen. Und “WinRAR” kann Dateien aus einem Dutzend Formaten entpacken. In diesem Sinne ist “WinRAR” für uns ein universeller und praktischer (aber nicht kostenloser) Archivierer.