Abtastrate, woher sie kommt


Free Download Mp4Gain
picture

Abtastrate, woher sie kommt

Sample rate

Woher kommt die Samplerate für CD-Audio 44100 Hertz?

Sample rate

Die Standard-Samplerate für CD-Audio beträgt 44100 Hertz. Wo und warum wurden diese 44100 ursprünglich für die CD-Audioproduktion ausgewählt?

Ausgehend von der Bedingung (siehe Nyquist-Shannon-Kotelnikov) der Wiedergabe der Obergrenze des Spektrums bei 20 kHz sollte die Abtastfrequenz über 40 kHz gewählt worden sein. Zum Zeitpunkt der Erstellung dieser Standards und der Entwicklung der CD-DA-Technologie (der zweiten Hälfte der 70er Jahre des letzten Jahrhunderts) gab es jedoch kein allgemein akzeptiertes Medium, um digitalen Sound aufzunehmen, zu bearbeiten und zu speichern. Und dafür wurde beschlossen, Standard-Videorecorder zu verwenden, die damals im U-matic-Format arbeiteten. Das digitale Signal wurde von einem speziellen Codierer in ein Schwarz-Weiß-Video-Pseudosignal codiert und auf einer Videokassette aufgezeichnet. Die Struktur des digitalen Signals musste mit der Frequenz und Struktur der Felder des für die Aufzeichnung verwendeten Fernsehsignals verknüpft werden.

Diese Entscheidung wurde durch die Tatsache erschwert, dass in Europa und den USA unterschiedliche Videoaufzeichnungsstandards verwendet werden: 525 Zeilen bei 60 Hz und 625 Zeilen bei 50 Hz, während nicht alle Zeilen zum Aufzeichnen von Informationen verwendet werden können. Die ausgewählte Frequenz sollte zur Struktur beider Videosignale passen. 44100 Hz erfüllen diese Anforderung.

In einem 60-Hz-NTSC-Videosignal werden 35 Zeilen nicht für die Aufzeichnung verwendet, so dass 490 aktive Zeilen pro Bild oder 245 im Feld für die digitale Audioaufzeichnung verbleiben. Wenn Sie drei Samples in eine Zeichenfolge schreiben, beträgt die Samplerate:

60 × 245 × 3 = 44100.

In einem 50-Hz-PAL-Signal werden 37 Zeilen nicht verwendet, sodass 588 aktive Zeilen pro Frame oder 249 pro Feld verbleiben. Die Frequenz beträgt also:

50 × 249 × 3 = 44100.

Obwohl digitaler Ton zu dieser Zeit nichts mit dem Videosignal zu tun hatte, wurden bei der Herstellung der CD Videogeräte verwendet, die die Wahl der Abtastfrequenz bestimmten.


Free Download Mp4Gain
picture

Grundlagen der digitalen Klangtheorie Teil 4

Grundlagen der digitalen Klangtheorie Teil 4

Sample Rate

Mit dem MP3-Algorithmus können Sie den Sound 20 bis 30 Mal komprimieren und dabei eine gute Qualität beibehalten.

Sample Rate

Es wird angenommen, dass die volle Qualität der CD bei einer Bitrate von ungefähr 160 Kbit / s erhalten bleibt (die Konzepte “Abtastrate” und “Abtastbittiefe” gelten nicht für MP3-Dateien). In den meisten Fällen ist jedoch viel mehr komprimiertes Audio durchaus akzeptabel. Daher wird in Flash-Animationen normalerweise die MP3-Komprimierung verwendet, die eine Bitrate in der Größenordnung von 16 bis 32 Kbit / s ergibt. Der Flash-Player unterstützt einen Bereich von Bitraten zwischen 16 und 160 Kbit / s. Sie müssen auswählen am besten geeignet, basierend auf den Anforderungen an Filmgröße und Tonqualität. Es lohnt sich oft, die MP3-Datei in der Qualität zu belassen, in der sie importiert wurde (daher ist die Einstellung Importierte MP3-Qualität verwenden standardmäßig aktiviert). Wenn sich die Qualität ändert, sollte die Änderung in Richtung einer abnehmenden, aber nicht zunehmenden Qualität erfolgen.

Wenn der Sound in einem externen Editor verarbeitet wird, können Sie berücksichtigen, dass der Flash Player nicht nur den MP3-Algorithmus unterstützt, der Teil des MPEG1 Layer 3-Standards ist, sondern auch neuere Algorithmen (MPEG2 und MPEG2.5). Diese bieten eine bessere Klangqualität bei geringer Bittiefe. Darüber hinaus unterstützt der Player die MP3-Codierung mit konstanter und variabler Bittiefe (im letzteren Fall wird das beste Komprimierungsverhältnis erreicht).

Das MP3-Format ist optimal für vorschnelle Projekte. Daher wird es in der Praxis praktisch nur verwendet. Darüber hinaus können MP3-Dateien dynamisch geladen werden und verfügen über sehr nützliche ID3-Tags mit Informationen zu diesem Sound.

• Nellymoser. Ein relativ neuer Komprimierungsalgorithmus, der von Nellymoser Inc. entwickelt wurde. Er wurde entwickelt, um die menschliche Sprache zu komprimieren. Seine Hauptidee ist, dass eine menschliche Stimme Schwingungen mit Frequenzen in einem ziemlich engen Bereich enthalten kann. Die oberen und unteren Komponenten können verworfen werden. Oberschwingungen mit sehr geringer Amplitude werden ebenfalls eliminiert. Das Ergebnis ist eine Komprimierung, die mit der MP3-Komprimierung vergleichbar ist, aber die Klangqualität ist höher. Weitere Informationen zum Nellymoser-Algorithmus finden Sie auf der Entwickler-Website http://www.nellymoser.com/.

Der Nellymoser-Algorithmus-Codec ist nur in Flash MX im Player enthalten.

In der Flash-IDE wird die Nellymoser-Komprimierung als Sprache bezeichnet. Sie können das Qualitäts- / Größenverhältnis bei Verwendung der Nellymoser-Komprimierung anpassen, indem Sie die Abtastrate ändern.

Sie können auch unkomprimiertes Audio in Ihren SWF-Film aufnehmen. In der Entwicklungsumgebung wird dieser Modus als Raw bezeichnet. In diesem Fall können Sie die Bittiefe und die Abtastrate ändern. Theoretisch können Sie unkomprimiertes Audio verwenden, wenn die Tonqualität wesentlich wichtiger als die Filmgröße ist (oder noch weniger wahrscheinlich, wenn Sie Rechenressourcen sparen müssen). In der Praxis ist es jedoch besser, die MP3-Komprimierung mit einer hohen Bitrate (mehr als 120 Kbit / s) zu verwenden.

Speicherformate
Es gibt einige Audioformate. Standardmäßig können Sie mit Flash nur zwei davon importieren.

• WAV. Das Hauptformat zum Speichern von nicht komprimiertem Audio auf der Windows-Plattform. Unterstützt Mono- und Stereo-Audio, verschiedene Samples und Bittiefen. Normalerweise ist es WAV, wo das analoge Signal digitalisiert wird, und nur dann wird einer der Komprimierungsalgorithmen angewendet. WAV-Dateien sind extrem groß, weshalb dieses Format erheblich durch MP3 ersetzt wurde. WAV ist jedoch immer noch das Hauptformat für professionelle Soundeditoren wie SoundForge.

• MP3. Audioformat unter Verwendung des oben beschriebenen Komprimierungsalgorithmus. Das Hauptformat bei Flash, da es eine gute Klangqualität und eine kleine Dateigröße perfekt kombiniert. Außerdem können Audiodateien in diesem Format im Gegensatz zu WAV-Dateien mithilfe der loadSound () -Methode der Sound-Klasse dynamisch in einen Film geladen werden.

Wenn Sie QuickTime 4 oder höher installiert haben, können Sie zusätzlich Dateien in den Formaten AIFF, QuickTime und Sun AU importieren.

Grundlagen der digitalen Klangtheorie Teil 3
Grundlagen der digitalen Klangtheorie Teil 3

Sample Rate

Komprimierungsalgorithmen

Sample Rate

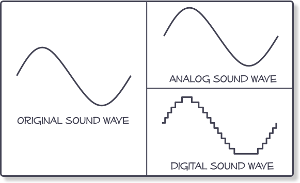
Versuchen wir zu berechnen, wie viel Speicherplatz eine durchschnittliche digitalisierte Musikkomposition in CD-Qualität belegt. Offensichtlich ist es dafür notwendig, die Formel t KBF-Größe ⋅ ⋅ ⋅ = zu verwenden, wobei F die Abtastfrequenz ist, B die Abtastkapazität ist, K die Anzahl der Strings ist, t die Zeit ist.

Unter der Annahme von 44,1 kHz Kräuter, B = 2 Bytes, K = 2 Kanälen und t = 300 Sekunden erhalten wir, dass der digitalisierte Song ungefähr 50 MB belegt.

Dies bedeutet, dass nur etwa 10 unkomprimierte Songs auf CD gebrannt werden können. Da jede Sekunde digitalisierten Tons in CD-Qualität fast 200 KB belegt, ist die Verwendung dieses Tons in Telefonie, Radio oder Internet sehr problematisch. Selbst wenn Sie den Ton als einen einzelnen Kanal mit einer Abtastrate von 11,05 kHz und einer Bittiefe von 8 Bit digitalisieren, belegt jede Sekunde 11 KB.

Für gewöhnliche Telefonnetzwerke ist dies zu viel, als dass Ton in einem kontinuierlichen Strom übertragen werden könnte. Ein Problem tritt auf: Irgendwie ist es notwendig, die Größe der Sounddateien zu reduzieren.

Es wird sehr effektiv durch die Verwendung verschiedener Komprimierungsalgorithmen gelöst.
Flash Player unterstützt die folgenden Komprimierungsarten.

• ADPCM (Adaptive Differential Pulse Code Modulation – Adaptive Difference Pulse Code Modulation). Diese Art der Komprimierung basiert auf zwei Ideen. Zunächst wurde festgestellt, dass bei der überwiegenden Mehrheit der von uns wahrgenommenen Geräusche langsam wechselnde Niederfrequenzkomponenten vorherrschen. Daraus folgt, dass der Unterschied zwischen benachbarten Proben oft gering ist (oder vielmehr deutlich geringer ist als der absolute Wert der Proben selbst).

Dies bedeutet, dass das digitalisierte Audiosignal nicht durch die Abtastwerte selbst dargestellt werden kann, sondern durch die Unterschiede zwischen ihnen, die kleiner sind und daher weniger Bits zur Beschreibung benötigen. Zweitens erfolgt die Codierung der Differenz zwischen benachbarten Proben unter Berücksichtigung der Größe der Amplituden- und Frequenzzusammensetzung, da das menschliche Ohr Empfindlichkeitsgrenzen aufweist (die sogenannte Anpassung).

Der ADPCM-Algorithmus wird in der IP-Telefonie aktiv verwendet. Es ist aufgrund der erheblichen Verzerrungen, die es in den Klang einführt, schlecht für das Streamen von Musik geeignet (Verzerrungen kommen natürlich in die Sprache, sind aber in der Sprache kaum wahrnehmbar). Das Komprimierungsverhältnis für ADPCM ist normalerweise niedrig und reicht von 8: 1 bis 3: 1. Der ADPCM Flash Player-Codec ermöglicht 2, 3,4 oder 5 Bit, um den Unterschied zwischen Samples darzustellen. Tatsächlich können Sie eine akzeptable Klangqualität mit einer Bitrate (Bitrate, dh dem “Gewicht” einer Tonsekunde) von 16 Kbit erzielen.

Der ADPCM-Algorithmus ist MP3 deutlich unterlegen, daher lohnt es sich im Prinzip nicht, eine solche Komprimierung zu verwenden. Die MP3-Komprimierung bietet eine um eine Größenordnung bessere Qualität bei gleicher Bittiefe. Das Vorhandensein des entsprechenden Codecs wird durch die Prinzipien der Abwärtskompatibilität erklärt: Der MP3-Codec ist nur in Flash 4 in den Player integriert. Zuvor wurde nur der ADPCM-Codec verwendet, was wahrscheinlich auf die kostenlose Verteilung von zurückzuführen ist dieser Algorithmus. Der Grund, warum ADPCM in der IP-Telefonie immer noch verwendet wird, besteht darin, dass es nicht so umfangreiche mathematische Berechnungen wie MP3 erfordert, sodass die Komprimierung im laufenden Betrieb erfolgen kann.

• MP3. Einer der ersten und gebräuchlichsten Komprimierungsalgorithmen, der auf der sogenannten psychoakustischen Komprimierung basiert. Es verwendet die folgenden Eigenschaften des menschlichen Ohrs:

oder wenn ein leiser Klang einem sehr starken folgt, dann hören wir ihn nicht. Daher kann es verworfen werden;

oder eine Klangkomponente mit einer großen Amplitude maskiert Komponenten in der Nähe, jedoch mit kleineren Amplituden. Daher können sie ohne merklichen Qualitätsverlust geschlachtet werden.

oder die Empfindlichkeit des Ohrs gegenüber Frequenzverzerrungen ist gering. Wenn die Komponenten nahe beieinander liegen, können sie als gleich angesehen werden.

o Wir nehmen sehr leise und sehr laute Töne falsch wahr, sodass weniger Bits für ihre Codierung zugewiesen werden können als für Töne mit einer durchschnittlichen Frequenz.

Technisch ist der MP3-Algorithmus wie folgt implementiert. Der Sound wird in Chunks einer bestimmten Länge unterteilt, die als Frames bezeichnet werden, und eine Vorwärts-Fourier-Transformation wird auf jeden Satz von Samples angewendet. Das Ergebnis ist die Zerlegung einer Schallwelle in elementare Sinuskurven unterschiedlicher Frequenzen: Harmonische. Der harmonische Koeffizient bestimmt seinen Beitrag zur resultierenden Welle. Harmonische Koeffizienten werden verglichen und die niedrigstwertigen werden verworfen.

Grundlagen der digitalen Klangtheorie Teil 2

Grundlagen der digitalen Klangtheorie Teil 2

Sample rate

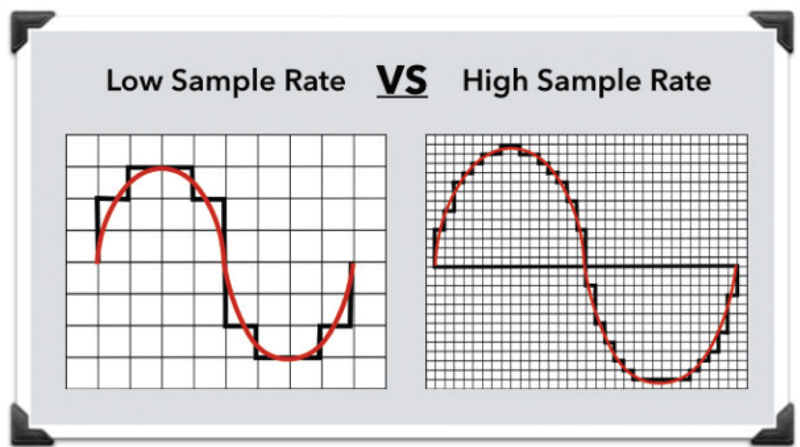
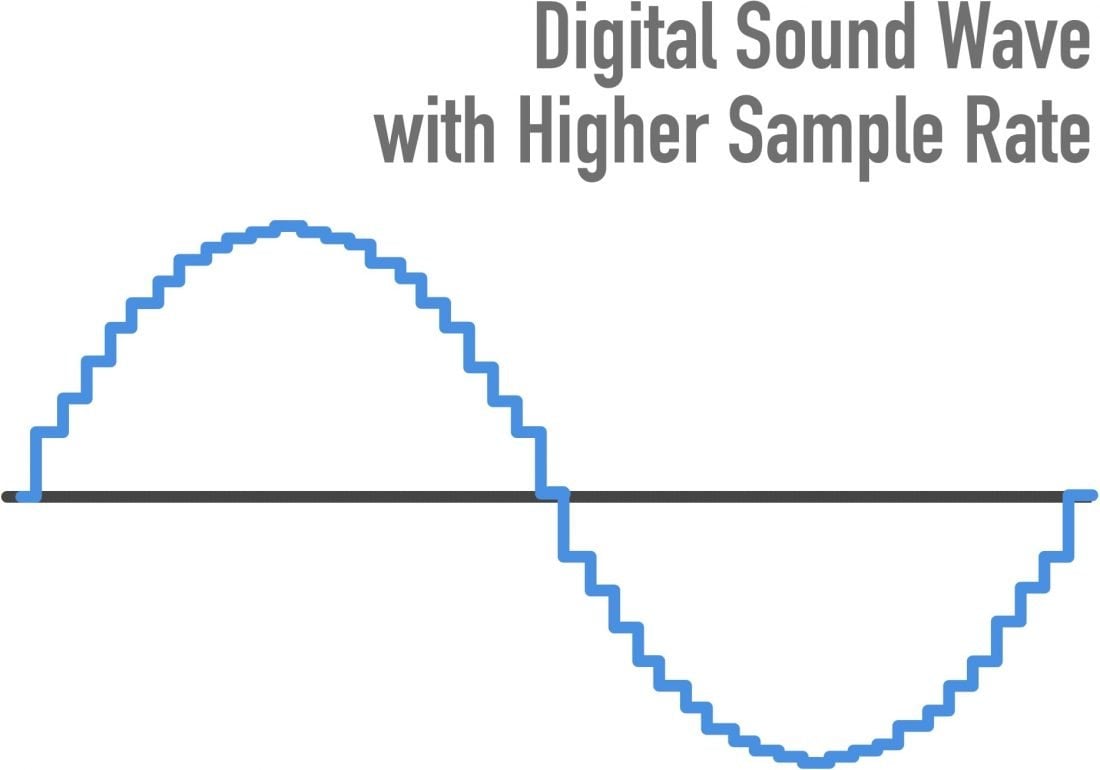
Eine Abtastrate von 44,1 kHz ist nicht immer ideal.

Samplerate

Bei der Übertragung von Daten über ein Netzwerk mit geringer Bandbreite muss die Klangqualität zugunsten seiner Größe geopfert werden. In der Praxis werden normalerweise Abtastfrequenzen verwendet, die zwei-, vier- und achtmal niedriger als 44,1 kHz sind:

• 22,05 kHz: die sogenannte Radioqualität. Wird beim Codieren des Tons von UKW-Radiosendern verwendet. Im Fall von Flash eignet es sich gut zum Erstellen von Hintergrundmusik und Ereignissounds. Für die Übertragung einer menschlichen Stimme ist sie sogar etwas überflüssig;

• 11.025 kHz – Telefonqualität. Eine Abtastrate, die besser für die menschliche Stimme geeignet ist. Wird in der 1P-Telefonie verwendet.

• 5,5 kHz: Ton, bei dem die Informationskomponente verloren geht. Diese Abtastrate kann verwendet werden, um sowohl leise Töne als auch Sprache zu übertragen (wenn auch mit mittelmäßiger Qualität).

Flash Player unterstützt Sampleraten 44.1: 22.05; 11.025; 5,5 kHz. Die Wahl der Frequenz sollte von der Art des Tons sowie von der Wichtigkeit der Beibehaltung der Größe der SWF-Datei abhängen. Es sollte jedoch beachtet werden, dass es keinen Sinn macht, die Abtastrate des Audiofragments im Vergleich zur ursprünglichen zu erhöhen. Dies erhöht nicht die Qualität, sondern nur unnötig die Größe des Films.

Bittiefe der Proben
Die Bittiefe bestimmt, wie viele verschiedene Amplitudenwerte während der Digitalisierung erfasst werden können. Wenn die Bitbreite 4 Bits beträgt, wird der Bereich des Amplitudenwerts von Null bis zum Maximum in nur 16 Bins unterteilt. Natürlich ist der Fehler beim Wiederherstellen des analogen Signals sehr hoch. Diese Bittiefe eignet sich sowohl für die Darstellung sehr einfacher Töne als auch für Sprache (die Qualität ist gering).

Durch die 8-Bit-Breite können 256 Amplitudenwerte dargestellt werden. Dies ist die Bittiefe, die von UKW-Radiosendern verwendet wird. Es reicht aus, jeden Klang in zufriedenstellender Qualität zu präsentieren. Die 16-Bit-Codierung ist optimal. Gleichzeitig kann es mit 65.536 Amplitudenoptionen arbeiten, was ausreicht, um den gesamten hörbaren Bereich abzudecken.

Das 16-Bit-Format wird für die CD-Aufnahme verwendet. Eine Quantisierung höherer Qualität ist nur bei der Studiotonverarbeitung gerechtfertigt.

Flash Player unterstützt 8-Bit- und 16-Bit-Quantisierung für unkomprimierte Formate (z. B. WAV) und nur 16-Bit für komprimierte Formate (MP3 gehört dazu). Beachten Sie dies beim Importieren einer Audiodatei in einen Film.

Anzahl der Kanäle Die
Stereo-Sound soll dem Wiedergabeton eine natürliche Dimension verleihen. Dies wird dadurch erreicht, dass von jedem Lautsprecher eine andere Klangkomponente wiedergegeben wird. Im Allgemeinen ist der Sound jedes Kanals eine separate Sounddatei, sodass die Größe des Stereoklangs proportional zur Anzahl der unterstützten Kanäle ist.

Herkömmliche nicht professionelle Soundkarten arbeiten mit Zweikanal-Audio. Der Flash Player unterstützt auch die gleiche Anzahl von Kanälen. Mit ActionScript können Sie den Klang der Kanäle mischen, indem Sie den linken Kanal auf dem rechten Lautsprecher und den rechten Kanal auf dem linken abspielen. Wie das gemacht wird, werden wir weiter unten besprechen.

Wenn der Sound im MP3-Format codiert ist, können Sie eines von drei Stereoformaten auswählen.

• Doppelkanal. Jeder Kanal empfängt die Hälfte des Streams und wird separat als Mono codiert. Es wird hauptsächlich in Fällen empfohlen, in denen verschiedene Kanäle ein grundlegend unterschiedliches Signal enthalten, z. B. Text in verschiedenen Sprachen.

• Stereo. Die Kanäle werden separat verschlüsselt, aber das Verschlüsselungsprogramm kann einem Kanal bei Bedarf mehr Platz als dem anderen geben. Das meiste Standardformat.

• Gemeinsame Stereoanlage. Das Stereosignal wird in zwei neue Kanäle unterteilt. Einer ist der Durchschnitt der ursprünglichen Kanäle und der andere ist der Unterschied zwischen den Kanälen. In diesem Modus wird die Klangqualität häufiger als in anderen erhalten.

Leider können Sie in der Flash-Entwicklungsumgebung nicht angeben, welches Stereoformat verwendet wird. Wenn daher die Klangqualität von größter Bedeutung ist, sollte die Erstellung von MP3-Dateien mit den erforderlichen Parametern mit einem der speziellen Programme erfolgen.