Wie unterscheidet sich die digitale Darstellung von Signalen von der analogen?


Free Download Mp4Gain
picture

Wie unterscheidet sich die digitale Darstellung von Signalen von der analogen?
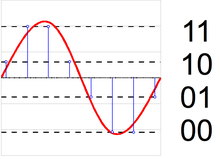
analog and digital

Die traditionelle analoge Darstellung von Signalen basiert auf der Ähnlichkeit (Ähnlichkeit) elektrischer Signale (Änderungen von Strom und Spannung) mit den von ihnen dargestellten Originalsignalen (Schalldruck, Temperatur, Geschwindigkeit usw.).
Analog vs Digital

Sowie in der Ähnlichkeit der Formen der elektrischen Signale an verschiedenen Punkten des Verstärkungs- oder Übertragungsweges. Die Form der elektrischen Kurve, die das ursprüngliche Signal beschreibt (auch als Übertragung bezeichnet), kommt der Form der Kurve dieses Signals so nahe wie möglich.

Eine solche Darstellung ist am genauesten, jedoch wird die geringste Verzerrung der Form des elektrischen Trägersignals unvermeidlich die gleiche Verzerrung der Form und des Signals des Trägers beinhalten. In Bezug auf die Informationstheorie ist die Informationsmenge im Trägersignal genau gleich der Informationsmenge im Originalsignal, und die elektrische Darstellung enthält keine Redundanz, die das übertragene Signal vor Verzerrung während der Speicherung und Übertragung schützen könnte. und Verstärkung.

Die digitale Darstellung elektrischer Signale soll Redundanz hinzufügen, um unerwünschte Interferenzen zu vermeiden. Hierzu werden dem elektrischen Signal des Trägers ernsthafte Einschränkungen auferlegt: Seine Amplitude kann nur zwei Grenzwerte annehmen: 0 und 1. In diesem Fall wird die gesamte Zone möglicher Amplituden in drei Zonen unterteilt: Die untere Zone repräsentiert Nullwerte, die obere , einzigartig, und das Zwischenprodukt ist nach innen verboten. es können nur Störungen eindringen. Daher beeinflusst jede Interferenz, deren Amplitude weniger als die Hälfte der Amplitude des Trägersignals beträgt, nicht die korrekte Übertragung der Werte 0 und 1. Eine Interferenz mit einer höheren Amplitude beeinflusst auch nicht, ob die Dauer des Interferenzimpulses signifikant ist weniger als die Dauer des Informationsimpulses.

Das auf diese Weise gebildete digitale Signal kann jede nützliche Information enthalten, die in Form einer Folge von Bits codiert ist: Nullen und Einsen; Ein besonderer Fall solcher Informationen sind elektrische und akustische Signale. Hier ist die Informationsmenge in dem digitalen Trägersignal viel höher als in dem ursprünglich codierten Signal, so dass das Trägersignal eine gewisse Redundanz in Bezug auf das Original und jegliche Verzerrung der Wellenform des Trägersignals aufweist. Die Fähigkeit des Empfängers, zwischen Nullen und Einsen korrekt zu unterscheiden, bleibt erhalten, hat jedoch keinen Einfluss auf die Zuverlässigkeit des übertragenen Signals. durch dieses Informationssignal. Bei erheblicher Interferenz kann die Form des Signals jedoch so stark verzerrt werden, dass eine genaue Übertragung der übertragenen Informationen unmöglich wird: Es treten Fehler auf, die mit einem einfachen Codierungsverfahren auftreten kann der Empfänger nicht nur korrigieren, sondern auch erkennen. Um den Widerstand eines digitalen Signals gegen Interferenz und Verzerrung weiter zu erhöhen, werden zwei Arten der digitalen Redundanzcodierung verwendet: Verifizierungscodes (EDC – Fehlererkennungscode) und Korrektur (ECC – Fehlerkorrekturcode). ). Bei der digitalen Codierung werden einfach zusätzliche Bits zu den ursprünglichen Informationen hinzugefügt und / oder die ursprüngliche Bitfolge in eine längere Zeichenfolge und eine andere Struktur umgewandelt. Mit EDC können Sie einfach die Tatsache eines Fehlers erkennen: eine Verzerrung oder einen Verlust einer nützlichen oder das Auftreten einer falschen Ziffer, aber die Informationen, die in diesem Fall übertragen werden, sind auch verzerrt; Mit ECC können Sie erkannte Fehler sofort korrigieren und die übertragenen Informationen unverändert lassen.

Jeder EDC / ECC-Typ hat seine eigene Kapazitätsgrenze zum Erkennen und Korrigieren von Fehlern. Danach beginnen unerkannte Fehler und Verzerrungen der übertragenen Informationen erneut. Eine Erhöhung des EDC / ECC-Volumens im Verhältnis zum Volumen der Originalinformationen erhöht im Allgemeinen die Fähigkeit, diese Codes zu erkennen und zu korrigieren.

Wie EDC der beliebte zyklische Redundanzcode CRC (Cyclic Redundancy Check), dessen Kern das komplexe Mischen der Anfangsinformationen im Block und die Bildung kurzer binärer Wörter ist, deren Bits eine starke Kreuzabhängigkeit von jedem Bit des Blocks aufweisen. Das Ändern auch nur eines Bits in einem Block führt zu einer signifikanten Änderung der daraus berechneten CRC, und die Wahrscheinlichkeit einer solchen Bitverzerrung, bei der sich die CRC nicht ändert, ist selbst bei kurzen CRC-Wörtern (einem kleinen Prozentsatz der Länge) äußerst gering des Blocks). Das ECC verwendet die Codes Hamming und Reed-Solomon, die auch EDC-Funktionen enthalten.

Die Informationsredundanz des digitalen Trägersignals führt zu einer signifikanten Erweiterung (um eine Größenordnung oder mehr) des Frequenzbandes, das für seine erfolgreiche Übertragung erforderlich ist.

Free Download Mp4Gain
picture

Digitale Audiocodierung

Digitale Audiocodierung

Digital Audio coding

Digitale Audiotechnologien werden zum Aufnehmen, Verarbeiten, Massenproduzieren und Verteilen von Ton verwendet, einschließlich der Aufnahme von Songs, Instrumentalstücken, Podcasts, Soundeffekten und anderen Sounds.

Digital Audio Coding

Die heutige Online-Musikdistribution basiert auf digitaler Aufzeichnung und Datenkomprimierung. Die Verfügbarkeit von Musik als Datendateien anstelle von physischen Objekten hat die Vertriebskosten erheblich reduziert. Vor dem Aufkommen des digitalen Klangs verteilte und verkaufte die Musikindustrie Musik und verkaufte physische Kopien in Form von Schallplatten und Kassetten.

Mithilfe von Online- und digitalen Audioverteilungssystemen wie iTunes verkaufen Unternehmen digitale Audiodateien an Verbraucher, die der Verbraucher über das Internet erhält. Ein analoges Audiosystem wandelt die physikalischen Schallwellenformen unter Verwendung eines Wandlers wie eines Mikrofons in elektrische Darstellungen dieser Wellenformen um. Die Töne werden dann auf analogen Medien wie Magnetbändern gespeichert oder über analoge Medien wie Telefonleitungen oder Funkgeräte übertragen. Bei der Wiedergabe wird der Vorgang umgekehrt: Ein elektrisches Audiosignal wird verstärkt und dann über einen Lautsprecher wieder in physikalische Wellenformen umgewandelt.

Analoges Audio behält seine grundlegenden Wellenformeigenschaften bei, wenn es gespeichert, konvertiert, verdoppelt und verstärkt wird. Analoge Audiosignale sind aufgrund der inhärenten Eigenschaften elektronischer Schaltungen und verwandter Geräte anfällig für Rauschen und Verzerrungen. Interferenzen in einem digitalen System führen nicht zu einem Fehler, es sei denn, die Interferenz ist groß genug, um zu bewirken, dass ein Zeichen als ein anderes Zeichen falsch interpretiert wird oder nicht in der richtigen Reihenfolge ist.

Daher ist es im Allgemeinen möglich, ein vollständig fehlerfreies digitales Audiosystem zu haben, bei dem zwischen der Umwandlung in digital und der Umwandlung in analog kein Rauschen oder Verzerrung auftritt. Das digitale Audiosignal kann weiter codiert werden, um alle Fehler zu korrigieren, die während der Speicherung oder Übertragung des Signals auftreten können. Diese als Kanalcodierung bekannte Technik ist für Rundfunk- oder aufgezeichnete digitale Systeme erforderlich, um die Bittreue aufrechtzuerhalten. Die Modulation von acht auf vierzehn ist ein Kanalcode, der auf Audio-CDs verwendet wird. Umwandlungsprozess

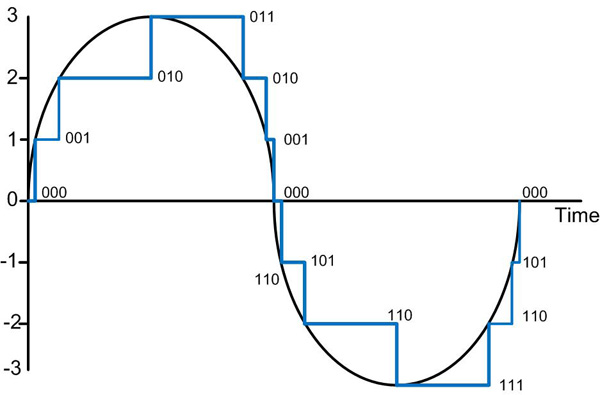
Der Lebenszyklus von Ton von seiner Quelle über ADC, digitale Verarbeitung, DAC und schließlich wieder als Ton. Ein digitales Audiosystem beginnt mit einem ADC, der ein analoges Signal in ein digitales umwandelt. Der ADC arbeitet mit der angegebenen Abtastrate und konvertiert in eine bekannte Bitauflösung.

Beispielsweise hat CD-Audio eine Abtastrate von 44,1 kHz (44.100 Abtastungen pro Sekunde) und eine Auflösung von 16 Bit für jeden Stereokanal. Analoge Signale, die noch nicht bandbegrenzt waren, sollten vor der Umwandlung gedämpft werden, um Interpolationsverzerrungen zu vermeiden, die durch Audiosignale oberhalb der Nyquist-Frequenz (die Hälfte der Abtastrate) verursacht werden.

Das digitale Audiosignal kann gespeichert oder übertragen werden. Digitales Audio kann auf einer CD, einem digitalen Audioplayer, einer Festplatte, einem USB-Flash-Laufwerk oder einem anderen digitalen Speichergerät gespeichert werden. Das digitale Signal kann durch digitale Signalverarbeitung modifiziert werden, wobei Effekte gefiltert oder angewendet werden können. Frequenztransformation Abtastraten, einschließlich Erhöhen und Verringern der Abtastrate, können verwendet werden, um Signale, die mit einer anderen Abtastrate codiert wurden, an eine gemeinsame Abtastrate vor der Verarbeitung anzupassen. Audiokomprimierungsmethoden wie MP3, Advanced Audio Coding, Ogg Vorbis oder FLAC werden häufig verwendet, um die Dateigröße zu reduzieren.

Digitales Audio kann über digitale Audio-Interfaces wie AES3 oder MADI übertragen werden. Digitales Audio kann über ein Netzwerk mit Audio über Ethernet, Audio über IP oder anderen Standards und Medienübertragungssystemen übertragen werden. Für die Wiedergabe muss digitales Audio mithilfe eines DAC wieder in ein analoges Signal umgewandelt werden. Gemäß dem Nyquist-Shannon-Abtasttheorem kann mit einigen praktischen und theoretischen Einschränkungen die bandbreitenbegrenzte Version des ursprünglichen analogen Signals aus dem digitalen Signal genau rekonstruiert werden. – –

MP3 digitales Audioformat

MP3 digitales Audioformat

MP3 File Format

Hochwertiges digitalisiertes Audio erfordert viel Speicherplatz.

mp3 file

Versuche, die Größe von Dateien mithilfe von Standardarchivierern (RAR, GZIP usw.) zu reduzieren, führen aufgrund der Spezifität der Audiodaten nicht zu signifikanten Gewinnen. Es ist jedoch möglich, mit speziellen Methoden, die auf der Analyse der Datenstruktur und der anschließenden Komprimierung mit einigen Verlusten basieren, ein ziemlich signifikantes Maß an Komprimierung der Audioinformationen zu erreichen.

Die reale Möglichkeit einer Klangverarbeitung, deren Qualität mit den vorhandenen analogen Beispielen vergleichbar ist, trat erst Ende der 1980er Jahre auf.

1988 bildete die Internationale Organisation für Normung (ISO) das MPEG-Komitee (Moving Picture Experts Group), dessen Hauptaufgabe darin besteht, Standards für die Kodierung von bewegten Bildern, Ton und deren Kombination zu entwickeln. In den zehn Jahren seines Bestehens hat das Komitee eine Reihe von Normen zu diesem Thema entwickelt. Zusammenfassend wurden mehrere spezifische Formate für die Speicherung von Daten empfohlen, die sich durch hervorragende Qualität der Ergebnisse und Datenfluss auszeichnen.

Derzeit gibt es drei Videospeicherstandards: MPEG-1, MPEG-2 und MPEG-4.

Innerhalb der ersten beiden Formate gibt es auch Formate zum Speichern von Audioinformationen: Layer-1, Layer-2 und Layer-3. Diese drei Audioformate sind für MPEG-1 definiert und kleinere Erweiterungen werden in MPEG-2 verwendet. Die drei Formate sind einander ähnlich, verwenden jedoch unterschiedliche Kompromisse zwischen Komprimierung und Komplexität.

Schicht-1 ist die einfachste, erfordert keine signifikanten Komprimierungskosten, bietet aber auch ein vernachlässigbares Komprimierungsverhältnis.

Layer-3 ist am zeitaufwändigsten und bietet die beste Komprimierung. In letzter Zeit hat dieses Format immense Popularität erlangt. Es wird oft als MP3 bezeichnet. Dieser Name ist mit der Erweiterung der in diesem Format gespeicherten Audiodateien verbunden.

Die Grundidee aller verlustbehafteten Audiokomprimierungstechniken besteht darin, die subtilen Details des Originaltons zu vernachlässigen, die außerhalb der Reichweite des menschlichen Ohrs liegen. Hier können mehrere Punkte hervorgehoben werden.

Geräuschpegel . Die Klangkomprimierung basiert auf einer einfachen Tatsache: Wenn sich eine Person in der Nähe einer lauten Sirene befindet, ist es unwahrscheinlich, dass sie die Konversation der Personen in der Nähe hört. Und dies geschieht nicht, weil eine Person einem lauten Geräusch große Aufmerksamkeit schenkt, sondern in größerem Maße, weil das menschliche Ohr tatsächlich Geräusche übersieht, die im gleichen Frequenzbereich wie ein lauteres Geräusch liegen. Dieser Effekt wird als Maskierung bezeichnet und ändert sich mit dem Unterschied in Lautstärke und Frequenz des Klangs.

Der zweite Punkt ist die Aufteilung des Audiofrequenzbandes in Teilbänder, von denen jedes separat weiterverarbeitet wird. Das Codierungsprogramm extrahiert die lautesten Töne in jedem Band und verwendet diese Informationen, um einen akzeptablen Rauschpegel für dieses Band zu bestimmen. Die besten Codierungsprogramme berücksichtigen auch den Einfluss benachbarter Bänder. Ein sehr lauter Ton in einem Band kann den Maskierungseffekt und benachbarte Bänder beeinflussen.

Ein weiterer Punkt der Kodifizierung ist die Verwendung eines psychoakustischen Modells, das auf den Besonderheiten der menschlichen Wahrnehmung von Schall basiert. Die von diesem Modell verwendete Komprimierung basiert auf dem Entfernen von Frequenzen, von denen bekannt ist, dass sie unhörbar sind, während Geräusche, die vom menschlichen Ohr leicht gehört werden können, sorgfältiger beibehalten werden. Leider kann es hier keine genauen mathematischen Formeln geben.

Die menschliche Wahrnehmung von Geräuschen ist ein komplexer Prozess, der nicht vollständig verstanden wird. Daher basiert die Auswahl der Komprimierungsmethoden auf der Analyse des Hörens und dem unterschiedlichen Vergleich komprimierter Geräusche durch Expertenteams. Hier gibt es jedoch praktisch unbegrenzte Möglichkeiten, psychoakustische Modelle zu verbessern. Die meisten der vorhandenen Algorithmen zum Codieren der menschlichen Stimme basieren auf der hohen Vorhersagbarkeit des Signals; Universelle MPEG-Komprimierungsalgorithmen haben versucht, diese Technik mit variablem Erfolg anzuwenden.

Eine weitere Komprimierungstechnik ist die Verwendung von sogenanntem Joint Stereo. Es ist bekannt, dass das menschliche Hörgerät nur die Richtung der Mittenfrequenzen, des hohen und des niedrigen Tons sozusagen getrennt von der Quelle bestimmen kann. Dies bedeutet, dass diese Hintergrundfrequenzen in ein Monosignal codiert werden können. Darüber hinaus nutzt die Komprimierung den Unterschied in der Komplexität der Flüsse in den Kanälen.

Digitale Audiokomprimierungsmethoden

Digitale Audiokomprimierungsmethoden

Audio Compression

Verlustfreie Kompression


Audio Compression

Im Allgemeinen bedeutet verlustfreie Komprimierung Folgendes: In den Originaldaten befindet sich ein Muster, und unter Berücksichtigung dieses Musters wird ein zweiter Stream generiert, der das Original eindeutig beschreibt. Um beispielsweise Binärsequenzen mit vielen Nullen und wenigen Einsen zu codieren, können wir den folgenden Ersatz verwenden:

00> 0
01> 10
10> 110
11> 111

In diesem Fall 16 Bits:

00 01 00 00 11 10 00 00

wird in dreizehn Bits konvertiert:

0 10 0 0 111 110 0 0

Wenn wir eine komprimierte Zeichenfolge ohne Leerzeichen schreiben, können wir dennoch Leerzeichen hinzufügen, was bedeutet, dass die ursprüngliche Sequenz wiederhergestellt wird.

FLAC (Free Lossless Audio Codec – Kostenloser verlustfreier Audio Codec)
Codierungsprinzip: Der Algorithmus versucht, das Signal mit dieser Funktion zu beschreiben, damit das Ergebnis, das nach Subtraktion vom Original (Differenz, Rest, Fehler genannt) erhalten wird, mit einem Minimum an Bits codiert werden kann.

Wenn das Modell angepasst ist, subtrahiert der Algorithmus die Näherung vom Original, um ein Restsignal (Fehler) zu erhalten, das dann verlustfrei codiert wird.

Verlustbehaftete Komprimierung (MP3, AAC, WMA, OGG)
Bei Verwendung eines verlustbehafteten Komprimierungsalgorithmus beträgt die Größe einer MP3-Datei mit einer durchschnittlichen Bitrate von 128 kbit / s ungefähr 1/11 der Originaldatei einer Audio-CD (unkomprimiertes Audio im CD-Audio-Format weist eine Rate auf 1411,2 kbps Bitrate). MP3-Dateien können mit hohen oder niedrigen Bitraten erstellt werden, was sich auf die Qualität des Ergebnisses auswirkt.

Das Prinzip der Komprimierung besteht darin, die Präzision einiger Teile des Schallflusses zu verringern, was für die meisten Menschen kaum zu unterscheiden ist. Das Audiosignal ist in gleich lange Segmente unterteilt, von denen jedes nach der Verarbeitung in einen eigenen Frame (Frame) gepackt wird. Die spektrale Zerlegung erfordert die Kontinuität des Eingangssignals. Daher werden die vorherige und die nächste Tabelle auch für Berechnungen verwendet. Das Audiosignal enthält Harmonische mit einer niedrigeren Amplitude und Harmonische, die nahe am stärksten sind. Solche Harmonischen werden abgeschnitten, da das durchschnittliche menschliche Ohr das Vorhandensein oder Fehlen solcher Harmonischen nicht immer bestimmen kann. Diese Eigenschaft des Hörens wird als Maskierungseffekt bezeichnet. Es ist auch möglich, zwei oder mehr nahegelegene Peaks durch einen gemittelten zu ersetzen (was in der Regel zu Klangverzerrungen führt). Das Abschaltkriterium wird durch die Abflussanforderung bestimmt. Da das gesamte Spektrum relevant ist, werden hochfrequente Harmonische nicht abgeschnitten, sondern nur selektiv entfernt, um den Informationsfluss aufgrund der Verdünnung des Spektrums zu verringern. Nach der spektralen Entfernung werden mathematische Komprimierungs- und Rahmenpackungsmethoden angewendet.

Maskierungseffekt
In bestimmten Fällen kann ein Ton durch einen anderen Ton ausgeblendet werden. Zum Beispiel kann es völlig unmöglich sein, neben einer Bahnstrecke zu sprechen, wenn ein Zug vorbeifährt. Diese Art von Effekt wird als Maskierung bezeichnet. Ein schwacher Ton wird als maskiert bezeichnet, wenn er bei einem lauteren Ton nicht mehr zu unterscheiden ist.

Gleichzeitige Maskierung
Wenn zwei beliebige Geräusche gleichzeitig gehört werden, wirken sie sich auf die Wahrnehmung der relativen Lautstärke zwischen ihnen aus. Ein lauteres Geräusch verringert die Wahrnehmung eines schwächeren, bis Ihr Gehör verschwindet. Je näher die Frequenz des maskierten Tons an der Frequenz des Maskierers liegt, desto mehr wird er ausgeblendet. Der Maskierungseffekt ist nicht der gleiche, wenn der maskierte Klang in Bezug auf die Maskierung in der Frequenz nach unten oder oben verschoben wird. Niederfrequenter Ton maskiert hochfrequenten Ton. Es ist jedoch wichtig zu beachten, dass hochfrequente Töne niederfrequente Töne nicht maskieren können.

Zeitmaskierung
Dieses Phänomen ähnelt der Frequenzmaskierung, jedoch tritt hier eine Zeitmaskierung auf. Wenn das Maskierungsgeräusch gestoppt wird, bleibt die Maskierung einige Zeit unhörbar. Unter normalen Bedingungen hält die Wirkung der vorübergehenden Maskierung viel weniger an. Die Maskierungszeit hängt von der Frequenz und Amplitude des Signals ab und kann bis zu 100 ms betragen.
In dem Fall, in dem der Maskierungston später als der maskierte erscheint, wird der Effekt als Nachmaskierung bezeichnet. Wenn der Maskierungston vor der Maskierung erscheint (dies ist auch möglich), wird der Effekt als Vormaskierung bezeichnet.

Müdigkeit nach dem Reiz
Oft sinkt die Hörempfindlichkeit einer Person dramatisch, wenn sie lauten, hochintensiven Geräuschen ausgesetzt wird. Die Wiederherstellung normaler Schwellenwerte kann bis zu 16 Stunden dauern. Dieser Vorgang wird als “vorübergehende Änderung der Hörschwelle” bezeichnet.