MPEG: Fragen und Antworten

MPEG: Fragen und Antworten

]MPEG Video

Was ist MPEG?

MPEG Video

MPEG ist eine Gruppe von Personen innerhalb der ISO (International Standards Organization), die zusammenkommen, um Standards für die digitale Video- und Audiokomprimierung zu entwickeln. Insbesondere identifizierten sie einen komprimierten Durchfluss und einen Dekompressor dafür. Die Komprimierungsalgorithmen werden von jedem Hersteller individuell festgelegt, was der Vorteil des veröffentlichten International Standard ist. Die MPEG-Gruppe trifft sich ungefähr viermal im Jahr für ungefähr eine Woche. Der größte Teil der Arbeit wird zwischen Besprechungen, Organisation und Planung für sie erledigt.

Hat es etwas mit JPEG zu tun?
Ja, die Namen sind Konsonanten und die Gruppen gehören zusammen mit JBIG und MHEG demselben ISO-Unterausschuss an und treffen sich am selben Ort und zur selben Zeit. Es sind jedoch unterschiedliche Menschen mit unterschiedlichen Zielen und Bedürfnissen. JPEG dient zum Komprimieren von Standbildern, MPEG zum Live-Video und zugehörigem Audio.

Was sind JBIG und MHEG?
JBIG dient zur Komprimierung von Binärbildern (Faxen, …) und MHEG für Multimediadaten zur Integration von Standbildern, Video, Audio, Text usw.

Wie funktioniert MPEG-Video?
Ein digitales Farbbild der komprimierten Sequenz wird in den YUV-Farbraum (YCbCr) konvertiert. Die Y-Komponente repräsentiert die Intensität und die U- und V-Komponenten repräsentieren die Chromatizität. Da das menschliche Auge weniger empfindlich auf Chroma als auf Intensität reagiert, kann die Auflösung der Farbkomponenten zweimal vertikal oder sowohl vertikal als auch horizontal reduziert werden. Bei Animationen und hochwertigen Studio-Videos wird kein Downsampling angewendet, um die Qualität zu erhalten. Bei Heimanwendungen, bei denen die Streams geringer und die Ausrüstung billiger sind, führt diese Aktion nicht zu einem spürbaren Verlust. auf visuelle Wahrnehmung, während wertvolle Daten gespeichert werden.

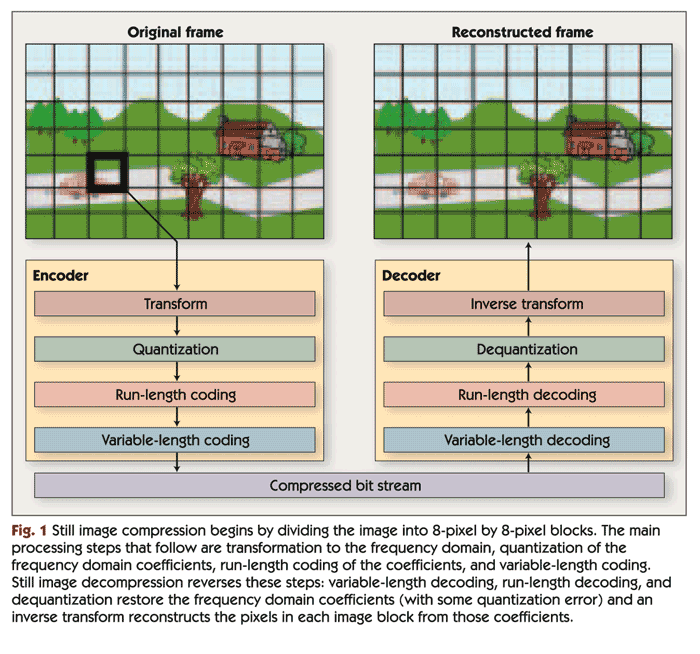
Die Grundidee des gesamten Schemas besteht darin, die Bewegung von einem Frame zum anderen vorherzusagen und dann eine diskrete Cosinustransformation (DCT) anzuwenden, um die Redundanz im Raum neu zu verteilen. Die DCT wird in 8×8-Punktblöcken durchgeführt, die Bewegungsvorhersage im Intensitätskanal (Y) in 16×16-Punktblöcken oder, abhängig von den Eigenschaften der ursprünglichen Bildsequenz (Interlaced-Scan, Inhalt), in Blöcken 16×8 Punkte. Mit anderen Worten, ein gegebener 16 × 16-Pixelblock wird in dem aktuellen Rahmen in dem entsprechenden größeren Bereich in den vorherigen oder nachfolgenden Rahmen gesucht. Die DCT-Koeffizienten (die Originaldaten oder die Differenz zwischen diesem und seinem entsprechenden Block) werden quantisiert, dh sie werden durch eine bestimmte Zahl geteilt, um unbedeutende Bits zu verwerfen. Viele Koeffizienten nach einer solchen Operation erweisen sich als Null.

Wie hängen die Frames zusammen?
Es gibt drei Arten von codierten Frames. I-Frames sind Frames, die als Standbilder ohne Bezug zum nächsten oder nächsten codiert sind. Sie werden als Ausgangspunkte verwendet. P-Frames sind vorhergesagte Frames aus vorherigen I- oder P-Frames. Jeder Makroblock in dem P-Rahmen kann mit einem Vektor und der DCT-Koeffizientendifferenz des entsprechenden Blocks vom zuletzt decodierten I oder P kommen, oder er kann wie in I codiert sein, wenn der entsprechende Block nicht gefunden wurde.

Und schließlich gibt es die B-Frames, die aus den beiden nächsten I- oder P-Frames vorhergesagt werden, einen vor und einen nach. In diesen Frames werden die entsprechenden Blöcke durchsucht und der beste ausgewählt. Der direkte Vektor wird gesucht, dann die Umkehrung, und der Durchschnitt zwischen den entsprechenden Makroblöcken in der Vergangenheit und der Zukunft wird berechnet. Wenn dies nicht funktioniert, kann der Block als I-Frame codiert werden.

Die Reihenfolge der decodierten Frames sieht im Allgemeinen so aus

IBBPBBPBBPBBIBBPBBPB …

Es gibt 12 Frames von I bis I Frame. Dies basiert auf der Direktzugriffsanforderung, dass der Startpunkt alle 0,4 Sekunden wiederholt werden muss. Die Beziehung von P nach B basiert auf Erfahrung.

Damit der Decoder funktioniert, muss der erste P-Frame in der Sequenz vor dem ersten B liegen, damit die komprimierte Sequenz folgendermaßen aussieht:

0 xx 3 1 2 6 4 5 …

Dabei sind die Zahlen die Anzahl der Frames. xx kann nichts sein, wenn es der Anfang einer Sequenz ist, oder Frames B -2 und -1, wenn es sich in der Mitte einer Sequenz befindet.

Sie müssen zuerst den I-Frame dekodieren, dann P und dann, wenn beide im Speicher sind, B dekodieren. Während der Decodierung wird P angezeigt. I-Frame, B wird sofort angezeigt und das decodierte P wird während der Decodierung des nächsten angezeigt.

Digitales Video, seine Vorteile

Digitales Video, seine Vorteile

DIGITAL VIDEO

Digitale Technologien bieten unbestreitbare Vorteile gegenüber analogen Technologien.

Digital Video

Das digitalisierte Signal kann alle in analoger Form gespeicherten Informationen speichern. Moderne digitale Datenübertragungs-, Aufzeichnungs- und Speichertechnologien verzerren das Signal praktisch nicht.

Einer der unbestreitbaren Vorteile digitaler Technologien ist die Fähigkeit, ein leistungsfähiges mathematisches Gerät anzuwenden, um Video- und Audioinformationen in ein digitalisiertes Signal zu komprimieren. Im Gegensatz zu “analog” kann “digital” jederzeit mit 100% Wiederholbarkeit reproduziert werden. Folglich eröffnet das digitalisierte Signal bequeme Nachbearbeitungs-, Analyse- und Simulationsoptionen.

Die wichtigsten Videokomprimierungsmethoden bestehen darin, Daten innerhalb eines einzelnen Frames zu komprimieren und die Übertragung von Änderungen zwischen Frames zu optimieren. Selbst wenn Sie sich ein Standbild ansehen, können Sie feststellen, dass es viele Informationen desselben Typs und doppelte Informationen enthält. Beispielsweise ist die Hintergrundintensität normalerweise ein konstanter Wert; Viele separate Bereiche des Bildes, die erhebliche Bildgrößen einnehmen, haben auch den gleichen digitalen Signalpegel. Natürlich macht es keinen Sinn, all diese Informationen ohne Komprimierung zu übertragen. Durch die Verwendung spezieller Videokomprimierungstechniken, die sich Frame für Frame reibungslos ändern, ist es möglich, die resultierende Dichte der Informationsübertragung über das Netzwerk weiter zu reduzieren.

Im Gegensatz zu universellen Archivierern (wie WinRar oder WinZip) kann die Videokomprimierung mit einem gewissen Verlust erfolgen, dessen Höhe vom ausgewählten Codec abhängt. Moderne Komprimierungsalgorithmen verwenden eine umfassende logische Analyse des Videos, um doppelte Fragmente zwischen Frames zu extrahieren und die Größe der endgültigen Datei zu reduzieren. Während der Wiedergabe werden die komprimierten Informationen “gestreckt” und dann dem Benutzer angezeigt. Auf einem Computer mit geringem Stromverbrauch kann das Dekomprimieren von mit einigen Codecs komprimierten Bildern lange dauern.

Digitale Videokomprimierungstechnologien
Es gibt viele digitale Videokomprimierungstechnologien. Einige der in Betracht gezogenen Kompressoren verwenden mehr als eine Kompressionstechnologie, jedoch eine Kombination davon. Beispielsweise verwenden sowohl Indeo 3.2 als auch Cinepak eine Vektorquantisierung. Die internationalen Standards MPEG-1, MPEG-2, MPEG-4, H.261 und H.263 verwenden eine kombinierte BDKP-Technologie und Bewegungskompensation. Einige moderne Algorithmen verwenden die DWT-Technologie (Discrete Wavelet Transform). Andere Technologien umfassen die fraktale Bildkomprimierung.

Verlustfreie Kompression

Die Bildkomprimierung kann nur dann ohne Qualitätsverlust durchgeführt werden, wenn während des Komprimierungsprozesses kein Datenverlust aufgetreten ist. Infolgedessen stimmt das nach der Dekomprimierung erhaltene Bild genau (Stück für Stück) mit dem Original überein. Beispiele für eine solche Komprimierung sind GIF für statische Grafiken und GIF89a für Videos.

Verlustbehaftete Komprimierung

Die Komprimierung kann verlustbehaftet sein, wenn während des Komprimierungsprozesses Informationen verloren gehen. Unter dem Gesichtspunkt der menschlichen Wahrnehmung sollte eine verlustbehaftete Komprimierung jedoch nur als die Komprimierung betrachtet werden, bei der es möglich ist, das Ergebnis der Komprimierung mit bloßem Auge vom Original zu unterscheiden. Obwohl zwei Bilder, das Original und das Ergebnis der Komprimierung mit dem einen oder anderen Kompressor, möglicherweise nicht nach und nach zusammenfallen, ist der Unterschied zwischen ihnen möglicherweise völlig unmerklich. Beispiele hierfür sind der JPEG-Algorithmus zum Komprimieren statischer Grafiken und der M-JPEG-Algorithmus zum Komprimieren von Videos.

Verlustfreie Komprimierung aus Wahrnehmungsperspektive

Als formal verlustbehaftete Komprimierung kann ein Komprimierungsschema gleichzeitig in Bezug auf die menschliche Wahrnehmung verlustfrei erscheinen. Die meisten verlustbehafteten Komprimierungstechnologien haben den sogenannten Compression Quality Factor (QF), der die wahrgenommene Qualitätsseite charakterisiert und zwischen 0 und 100 liegt.

Informationen zur Videokomprimierung

Informationen zur Videokomprimierung

Video Compression

Im Laufe der Tage steigen die Anforderungen an die Videoqualität ständig.

Video Compression

Gleichzeitig könnten Kanalbreite und Medienkapazität nicht mit diesem Wachstum Schritt halten, wenn die Videokomprimierungsalgorithmen nicht verbessert würden.
Als nächstes werden wir über einige der Grundlagen der Videokomprimierung sprechen. Einige von ihnen sind etwas veraltet oder zu einfach beschrieben, geben aber gleichzeitig eine minimale Vorstellung davon, wie alles funktioniert.

Video-Streaming-Funktionen

Fast jeder weiß, dass jedes Video eine Sammlung von Standbildern ist, die sich im Laufe der Zeit gegenseitig ersetzen. Im Folgenden nennen wir diesen geordneten Set-Videostream. Sie sind unterschiedlich, daher ist es äußerst nützlich, hier eine kleine Klassifizierung vorzunehmen:
Pixelformat. Das Pixel gibt uns nicht mehr Informationen als seine Farbe. Die Farbwahrnehmung ist jedoch sehr subjektiv, und es wurden große Anstrengungen unternommen, um Farbwiedergaben und Wiedergabesysteme zu erstellen, die für die meisten Menschen akzeptabel sind. Die Farbe, die wir in der realen Welt sehen, ist im Hinblick auf das Frequenzspektrum des Lichts recht komplex, was es äußerst schwierig macht, es in digitaler Form zu übertragen und noch mehr anzuzeigen. Es wurde jedoch beobachtet, dass die drei Punkte des Spektrums die angezeigte Farbe in der Metrik der Farbwahrnehmung durch einen gewöhnlichen Menschen ziemlich genau näher an die Gegenwart bringen können. Diese drei Punkte sind rot, grün und blau. Das heißt, aufgrund seiner linearen Kombination können wir den größten Teil des Spektrums sichtbarer Farben abdecken. Der einfachste Weg, ein Pixel darzustellen, ist daher: RGB24, wobei genau 8 Informationsbits für die roten, grünen und blauen Komponenten zugewiesen werden. So können wir 256 Abstufungen jeder Farbe und insgesamt 16.777.216 aller Arten von Farbtönen übertragen. In der Praxis wird diese Farbdarstellung während der Speicherung praktisch nicht verwendet, nicht nur, weil wir bis zu 3 Bytes pro Pixel ausgeben, sondern auch aus anderen Gründen, aber dazu später mehr (auf YV12).
Rahmengröße. Wir erfassen und codieren bereits alle Pixel im Videostream und empfangen viele Daten, aber es ist unpraktisch, damit zu arbeiten. Am Anfang ist alles sehr einfach, der Rahmen zeichnet sich aus durch: Breite, Höhe, Größe des sichtbaren Teils und Format (dazu später mehr). Hier werden die Zahlen wahrscheinlich vielen bekannt sein: 640 x 480, 720 x 480, 720 x 576, 1280 x 720, 1920 x 1080. Warum? Ja, da sie in unterschiedlichen Standards erscheinen, haben beispielsweise die meisten europäischen DVDs eine Auflösung von 720 x 576. Nein, natürlich können Sie ein 417×503-Video erstellen, aber ich denke nicht, dass daran etwas Gutes ist.

Rahmenformat. Selbst wenn wir die Größe des Rahmens kennen, können wir das Pixelarray nicht bequemer darstellen, ohne zu wissen, wie der Rahmen “gepackt” wird. Im einfachsten Fall gibt es nichts Kompliziertes: Wir nehmen eine Reihe von Pixeln und schreiben die Bits jedes codierten Pixels in eine Reihe und so weiter Zeile für Zeile. Das heißt, wir schreiben so viele Zeilen, wie wir groß sind, um so viele Pixel wie wir breit und alle in einer Reihe, in der Reihenfolge. Dies nennt man progressiv. Aber vielleicht haben Sie versucht, Fernsehsendungen auf einem Computer ohne die richtigen Einstellungen anzusehen und den “Kämmeffekt” gesehen. In diesem Fall befindet sich dasselbe Objekt in unterschiedlichen Positionen relativ zu den ungeraden und geraden Linien. Sie können lange über die Wünschbarkeit von Interlaced-Scans (Interlaced-Scannen) streiten, aber die Wahrheit ist, dass es ein Relikt der Vergangenheit des traditionellen Fernsehens geblieben ist (diejenigen, die daran interessiert sind, über das Kinescope-Gerät zu lesen). Ich werde jetzt nicht über Methoden sprechen, um diesen unangenehmen Effekt zu entfernen (deinterlace). Hierher kommen die magischen Bezeichnungen: 576i, 720p, 1080i, 1080p, wobei die Anzahl der Zeilen (Rahmenhöhe) und die Art des Scans angegeben sind.
Bildrate. Einige der Standardwerte: 23.976, 24, 25 und 29.97 Bilder pro Sekunde. Beispielsweise werden im europäischen Fernsehen 25 fps, im amerikanischen Fernsehen 29,97 und in Filmen 24 fps verwendet. Aber woher kamen die “Fremden” 23.976 und 29.97? Lassen Sie mich Ihnen ein Geheimnis verraten: 23.976 = 24 / 1.001 und 29.97 = 30 / 1.001, dh der 1.001-Divisor ist im amerikanischen NTSC-Broadcast-Standard enthalten. Wenn der Film gezeigt wird, kommt es folglich zu einer geringfügigen Verlangsamung, die für den Zuschauer nicht erkennbar ist. Wenn es sich jedoch um ein Musikkonzert handelt, ist die Geschwindigkeit der Show so kritisch, dass es besser ist, gelegentlich Frames und erneut die zu überspringen Der Betrachter wird nichts bemerken.