Digitales Video, seine Vorteile


Free Download Mp4Gain
picture

Digitales Video, seine Vorteile

DIGITAL VIDEO

Digitale Technologien bieten unbestreitbare Vorteile gegenüber analogen Technologien.
Digital Video

Das digitalisierte Signal kann alle in analoger Form gespeicherten Informationen speichern. Moderne digitale Datenübertragungs-, Aufzeichnungs- und Speichertechnologien verzerren das Signal praktisch nicht.

Einer der unbestreitbaren Vorteile digitaler Technologien ist die Fähigkeit, ein leistungsfähiges mathematisches Gerät anzuwenden, um Video- und Audioinformationen in ein digitalisiertes Signal zu komprimieren. Im Gegensatz zu “analog” kann “digital” jederzeit mit 100% Wiederholbarkeit reproduziert werden. Folglich eröffnet das digitalisierte Signal bequeme Nachbearbeitungs-, Analyse- und Simulationsoptionen.

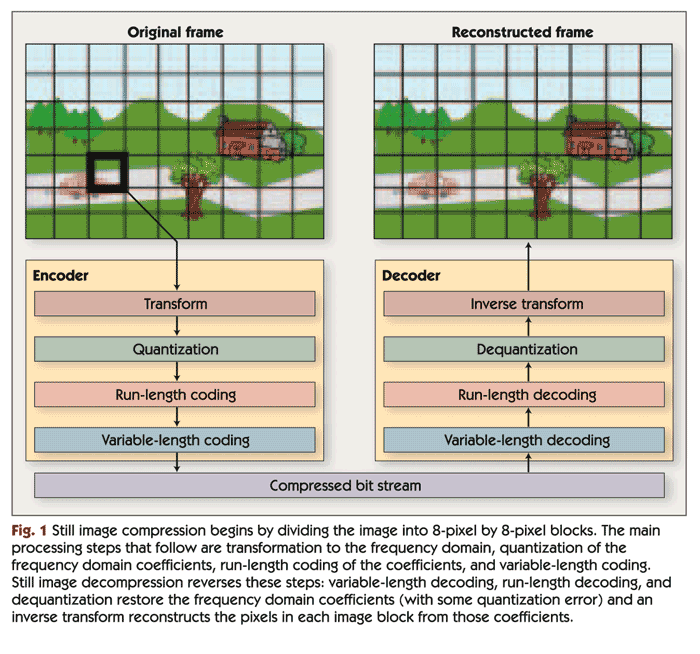
Die wichtigsten Videokomprimierungsmethoden bestehen darin, Daten innerhalb eines einzelnen Frames zu komprimieren und die Übertragung von Änderungen zwischen Frames zu optimieren. Selbst wenn Sie sich ein Standbild ansehen, können Sie feststellen, dass es viele Informationen desselben Typs und doppelte Informationen enthält. Beispielsweise ist die Hintergrundintensität normalerweise ein konstanter Wert; Viele separate Bereiche des Bildes, die erhebliche Bildgrößen einnehmen, haben auch den gleichen digitalen Signalpegel. Natürlich macht es keinen Sinn, all diese Informationen ohne Komprimierung zu übertragen. Durch die Verwendung spezieller Videokomprimierungstechniken, die sich Frame für Frame reibungslos ändern, ist es möglich, die resultierende Dichte der Informationsübertragung über das Netzwerk weiter zu reduzieren.

Im Gegensatz zu universellen Archivierern (wie WinRar oder WinZip) kann die Videokomprimierung mit einem gewissen Verlust erfolgen, dessen Höhe vom ausgewählten Codec abhängt. Moderne Komprimierungsalgorithmen verwenden eine umfassende logische Analyse des Videos, um doppelte Fragmente zwischen Frames zu extrahieren und die Größe der endgültigen Datei zu reduzieren. Während der Wiedergabe werden die komprimierten Informationen “gestreckt” und dann dem Benutzer angezeigt. Auf einem Computer mit geringem Stromverbrauch kann das Dekomprimieren von mit einigen Codecs komprimierten Bildern lange dauern.

Digitale Videokomprimierungstechnologien
Es gibt viele digitale Videokomprimierungstechnologien. Einige der in Betracht gezogenen Kompressoren verwenden mehr als eine Kompressionstechnologie, jedoch eine Kombination davon. Beispielsweise verwenden sowohl Indeo 3.2 als auch Cinepak eine Vektorquantisierung. Die internationalen Standards MPEG-1, MPEG-2, MPEG-4, H.261 und H.263 verwenden eine kombinierte BDKP-Technologie und Bewegungskompensation. Einige moderne Algorithmen verwenden die DWT-Technologie (Discrete Wavelet Transform). Andere Technologien umfassen die fraktale Bildkomprimierung.

Verlustfreie Kompression

Die Bildkomprimierung kann nur dann ohne Qualitätsverlust durchgeführt werden, wenn während des Komprimierungsprozesses kein Datenverlust aufgetreten ist. Infolgedessen stimmt das nach der Dekomprimierung erhaltene Bild genau (Stück für Stück) mit dem Original überein. Beispiele für eine solche Komprimierung sind GIF für statische Grafiken und GIF89a für Videos.

Verlustbehaftete Komprimierung

Die Komprimierung kann verlustbehaftet sein, wenn während des Komprimierungsprozesses Informationen verloren gehen. Unter dem Gesichtspunkt der menschlichen Wahrnehmung sollte eine verlustbehaftete Komprimierung jedoch nur als die Komprimierung betrachtet werden, bei der es möglich ist, das Ergebnis der Komprimierung mit bloßem Auge vom Original zu unterscheiden. Obwohl zwei Bilder, das Original und das Ergebnis der Komprimierung mit dem einen oder anderen Kompressor, möglicherweise nicht nach und nach zusammenfallen, ist der Unterschied zwischen ihnen möglicherweise völlig unmerklich. Beispiele hierfür sind der JPEG-Algorithmus zum Komprimieren statischer Grafiken und der M-JPEG-Algorithmus zum Komprimieren von Videos.

Verlustfreie Komprimierung aus Wahrnehmungsperspektive

Als formal verlustbehaftete Komprimierung kann ein Komprimierungsschema gleichzeitig in Bezug auf die menschliche Wahrnehmung verlustfrei erscheinen. Die meisten verlustbehafteten Komprimierungstechnologien haben den sogenannten Compression Quality Factor (QF), der die wahrgenommene Qualitätsseite charakterisiert und zwischen 0 und 100 liegt.


Free Download Mp4Gain
picture

Informationen zur Videokomprimierung

Informationen zur Videokomprimierung

Video Compression

Im Laufe der Tage steigen die Anforderungen an die Videoqualität ständig.

Video Compression

Gleichzeitig könnten Kanalbreite und Medienkapazität nicht mit diesem Wachstum Schritt halten, wenn die Videokomprimierungsalgorithmen nicht verbessert würden.
Als nächstes werden wir über einige der Grundlagen der Videokomprimierung sprechen. Einige von ihnen sind etwas veraltet oder zu einfach beschrieben, geben aber gleichzeitig eine minimale Vorstellung davon, wie alles funktioniert.

Video-Streaming-Funktionen

Fast jeder weiß, dass jedes Video eine Sammlung von Standbildern ist, die sich im Laufe der Zeit gegenseitig ersetzen. Im Folgenden nennen wir diesen geordneten Set-Videostream. Sie sind unterschiedlich, daher ist es äußerst nützlich, hier eine kleine Klassifizierung vorzunehmen:
Pixelformat. Das Pixel gibt uns nicht mehr Informationen als seine Farbe. Die Farbwahrnehmung ist jedoch sehr subjektiv, und es wurden große Anstrengungen unternommen, um Farbwiedergaben und Wiedergabesysteme zu erstellen, die für die meisten Menschen akzeptabel sind. Die Farbe, die wir in der realen Welt sehen, ist im Hinblick auf das Frequenzspektrum des Lichts recht komplex, was es äußerst schwierig macht, es in digitaler Form zu übertragen und noch mehr anzuzeigen. Es wurde jedoch beobachtet, dass die drei Punkte des Spektrums die angezeigte Farbe in der Metrik der Farbwahrnehmung durch einen gewöhnlichen Menschen ziemlich genau näher an die Gegenwart bringen können. Diese drei Punkte sind rot, grün und blau. Das heißt, aufgrund seiner linearen Kombination können wir den größten Teil des Spektrums sichtbarer Farben abdecken. Der einfachste Weg, ein Pixel darzustellen, ist daher: RGB24, wobei genau 8 Informationsbits für die roten, grünen und blauen Komponenten zugewiesen werden. So können wir 256 Abstufungen jeder Farbe und insgesamt 16.777.216 aller Arten von Farbtönen übertragen. In der Praxis wird diese Farbdarstellung während der Speicherung praktisch nicht verwendet, nicht nur, weil wir bis zu 3 Bytes pro Pixel ausgeben, sondern auch aus anderen Gründen, aber dazu später mehr (auf YV12).
Rahmengröße. Wir erfassen und codieren bereits alle Pixel im Videostream und empfangen viele Daten, aber es ist unpraktisch, damit zu arbeiten. Am Anfang ist alles sehr einfach, der Rahmen zeichnet sich aus durch: Breite, Höhe, Größe des sichtbaren Teils und Format (dazu später mehr). Hier werden die Zahlen wahrscheinlich vielen bekannt sein: 640 x 480, 720 x 480, 720 x 576, 1280 x 720, 1920 x 1080. Warum? Ja, da sie in unterschiedlichen Standards erscheinen, haben beispielsweise die meisten europäischen DVDs eine Auflösung von 720 x 576. Nein, natürlich können Sie ein 417×503-Video erstellen, aber ich denke nicht, dass daran etwas Gutes ist.

Rahmenformat. Selbst wenn wir die Größe des Rahmens kennen, können wir das Pixelarray nicht bequemer darstellen, ohne zu wissen, wie der Rahmen “gepackt” wird. Im einfachsten Fall gibt es nichts Kompliziertes: Wir nehmen eine Reihe von Pixeln und schreiben die Bits jedes codierten Pixels in eine Reihe und so weiter Zeile für Zeile. Das heißt, wir schreiben so viele Zeilen, wie wir groß sind, um so viele Pixel wie wir breit und alle in einer Reihe, in der Reihenfolge. Dies nennt man progressiv. Aber vielleicht haben Sie versucht, Fernsehsendungen auf einem Computer ohne die richtigen Einstellungen anzusehen und den “Kämmeffekt” gesehen. In diesem Fall befindet sich dasselbe Objekt in unterschiedlichen Positionen relativ zu den ungeraden und geraden Linien. Sie können lange über die Wünschbarkeit von Interlaced-Scans (Interlaced-Scannen) streiten, aber die Wahrheit ist, dass es ein Relikt der Vergangenheit des traditionellen Fernsehens geblieben ist (diejenigen, die daran interessiert sind, über das Kinescope-Gerät zu lesen). Ich werde jetzt nicht über Methoden sprechen, um diesen unangenehmen Effekt zu entfernen (deinterlace). Hierher kommen die magischen Bezeichnungen: 576i, 720p, 1080i, 1080p, wobei die Anzahl der Zeilen (Rahmenhöhe) und die Art des Scans angegeben sind.
Bildrate. Einige der Standardwerte: 23.976, 24, 25 und 29.97 Bilder pro Sekunde. Beispielsweise werden im europäischen Fernsehen 25 fps, im amerikanischen Fernsehen 29,97 und in Filmen 24 fps verwendet. Aber woher kamen die “Fremden” 23.976 und 29.97? Lassen Sie mich Ihnen ein Geheimnis verraten: 23.976 = 24 / 1.001 und 29.97 = 30 / 1.001, dh der 1.001-Divisor ist im amerikanischen NTSC-Broadcast-Standard enthalten. Wenn der Film gezeigt wird, kommt es folglich zu einer geringfügigen Verlangsamung, die für den Zuschauer nicht erkennbar ist. Wenn es sich jedoch um ein Musikkonzert handelt, ist die Geschwindigkeit der Show so kritisch, dass es besser ist, gelegentlich Frames und erneut die zu überspringen Der Betrachter wird nichts bemerken.

Videokomprimierung, wie es funktioniert

Videokomprimierung, wie es funktioniert

Video Compression

Video – Dies ist im Wesentlichen eine dreidimensionale Pixelfarbmatrix. Zwei Messungen zeigen die vertikale und horizontale Auflösung des Rahmens und diesmal die dritte Dimension an. Rahmen – ist eine Anordnung von Pixeln, eine zu diesem Zeitpunkt sichtbare Kamera oder nur ein Bild. Video ist auch möglich, sogenannte Halbbilder (siehe: Interlace Scan System).

Video Compression

Eine Komprimierung könnte unmöglich sein, wenn ich würde, dass jeder Frame einzigartig ist und die Pixelplatzierung völlig zufällig ist, aber das ist nicht so. Daher können Sie zunächst das Bild selbst komprimieren. Beispielsweise wird das himmelblaue Foto ohne Sonne tatsächlich auf die gepunktete Umrissbeschreibung und eine Verlaufsfüllung reduziert. In – Zweitens können Sie ähnliche benachbarte Frames komprimieren. Letztendlich sind die Algorithmen für die Bild- und Videokomprimierung ähnlich, wenn Sie Video als dreidimensionales Bild mit der Zeit als dritter Koordinate betrachten.

Verlustfreie Kompression
Zusätzlich zur verlustbehafteten Videokomprimierung kann sie auch komprimiert und verlustfrei sein. Dies bedeutet, dass das Dekomprimierungsergebnis eine Genauigkeit (Bitbits) aufweist, die mit der des Originals übereinstimmt. Wenn jedoch eine verlustfreie Komprimierung nicht möglich ist, können in realen (nicht künstlichen) Videos hohe Komprimierungsverhältnisse erzielt werden. Aus diesem Grund werden fast alle häufig verwendeten Videos verlustbehaftet komprimiert (um diese Zahl auf digitalen Video-Discs für Verbraucher, Video-Sharing, Satellitenübertragung). Auf den Websites für kleine Clips ohne Ton werden manchmal einfache GIF- und APNG-Formate verwendet.

Komprimierungstechnologie und Videokompensationsbewegung
Eine der leistungsstärksten Technologien, die es ermöglicht, den Kompressionsgrad zu erhöhen, ist diese Kompensationsbewegung. Wenn ein modernes Videokomprimierungssystem spätere Frames in der Sequenz die Ähnlichkeit von Regionen in den vorherigen Frames verwendet, um den Komprimierungsgrad zu erhöhen. Da jedoch für jeden Verkehr Objekte im Bild (oder in der Kamera selbst) vorhanden waren, war die Verwendung der Ähnlichkeit benachbarter Bilder unvollständig. Mit der Bewegungskompensationstechnologie können Sie ähnliche Websites finden, auch wenn diese vom vorherigen Frame abweichen.

Der aktuelle Stand der Dinge

РЕКЛАМА
Cm. Siehe auch: HTML5-Video
Ende 2011 des Jahres komprimieren fast alle Algorithmen das Video (z. B. die von ITU-T und ISO übernommenen Standards) mithilfe einer diskreten Cosinustransformation (DCT) oder deren Modifikation, um räumliche Redundanz zu beseitigen. Andere Methoden, wie eine fraktale Komprimierung und eine diskrete Wavelet-Transformation, wurden ebenfalls untersucht, werden jedoch im Allgemeinen nur noch zur Komprimierung von Standbildern verwendet.

Die Verwendung der meisten Komprimierungsmethoden (wie der diskreten Cosinustransformation und der Wavelet-Umwandlung) beinhaltet auch die Verwendung des Quantisierungsprozesses. Quantisierung kann wie Skalar sein, also und Vektor, so dass es weniger gibt, verwenden die meisten Komprimierungsschemata in der Praxis Skalarquantisierung für ihre Einfachheit.

Fernsehen
Moderne digitale Fernsehsendungen sind genau dank der Videokomprimierung verfügbar. Der Fernsehsender kann nicht nur HD-Videos (HDTV) übertragen, sondern auch mehrere Kanäle auf einem physischen Kanal (6 MHz).

Obwohl der größte Teil des heutigen Videoinhalts unter Verwendung des MPEG-2-Videokomprimierungsstandards ausgestrahlt wird, sind die nicht weniger neuen und effizienteren Standards für die Videokomprimierung bereits im Rundfunk verwendet – zum Beispiel H. . 264 und VC – 1.

Was ist das beste Videoformat?

Was ist das beste Videoformat?

Best Video Format

Welches Videoformat ist besser?

Video compression

Derzeit haben Sie eine Vielzahl von Optionen zum Speichern und Präsentieren digitaler Multimedia-Informationen. Es gibt viele verschiedene Videoformate, jedes mit seinen eigenen einzigartigen Eigenschaften. In einer solchen Situation stellt sich natürlich die Frage, welches Videoformat besser ist.

Um Informationen in digitale Form umzuwandeln, werden spezielle Programme verwendet – Codecs. Sie erstellen eine spezielle Datei – einen Container, in dem alle Daten gespeichert sind. Diese beiden Konzepte sollten nicht verwechselt werden, da sie völlig unterschiedliche Funktionen erfüllen.

Die folgende Codec-Definition finden Sie auf Wikipedia. Ein Codec ist ein spezielles Computerprogramm, das einen Datenstrom oder ein Signal zur späteren Verwendung konvertiert. Codecs transformieren die verfügbaren Informationen, um sie optimaler und kompakter zu speichern. In diesem Fall bleibt die Hauptstruktur der Datei (des Containers) dieselbe, nur die Art und Weise, wie die Daten dargestellt werden, ändert sich. Die beliebtesten Codecs für die Videoaufzeichnung sind: DivX, XviD, MPEG2, H.264 usw. Wenn Sie einen Film aufnehmen oder beispielsweise online eine Diashow erstellen möchten, müssen Sie entscheiden, welcher Videocodec verwendet werden soll.

XviD ist ein moderner MPEG4-Codec. Ermöglicht das Erhalten von hochauflösenden Bildern in dynamischen Szenen. Gehen Sie daher bei der Auswahl eines Codecs von den Merkmalen und Merkmalen der Videodatei selbst aus. Auf diese Weise können Sie nachvollziehen, welches Videoformat für einen bestimmten Fall am besten geeignet ist. Im Gegensatz zu DivX ist XviD freie Software, die unter der GNU-Lizenz veröffentlicht wird.

Welches Videoformat ist besser?
DivX ist einer der beliebtesten Video-Codecs. Bietet qualitativ hochwertige Bilder. Die mit diesem Codec konvertierten Dateien sind klein und können auf fast allen modernen DVD-Playern angezeigt werden. Ab der fünften Version haben Sie für die Codierung bezahlt.

H.264. Im Vergleich zu den beiden vorherigen Video-Codecs ist H.264 effizienter und bietet höhere Komprimierungsraten, ohne die Qualität zu beeinträchtigen. In der Regel fehlt dieser Codec jedoch zunächst auf dem Computer und muss zusätzlich installiert werden.

MPEG2 ist ein beliebter Videostandard, der im digitalen Fernsehen aktiv zur schnellen Informationsübertragung eingesetzt wird. Darüber hinaus wird der MPEG2-Codec beim Aufnehmen von DVDs sowie in Videokomprimierungssystemen verwendet.

Angenommen, Sie stehen vor einer bestimmten praktischen Aufgabe: dem Erstellen einer Video-Diashow. Was ist das beste Videoformat für die Aufnahme? Zunächst müssen Sie fortfahren, von wo aus Sie die erstellte Videodatei verwenden. Wenn Sie beispielsweise ein fertiges Video in einen Video-Hosting-Dienst einfügen möchten, verwenden Sie den H.264-Codec, mit dem Sie einen erheblichen Grad an Datenkomprimierung bei minimalem Qualitätsverlust erzielen können. Der PhotoSHOW-Diashow-Hersteller von AMS Software enthält einen vollständigen Satz moderner Video-Codecs und ermöglicht es Ihnen, spektakuläre Diashows aus Fotos in professioneller Qualität zu erstellen.

Die Codecs konvertieren die Informationen dann in eine spezielle Datei, die als Container bezeichnet wird. Ein Container ist eine Art Shell, in der die von Codecs konvertierten Informationen digital gespeichert werden. Die Containerstruktur ist heterogen und umfasst mehrere Komponenten: Videostream, Audiostream, verschiedene zusätzliche Informationen (Dateiinformationen, Titel usw.). Daher kann der Container selbst keine Informationen konvertieren, sondern dient nur zum Speichern. Die gebräuchlichsten Container sind AVI, TS, MP4, MKV. Schauen wir uns einige davon genauer an, um die Frage zu beantworten, welches Videoformat das beste ist.

AVI (Audio-Video Interleaved): bedeutet wörtlich “Interlaced Audio und Video”. Es ist ein universeller Container zum Speichern von Informationen verschiedener Arten. Die AVI-Datei kann Video-, Ton-, Textinformationen usw. enthalten. Es kann auch mehrere Audio-Streams geben. Beim Erstellen einer AVI-Datei kann eine Vielzahl von Codecs verwendet werden. Dieses Videoformat ist ähnlichen Videostandards aufgrund der Benutzerfreundlichkeit und der Vielzahl von Videoaufzeichnungsfunktionen überlegen.

MKV ist ein frei verteilter Container, der als “Matroska” -Projekt bekannt ist. In diesem Multimedia-Container können Sie eine große Menge einer Vielzahl von Informationen speichern, einschließlich Audiospuren in verschiedenen Sprachen, Untertiteln, spezielle Videokapitel usw. erstellen. Das Hauptmerkmal dieses Formats ist die Offenheit des Codes, die es Programmierern aus aller Welt ermöglicht, ihn zu bearbeiten und zu verbessern. Beim Vergleich von AVI mit MKV ist das letztere Videoformat in den meisten Parametern besser als das erstere. Der MKV-Container verfügt über alle erforderlichen Parameter zum Speichern von Videodateien und wird immer beliebter