MP3 digitales Audioformat

Hochwertiges digitalisiertes Audio erfordert viel Speicherplatz.

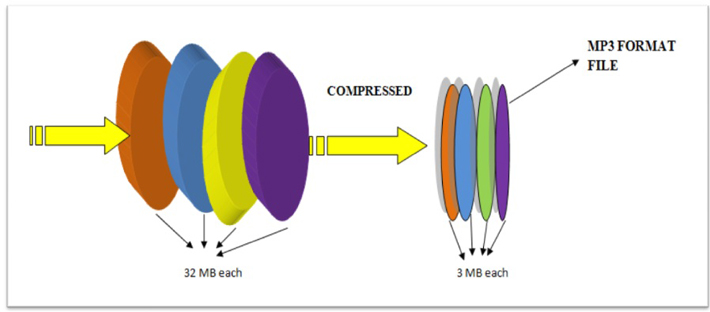
Versuche, die Größe von Dateien mithilfe von Standardarchivierern (RAR, GZIP usw.) zu reduzieren, führen aufgrund der Spezifität der Audiodaten nicht zu signifikanten Gewinnen. Es ist jedoch möglich, mit speziellen Methoden, die auf der Analyse der Datenstruktur und der anschließenden Komprimierung mit einigen Verlusten basieren, ein ziemlich signifikantes Maß an Komprimierung der Audioinformationen zu erreichen.
Die reale Möglichkeit einer Klangverarbeitung, deren Qualität mit den vorhandenen analogen Beispielen vergleichbar ist, trat erst Ende der 1980er Jahre auf.
1988 bildete die Internationale Organisation für Normung (ISO) das MPEG-Komitee (Moving Picture Experts Group), dessen Hauptaufgabe darin besteht, Standards für die Kodierung von bewegten Bildern, Ton und deren Kombination zu entwickeln. In den zehn Jahren seines Bestehens hat das Komitee eine Reihe von Normen zu diesem Thema entwickelt. Zusammenfassend wurden mehrere spezifische Formate für die Speicherung von Daten empfohlen, die sich durch hervorragende Qualität der Ergebnisse und Datenfluss auszeichnen.
Derzeit gibt es drei Videospeicherstandards: MPEG-1, MPEG-2 und MPEG-4.
Innerhalb der ersten beiden Formate gibt es auch Formate zum Speichern von Audioinformationen: Layer-1, Layer-2 und Layer-3. Diese drei Audioformate sind für MPEG-1 definiert und kleinere Erweiterungen werden in MPEG-2 verwendet. Die drei Formate sind einander ähnlich, verwenden jedoch unterschiedliche Kompromisse zwischen Komprimierung und Komplexität.
Schicht-1 ist die einfachste, erfordert keine signifikanten Komprimierungskosten, bietet aber auch ein vernachlässigbares Komprimierungsverhältnis.
Layer-3 ist am zeitaufwändigsten und bietet die beste Komprimierung. In letzter Zeit hat dieses Format immense Popularität erlangt. Es wird oft als MP3 bezeichnet. Dieser Name ist mit der Erweiterung der in diesem Format gespeicherten Audiodateien verbunden.
Die Grundidee aller verlustbehafteten Audiokomprimierungstechniken besteht darin, die subtilen Details des Originaltons zu vernachlässigen, die außerhalb der Reichweite des menschlichen Ohrs liegen. Hier können mehrere Punkte hervorgehoben werden.
Geräuschpegel . Die Klangkomprimierung basiert auf einer einfachen Tatsache: Wenn sich eine Person in der Nähe einer lauten Sirene befindet, ist es unwahrscheinlich, dass sie die Konversation der Personen in der Nähe hört. Und dies geschieht nicht, weil eine Person einem lauten Geräusch große Aufmerksamkeit schenkt, sondern in größerem Maße, weil das menschliche Ohr tatsächlich Geräusche übersieht, die im gleichen Frequenzbereich wie ein lauteres Geräusch liegen. Dieser Effekt wird als Maskierung bezeichnet und ändert sich mit dem Unterschied in Lautstärke und Frequenz des Klangs.
Der zweite Punkt ist die Aufteilung des Audiofrequenzbandes in Teilbänder, von denen jedes separat weiterverarbeitet wird. Das Codierungsprogramm extrahiert die lautesten Töne in jedem Band und verwendet diese Informationen, um einen akzeptablen Rauschpegel für dieses Band zu bestimmen. Die besten Codierungsprogramme berücksichtigen auch den Einfluss benachbarter Bänder. Ein sehr lauter Ton in einem Band kann den Maskierungseffekt und benachbarte Bänder beeinflussen.
Ein weiterer Punkt der Kodifizierung ist die Verwendung eines psychoakustischen Modells, das auf den Besonderheiten der menschlichen Wahrnehmung von Schall basiert. Die von diesem Modell verwendete Komprimierung basiert auf dem Entfernen von Frequenzen, von denen bekannt ist, dass sie unhörbar sind, während Geräusche, die vom menschlichen Ohr leicht gehört werden können, sorgfältiger beibehalten werden. Leider kann es hier keine genauen mathematischen Formeln geben.
Die menschliche Wahrnehmung von Geräuschen ist ein komplexer Prozess, der nicht vollständig verstanden wird. Daher basiert die Auswahl der Komprimierungsmethoden auf der Analyse des Hörens und dem unterschiedlichen Vergleich komprimierter Geräusche durch Expertenteams. Hier gibt es jedoch praktisch unbegrenzte Möglichkeiten, psychoakustische Modelle zu verbessern. Die meisten der vorhandenen Algorithmen zum Codieren der menschlichen Stimme basieren auf der hohen Vorhersagbarkeit des Signals; Universelle MPEG-Komprimierungsalgorithmen haben versucht, diese Technik mit variablem Erfolg anzuwenden.
Eine weitere Komprimierungstechnik ist die Verwendung von sogenanntem Joint Stereo. Es ist bekannt, dass das menschliche Hörgerät nur die Richtung der Mittenfrequenzen, des hohen und des niedrigen Tons sozusagen getrennt von der Quelle bestimmen kann. Dies bedeutet, dass diese Hintergrundfrequenzen in ein Monosignal codiert werden können. Darüber hinaus nutzt die Komprimierung den Unterschied in der Komplexität der Flüsse in den Kanälen.