Wie funktioniert die Codierung in digitalem Audio?


Free Download Mp4Gain
picture

Wie funktioniert die Codierung in digitalem Audio?

encoding digital audio

Haben Sie sich jemals gefragt, wie Ton auf digitalen Geräten wiedergegeben wird? Wie entsteht ein Tonsignal aus einer Kombination von Einsen und Nullen?

encoding digital audio

Ich bin sicher, ich habe nachgedacht, seit ich angefangen habe zu lesen! Aber selbst Profis haben oft nur eine allgemeine Vorstellung von der modernen Klangroute. In diesem Artikel erfahren Sie, wie die verschiedenen Formate angezeigt wurden, was ein Digital-Analog-Wandler ist, welche Arten von DACs es gibt und was die Qualität der Tonwiedergabe bestimmt.

PCM
Wie Sie wissen, wird bei digitalem Audio mit seltenen Ausnahmen fast jedes Format mit einem Pulscodestream oder einem PCM-Stream aufgezeichnet – Pulscodemodulation. FLAC, MP3, WAV, Audio-CD, DVD-Audio und andere Formate sind nur Möglichkeiten, den PCM-Stream zu packen und zu “bewahren”.

Wie alles begann
Die theoretischen Grundlagen der digitalen Schallübertragung wurden zu Beginn des 20. Jahrhunderts entwickelt, als Wissenschaftler versuchten, ein Audiosignal über große Entfernungen zu übertragen, jedoch nicht per Telefon, sondern auf eine für diese Zeit eher seltsame Weise.

Durch Aufteilen der Schallwelle in kleine Teile könnte sie in einer Art mathematischer Darstellung an den Empfänger gesendet werden. Der Empfänger könnte wiederum die ursprüngliche Wellenform wiederherstellen und die Aufnahme anhören. Darüber hinaus standen die Wissenschaftler vor der Aufgabe, die Bandbreite des “Äthers” zu erhöhen.

1933 wurde der Satz von V.A. Kotelnikov. In westlichen Quellen wird es als Nyquist-Shannon-Theorem bezeichnet. Ja, Harry Nyquist war der erste, der dieses Problem ansprach: 1927 berechnete er die minimale Abtastfrequenz für die Übertragung einer Wellenform, die später seinen Namen “Nyquist-Frequenz” erhielt, aber Kotelnikovs Theorem wurde 16 Jahre zuvor veröffentlicht.

Das Wesen des Satzes ist einfach: Ein kontinuierliches Signal kann in Form einer Interpolationsreihe dargestellt werden, die aus diskreten Berichten besteht, aus denen das Signal rekonstruiert werden kann. Um den ursprünglichen Zustand des Signals grob wiederherzustellen, muss die Abtastrate mindestens doppelt so hoch sein wie die obere Grenzfrequenz dieses Signals.

Bis zum Aufkommen des digitalen Zeitalters war der Satz viele Jahre lang nicht gefragt. Damals fand es eine Verwendung. Insbesondere war der Satz bei der Entwicklung des CDDA-Formats (Compact Disc Digital Audio) nützlich, das im Volksmund als Audio-CD oder Red Book bezeichnet wird. Das Format wurde 1980 von Ingenieuren bei Philips und Sony veröffentlicht und ist zum Standard für Audio-CDs geworden.

Formatmerkmale:

Abtastfrequenz – 44,1 kHz;
Quantisierungskapazität – 16 Bit.


Free Download Mp4Gain
picture

Digitale Audiokodierung

Digitale Audiokodierung

Digital audio encoding

Tatsächlich ist die eine oder andere digitale Form der Darstellung von analogen Audiosignalen bereits eine Codierungsmethode – eine Folge von Zahlen, die ein analoges Audiosignal beschreibt, ist selbst ein digitaler Code.

Digital Audio Encoding

Die Kodierung, über die wir jetzt sprechen werden, ist jedoch etwas anderes. Schauen wir uns nun die Methoden zum Codieren digitaler Audiosignale an.

Ein digitalisiertes Audiosignal “in seiner reinen Form” ist eine ziemlich genaue, aber nicht die kompakteste Art, das ursprüngliche analoge Signal aufzuzeichnen.

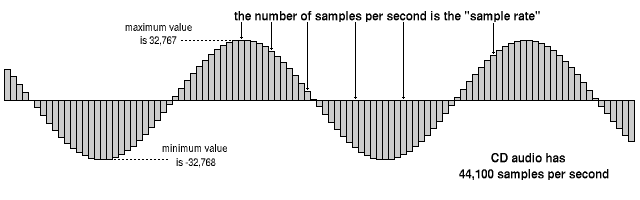
Urteile selbst. Um vollständige Informationen über das ursprüngliche analoge Signal im Frequenzbereich 0-20 kHz (im hörbaren Frequenzbereich) zu erhalten, muss das analoge Signal mit einer Frequenz von mindestens 40 kHz abgetastet werden. Daher legt der CD-DA-Standard (der Standard zum Aufzeichnen von Daten auf Audio-CDs, die allen bekannt sind) die folgenden Codierungsparameter fest: Aufzeichnen von zwei oder einem Kanal im PCM-Format mit einer Abtastfrequenz von 44,1 kHz und einer 16-Bit-Quantisierungsbittiefe . Eine Stunde Musik in diesem Format nimmt ungefähr 600 MB Speicherplatz ein (60 Minuten * 60 Sekunden * 2 Kanäle * 44100 Samples pro Sekunde * 2 Bytes pro Sample = ungefähr 605 MB). Wenn man berücksichtigt, dass beispielsweise die Musiksammlung eines gewöhnlichen Musikliebhabers 5.000 Titel mit einer durchschnittlichen Länge von jeweils etwa 3 Minuten enthält, ist der Speicherbedarf, der erforderlich ist, um sie in ihrer ursprünglichen digitalen Form zu speichern, ziemlich bedeutend. Daher erfordert das Speichern relativ großer Mengen von Audiodaten, um eine ziemlich gute Klangqualität sicherzustellen, die Verwendung verschiedener “Tricks”, um die Daten zu komprimieren.

Im Allgemeinen können alle vorhandenen Methoden zum Codieren von Audioinformationen bedingt in nur zwei Typen unterteilt werden.

1. Die verlustfreie Datenkomprimierung (“verlustfreie Codierung”) ist eine Methode zum Codieren (Komprimieren) digitaler Audioinformationen, die eine hundertprozentige Wiederherstellung der Originaldaten aus der komprimierten Übertragung ermöglicht (der Begriff “Originaldaten” bedeutet hier die ursprüngliche Form von die digitalisierten Audiodaten). Diese Methode der Datenkomprimierung wird in Fällen verwendet, in denen eine hundertprozentige absolute Erhaltung der Qualität der ursprünglichen Audiodaten erforderlich ist. Die heute existierenden verlustfreien Komprimierungsalgorithmen können das Datenvolumen um 20-50% reduzieren und gleichzeitig eine 100% ige Wiederherstellung des ursprünglichen digitalen Materials aus den komprimierten Daten gewährleisten. Die Betriebsmechanismen solcher Codierer ähneln den Betriebsmechanismen allgemeiner Datenarchivierer wie ZIP oder RAR, sind jedoch gleichzeitig speziell für die Komprimierung von Audiodaten angepasst. Verlustfreie Codierung Obwohl sie im Hinblick auf die Aufbewahrung ideal ist Aufgrund der Qualität der Audiomaterialien kann kein hohes Maß an Komprimierung erzielt werden.

2. Es gibt eine andere modernere Möglichkeit, Daten zu komprimieren. Diese sogenannte verlustbehaftete Datenkomprimierung (engl. “Lossy Coding”) Der Zweck der Codierung besteht darin, mit allen Mitteln die höchste Datenkomprimierungsrate zu erzielen und gleichzeitig die Klangqualität auf einem akzeptablen Niveau zu halten. Die Idee hinter verlustbehafteter Codierung basiert auf zwei einfachen Überlegungen:

Die ursprünglichen digitalen Audiodaten sind redundant: Sie enthalten viele unnötige Informationen, die für das Ohr unbrauchbar sind und entfernt werden können, wodurch das Komprimierungsverhältnis erhöht wird.
Die Anforderungen an die Klangqualität von Audiomaterial können variieren und hängen von bestimmten Zwecken und Anwendungsbereichen ab.
Eine verlustbehaftete Codierung wird daher als “verlustbehaftet” bezeichnet, was zum Verlust einiger Audioinformationen führt. Eine solche Codierung führt dazu, dass das decodierte Signal bei seiner Wiedergabe ähnlich wie das Original klingt, in Wirklichkeit jedoch nicht mehr mit diesem identisch ist. Die meisten verlustbehafteten Codierungsmethoden beruhen auf der Verwendung der psychoakustischen Eigenschaften des menschlichen Hörsystems sowie auf verschiedenen Tricks, die mit dem Resampling und Resampling des Signals verbunden sind. In der Frequenz analysiert der Encoder während des Komprimierungsprozesses die Audiodaten, um verschiedene Details des Sounds zu identifizieren, die ignoriert werden können. Verdeckte Frequenzen, unhörbare und unhörbare Klangdetails können für ein höheres Kompressionsverhältnis geopfert werden. Wenn Verständlichkeit nur für den Ton wichtig ist (z. B. in der Telefonie, wo das Vorhandensein von Frequenzen über 4 kHz nicht erforderlich ist), werden die Audioinformationen während des Codierungsprozesses ernsthaft “vereinfacht”, was zusammen mit der Verwendung von ” intelligente “Quantifizierer” und “gierige” Datenkomprimierungsalgorithmen.

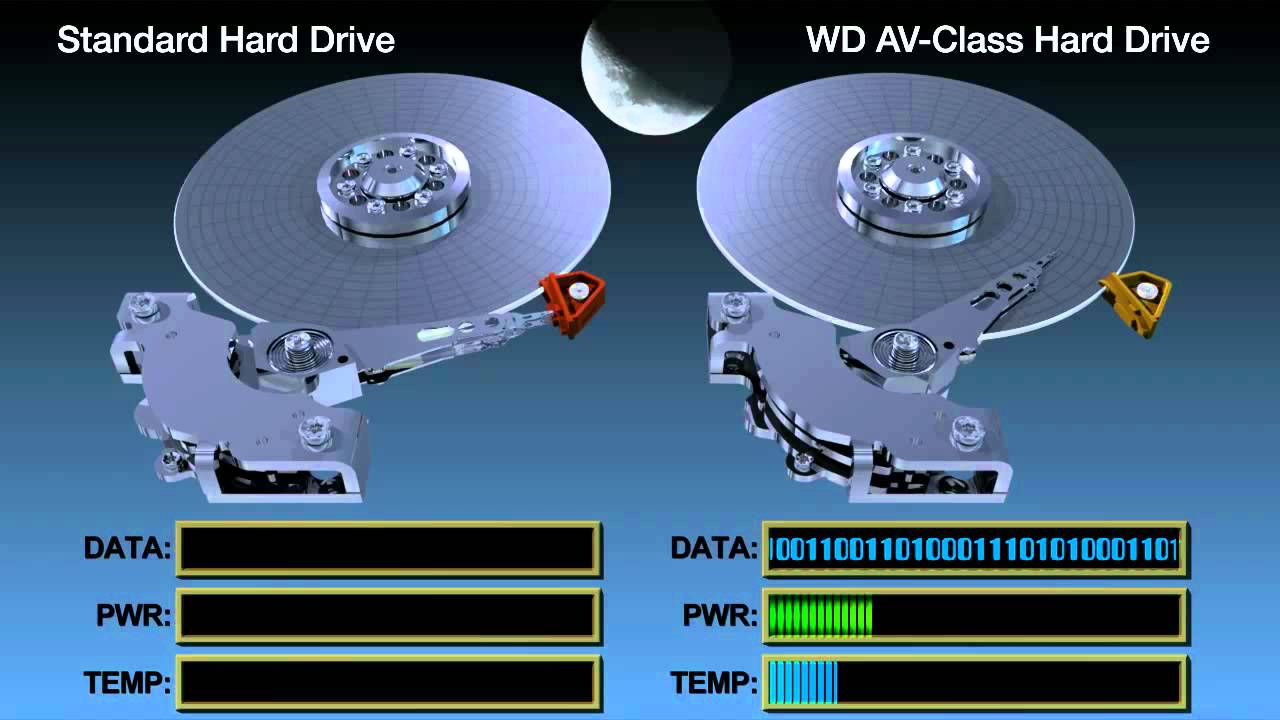
Warum werden AV-Festplatten für digitale Aufnahmen verwendet?

Warum werden AV-Festplatten für digitale Aufnahmen verwendet?

AV Hard drives


AV HARD DRIVE

Die Klasse der AV-Festplatten (Audio / Video) bedeutet ihre Fähigkeit dazu
Lesen und Schreiben von Datenströmen effizient und reibungslos ohne Pausen. Reserve Army-
Einige Festplatten werden mit einem größeren internen Puffer geliefert und sind nicht unterbrochen
Sie lesen / schreiben das Prozess-Wärmekalibrierungs-Positionierungssystem.
Für digitale Aufzeichnungssysteme mit unzureichender Leistung und
Mengen an RAM, um mögliche Unregelmäßigkeiten im Betrieb des zu glätten
Discs, AV-Discs sind die einzig mögliche Ausgabe.

Beachten Sie, dass die Abkürzung AV in der Bezeichnung der Disc vorhanden ist
es bedeutet nicht, dass es zur Audio / Video-Klasse gehört; muss sein
Es muss ausdrücklich im Pass der CD erwähnt werden.

Die angegebene Funktion ist jedoch in der Regel nur beim Arbeiten erforderlich
Bot mit hochwertigen Videoinformationen, deren Geschwindigkeit
Es sind ungefähr 10 Megabyte pro Sekunde pro Kanal. Im Falle von Ton
Systeme geben die Rate eines einzelnen 16-Bit-Kanalstroms mit einer Frequenz aus
Die Abtastrate von 48 kHz ist zwei Größenordnungen niedriger und beträgt nur 94 Kilogramm.
Bytes pro Sekunde. Zur gleichen Zeit fast keine Workstation
um den gleichzeitigen Betrieb mit Hunderten von Kanälen zu gewährleisten, sowie
Die Festplatte kann nicht so viele Daten parallel verarbeiten.
befindet sich in verschiedenen Teilen davon. In realen Anwendungen Mehrkanal
Brennen von Disc zu Disc, der größte Teil der Gesamtkosten der Disc
Das heulende Subsystem beruht auf Kopfbewegungen zwischen Aufnahmebereichen.
und nichts in der Datenübertragung selbst. Die niedrige Schallgeschwindigkeit fließt.
kov macht es bequemer und zuverlässiger, sie im RAM des Computers zu speichern.
Kompensation der thermischen Kalibrierung der Scheibe innerhalb von 0,5 – 1 s statt
Verwendung teurer und seltener Discs der AV-Klasse. Auch ist es weit davon entfernt
Bei allen herkömmlichen Scheiben hat die thermische Kalibrierung einen bemerkenswerten Effekt auf die
Datenstromnummer.

“Gebrochene” Datenübertragung kann auch bei Verwendung von “unbeabsichtigt” auftreten.
korrektes “Betriebssystem (DOS, Windows ohne 32-Bit-Treiber
Vertrauen auf die Festplatte usw.), unzureichende Anzahl und Größe der Dateipuffer
das Betriebssystem und das Brennprogramm loszuwerden, die Verwendung von Low-Class-Discs mit
Übertragungsrate in der Größenordnung von 1-2 Megabyte pro Sekunde und niedriger, falsch
Schließen Sie eine Disc usw. an. In jedem Fall sind diese Situationen normalerweise
Sprechen Sie über Fehlkonfigurationen und Hardware- und Softwarekonfigurationen
Teile des Systems.

Mit welchen Methoden wird digitales Audio effektiv komprimiert?

Mit welchen Methoden wird digitales Audio effektiv komprimiert?

Compress Digital Audio

COMPRESS DIGITAL AUDIO

Derzeit sind Audio MPEG, PASC und ATRAC die bekanntesten. Alle von ihnen
Verwenden Sie die sogenannte “Wahrnehmung”
Codierung), bei der Informationen aus dem Tonsignal entfernt werden,
für das Ohr wahrnehmbar. Infolgedessen trotz der Änderung in Form und Spektrum
Signal, Ihre Hörwahrnehmung ist praktisch unverändert, und der Grad
Die Kompression führt zu einer leichten Qualitätsminderung. Eine solche Codierung
bezieht sich auf verlustbehaftete Komprimierungsmethoden, wenn
Es ist nicht mehr möglich, die ursprüngliche Wellenform aus dem komprimierten Signal genau zu rekonstruieren
gestalten.

Die Techniken zum Eliminieren eines Teils der Informationen basieren auf den Eigenschaften des Menschen.
wem man zuhört, Maskierung genannt: wenn es ein Hoch gibt
starke Spitzen (dominante Harmonische) schwächerer Frequenzgehalt
hören in unmittelbarer nähe von ihnen praktisch nein
akzeptiert (maskiert). Beim Codieren wird der gesamte Audiostream aufgeteilt
ist in kleine Quadrate unterteilt, von denen jedes ein Spektral wird
Präsentation und ist in mehrere Frequenzbänder unterteilt. Innerhalb der Streifen gibt es
führt die Definition und Entfernung von maskierten Sounds durch, nach denen jeder Frame
es wird direkt in spektraler Form adaptiv codiert. Alle
Diese Vorgänge können das Volumen (mehrmals) erheblich reduzieren
Daten unter Beibehaltung einer für die meisten Hörer akzeptablen Qualität
Ich lese.

Jedes der beschriebenen Codierungsverfahren ist durch eine Bitrate gekennzeichnet
die Bitrate, mit der die komprimierten Informationen kommen sollen
auf der Kabelbox, wenn das Audiosignal wiederhergestellt ist. Decoder konvertiert
eine Reihe von Momentansignalspektren, die zu einer herkömmlichen digitalen Wellenform komprimiert sind
gestalten.

MPEG Audio – Eine Gruppe von MPEG-standardisierten Audiokomprimierungsmethoden
(Moving Pictures Experts Group – eine Expertengruppe zur Verarbeitung von Bewegungen
Bilder). MPEG-Audiomethoden gibt es in verschiedenen
Typen – MPEG-1, MPEG-2 usw.; derzeit am häufigsten
kein MPEG-1-Typ.

Es gibt drei MPEG-1-Audioebenen für die Stereokomprimierung.
Ihre Signale:

Komprimierungsverhältnis 1 – 1: 4 mit einem Datenstrom von 384 kbps;
2-1: 6..1: 8 bei 256..192 kbps;
3 – 1: 10..1: 12 bei 128..112 kbps.

Die minimale Datenrate in jeder Schicht ist als 32 definiert
kbps; Die angegebenen Bitraten behalten die Signalqualität bei
ungefähr auf dem Niveau einer CD.

Alle drei Ebenen verwenden die Eingangs-Split-Spektraltransformation
Ändern des Rahmens in 32 Frequenzbändern. Das Optimalste in Bezug
Datenlautstärke und Klangqualität werden als Stufe 3 mit Bitrate erkannt
128 kbps und eine Datendichte von ungefähr 1 Mb / min. Wenn von unten zusammengedrückt
bei welchen Geschwindigkeiten beginnt die erzwungene Begrenzung des Frequenzbandes
15-16 kHz und Kanalphasenverzerrungen treten ebenfalls auf (Effekte wie z
Phaser oder Flanger).

MPEG-Audio wird in Computer-Soundsystemen, CD-i / DVD, verwendet.
CD-ROM “Audio”, digitales Radio / Fernsehen und andere Systeme
massive Schallübertragung.

PASC (Precision Adaptive Subband Coding – Präzises adaptives Intraband
Codierung) – ein Sonderfall von Audio MPEG-1 Layer 1 mit einer Geschwindigkeit
Stream 384 kbps (1: 4-Komprimierung). Wird im DCC-System verwendet.

ATRAC (Adaptive TRansform Acoustic Coding – Akustische Codierung
adaptive Transformation) basiert auf stereophonem Klang
Quantisiertes 16-Bit-Format mit einer Abtastrate von 44,1 kHz.
Beim Komprimieren wird jeder Frame in 52 Frequenzbänder unterteilt, was zu
Übertragungsgeschwindigkeit: 292 kbps (1: 5-Komprimierung). Im System angewendet