Was ist Bitrate?


Free Download Mp4Gain
picture

Was ist Bitrate?

Bitrate

Bitrate

Bitrate

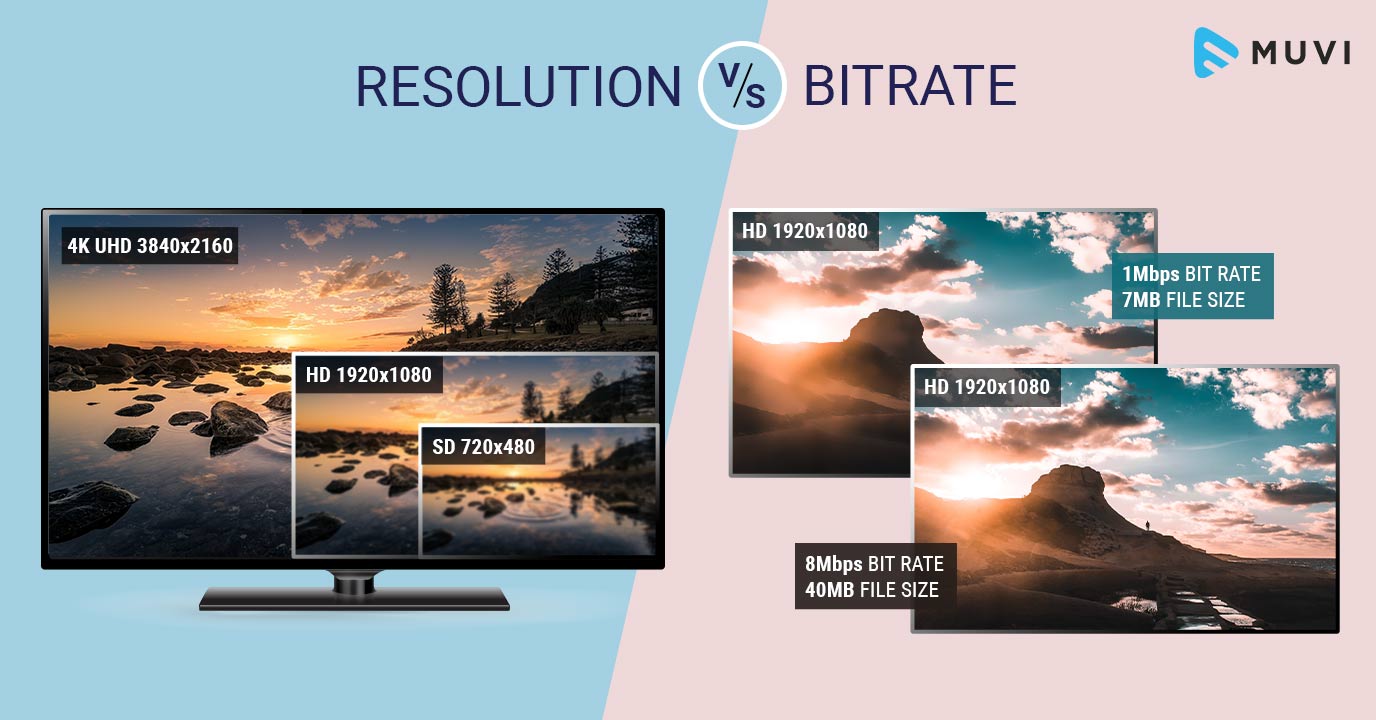
Bitrate: Die Anzahl der Informationsbits, die zum Speichern oder Übertragen einer Sekunde der Datenübertragung verwendet werden: Video- und / oder Audioaufzeichnungen, einschließlich komprimierter.

Die Bitrate wird in Bit pro Sekunde (Bit / s, bps) sowie in abgeleiteten Werten ausgedrückt: Kilo (kbps, kbps), Mega (Mbps, Mbps) usw.

Bei Streaming-Video- und Audioformaten (wie MPEG und MP3), die eine verlustbehaftete Komprimierung verwenden]] drückt die Bitrate den Grad der Komprimierung des Streams aus. Meistens wird die Video- und Audio-Bitrate in Megabit pro Sekunde gemessen.

Durch Erhöhen der Bitrate wird die Videoaufnahmequalität erheblich verbessert, was sich insbesondere bei der Aufnahme dynamischer Szenen und kleiner Details bemerkbar macht.

Codierungsmodi
Es gibt drei Komprimierungsmodi für die Datenübertragung:

CBR (konstante Bitrate): mit konstanter Bitrate;
VBR (variable Bitrate): mit variabler Bitrate;
ABR (Average Bit Rate): mit einer durchschnittlichen Bitrate.

Konstante Bit-Rate
Konstante Bitrate, CBR – Eine Variante der Streaming-Datencodierung, bei der zunächst die erforderliche Bitrate eingestellt wird, die sich in der gesamten Datei nicht ändert.

Der Hauptvorteil ist die Möglichkeit, die Größe der endgültigen Datei ziemlich genau vorherzusagen.

Die Option mit konstanter Bitrate ist jedoch nicht sehr gut für Video- oder Audioinhalte geeignet, deren Dynamik sich im Laufe der Zeit ändert, da sie kein optimales Verhältnis von Größe zu Qualität bietet.

Variable Bitrate
Bei einer variablen Bitrate wählt der VBR-Codec den Wert der Bitrate basierend auf den Parametern (dem Niveau der gewünschten Qualität) aus, und während des codierten Segments kann sich die Bitrate ändern.

Diese Methode bietet das beste Qualitäts- / Größenverhältnis für die Ausgabedatei, ihre genaue Größe ist jedoch sehr unvorhersehbar. Abhängig von der Art des Tons (oder des Bildes bei der Videokodierung) kann sich die Größe der resultierenden Datei mehrmals unterscheiden.

Durchschnittliche Bitrate
Die durchschnittliche Bitrate ABR ist eine Mischung aus konstanten und variablen Bitraten: Der Wert in Mbit / s wird vom Benutzer festgelegt und vom Programm innerhalb bestimmter Grenzen variiert. Im Gegensatz zu VBR achtet der Codec jedoch darauf, die maximal und minimal möglichen Werte zu verwenden, ohne das Risiko einzugehen, über den vom Benutzer angegebenen Durchschnitt hinauszugehen. Diese Methode ermöglicht die flexibelste Einstellung der Verarbeitungsgeschwindigkeit und eine viel höhere Genauigkeit (im Vergleich zu VBR) bei der Vorhersage der Größe der Ausgabedatei.

Free Download Mp4Gain
picture

Was ist digitales Audio?

Was ist digitales Audio?

Digital Audio

Digitaler Sound ist nichts anderes als eine Kombination von Zahlen.

DIGITAL AUDIO

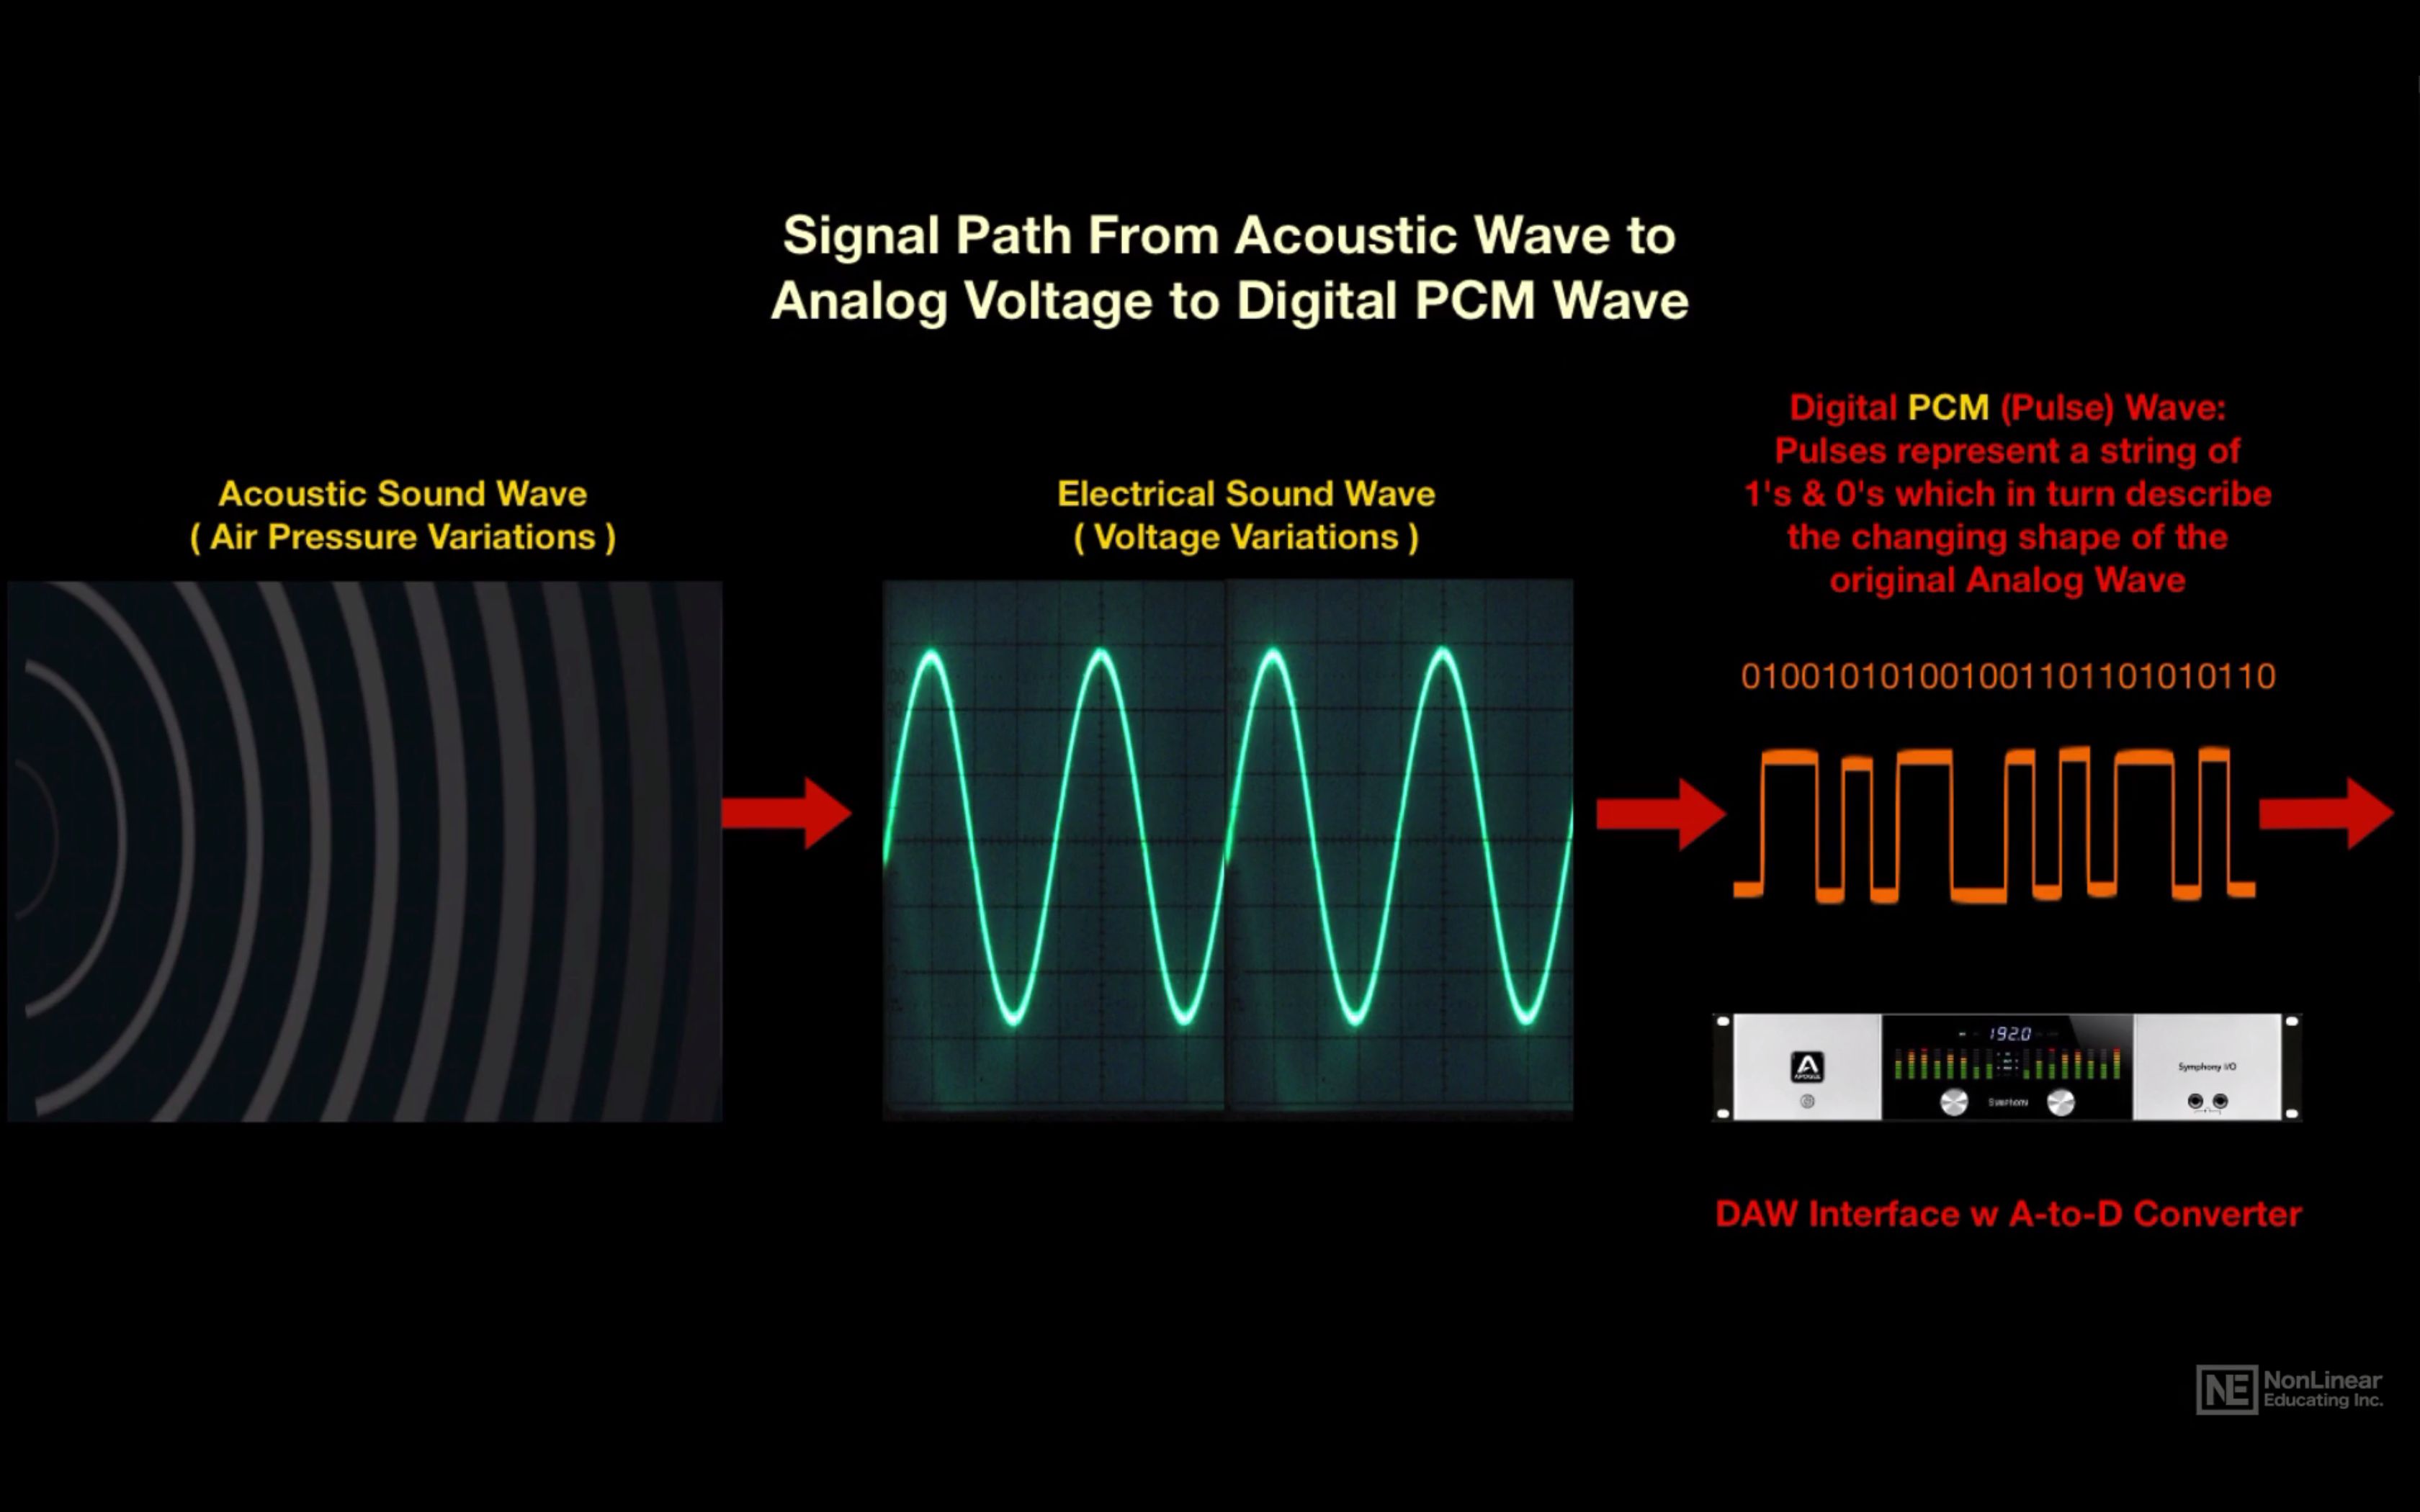
Mit einem bestimmten Algorithmus wird Ton wie Luftdruck in Datenströme umgewandelt und zur weiteren Verarbeitung und Wiedergabe codiert. Abhängig vom verwendeten Algorithmus hat die Musikdatei das eine oder andere Format, die eine oder andere Erweiterung.

Denken Sie daran, dass es neben digitalem Ton auch analogen Ton gibt, der durch ein kontinuierliches elektrisches Signal dargestellt wird, das die Änderung der Schallwelle widerspiegelt. Die Analog-Digital-Tonumwandlung ist eine Einstellung des numerischen Werts der Amplitude zu einem bestimmten Zeitpunkt mit einer bestimmten Wertedichte. Je mehr Werte aufgezeichnet werden, desto zuverlässiger und genauer wird das Bild des digitalisierten Klangfragments neu erstellt. Bei einer solchen Digitalisierung entstehen sehr umfangreiche Datenmatrizen, die sich je nach verwendetem Format im Verhältnis von Klangqualität zu Lautstärke der endgültigen Datei unterscheiden.

Möglicherweise ist der Hauptvorteil von digitalem Audio gegenüber analogem die Möglichkeit, Daten unbegrenzt zu speichern und zu kopieren, ohne die ursprüngliche Qualität zu verlieren (während beim Kopieren von einem analogen Medium auf ein anderes eine Abnahme der Aufnahmequalität deutlich zu spüren ist).

Das heute am weitesten verbreitete und beliebteste digitale Audioformat ist MP3 (MPEG Layer 3). Es wurde nach einer Reihe von Zwischenformaten und Untersuchungen entwickelt, die 1987 vom Fraunhofer-Institut in Deutschland gestartet wurden.

Die Entwickler des Formats standen vor der Aufgabe, die Kosten für den Versand langer Musikfragmente zu vereinfachen und zu senken. Wie Sie wissen, nimmt eine Minute eines Stereosignals von einer CD (16-Bit-, 44,1-kHz-Abtastrate) etwa zehn Megabyte Speicherplatz ein. Gleichzeitig kann das Audiosignal im Gegensatz zu Text- oder Grafikdateien nicht ohne Qualitätsverlust komprimiert werden. Daher dauert die Modemübertragung einer unkomprimierten Komposition von einer 3-minütigen Audio-CD mit einer Datenübertragungsrate von beispielsweise 24 kbps mehrere Stunden. Wissenschaftlern des Fraunhofer-Instituts gelang es, eine Komprimierung mehrerer Dateigrößen zu erreichen: Durchschnittlich dauert eine Minute eines komprimierten Audiosignals im MP3-Format etwa 1 Megabyte. Das Prinzip der Komprimierung basiert auf der Eliminierung “unnötiger” Geräusche aus der Musikdatei, gegen die das menschliche Ohr immun ist oder die sich gegenseitig duplizieren.

Der Hauptfaktor, der die Beziehung zwischen Dateigröße und Klangqualität innerhalb eines bestimmten Formats bestimmt, ist die Bitrate. Die Bitrate ist ein Indikator dafür, wie viele Informationen eine Sekunde Sound codiert. Je höher es ist, desto weniger Verzerrungen und desto näher ist die codierte Komposition am Original. Die im Internet am häufigsten verwendeten Kompositionen mit Bitraten von 128 und 192 Kbit / s. Die maximale Bitrate, die von Programmen und Geräten unterstützt wird, die mit MP3 arbeiten, beträgt 320 Kbit / s. In der Praxis kann nur ein Experte oder ein Fachmann, der mit Ton arbeitet, die Unterschiede zwischen a und 1 feststellen MP3-Datei mit einer Bitrate von 320.

Um die Größe von MP3-Musikdateien bei gleichbleibender Qualität zu optimieren, wird eine variable Bitrate (Abkürzung VBR – Variable Bitrate) verwendet. In diesem Fall unterteilt das Codierungsprogramm die Datei in Fragmente unterschiedlicher spektraler Sättigung und codiert sie mit einer geeigneten Bitrate. Die meisten modernen MP3-Player unterstützen die Wiedergabe mit variabler Bitrate. Ein wesentlicher Vorteil von MP3-Dateien besteht darin, dass sie den Namen des Künstlers, den Namen des Titels und des Albums, das Jahr seiner Veröffentlichung usw. enthalten können. Der Satz dieser Daten wird als ID3-Tags bezeichnet. Die meisten modernen Spieler können sie lesen und auf dem Bildschirm anzeigen.

Im Jahr 2001 entwickelten Swedish Coding Technologies und Thomson Multimedia den MP3 Pro-Codec. Es ist MP3-basiert und daher vollständig MP3-abwärtskompatibel und nur teilweise vorwärtskompatibel. Es verwendet die SBR-Technologie (Spectral Band Replication), sodass der Codec bei niedrigen Bitraten eine gute Qualität bietet. Die Codierungsqualität bei mittleren bis hohen Bitraten ist jedoch schlechter als die der meisten anderen Codecs. Aus diesem Grund wird dieses Format hauptsächlich für Sendungen im Internet und Demonstrationen von Fragmenten neuer Musikkompositionen verwendet.

Eine andere Art von MP3 war die Entwicklung von MP3 Surround, die kürzlich von den Machern von MP3 eingeführt wurde: dem Fraunhofer-Institut. Dieses Format wiederholt alle Eigenschaften von Mehrkanalton und ist dennoch mit Standard-Stereo-MP3 kompatibel: Informationen, die die räumlichen Eigenschaften des Tons beschreiben, werden auf einer zusätzlichen Spur aufgezeichnet. Durch Abspielen von Dateien dieses Formats auf speziellen Geräten, die diese Spur lesen können, erhalten Sie Surround-Sound, der dem Surround 5.1-Standard entspricht.

Digitale Audiokodierung

Digitale Audiokodierung

Digital audio encoding

Tatsächlich ist die eine oder andere digitale Form der Darstellung von analogen Audiosignalen bereits eine Codierungsmethode – eine Folge von Zahlen, die ein analoges Audiosignal beschreibt, ist selbst ein digitaler Code.

Digital Audio Encoding

Die Kodierung, über die wir jetzt sprechen werden, ist jedoch etwas anderes. Schauen wir uns nun die Methoden zum Codieren digitaler Audiosignale an.

Ein digitalisiertes Audiosignal “in seiner reinen Form” ist eine ziemlich genaue, aber nicht die kompakteste Art, das ursprüngliche analoge Signal aufzuzeichnen.

Urteile selbst. Um vollständige Informationen über das ursprüngliche analoge Signal im Frequenzbereich 0-20 kHz (im hörbaren Frequenzbereich) zu erhalten, muss das analoge Signal mit einer Frequenz von mindestens 40 kHz abgetastet werden. Daher legt der CD-DA-Standard (der Standard zum Aufzeichnen von Daten auf Audio-CDs, die allen bekannt sind) die folgenden Codierungsparameter fest: Aufzeichnen von zwei oder einem Kanal im PCM-Format mit einer Abtastfrequenz von 44,1 kHz und einer 16-Bit-Quantisierungsbittiefe . Eine Stunde Musik in diesem Format nimmt ungefähr 600 MB Speicherplatz ein (60 Minuten * 60 Sekunden * 2 Kanäle * 44100 Samples pro Sekunde * 2 Bytes pro Sample = ungefähr 605 MB). Wenn man berücksichtigt, dass beispielsweise die Musiksammlung eines gewöhnlichen Musikliebhabers 5.000 Titel mit einer durchschnittlichen Länge von jeweils etwa 3 Minuten enthält, ist der Speicherbedarf, der erforderlich ist, um sie in ihrer ursprünglichen digitalen Form zu speichern, ziemlich bedeutend. Daher erfordert das Speichern relativ großer Mengen von Audiodaten, um eine ziemlich gute Klangqualität sicherzustellen, die Verwendung verschiedener “Tricks”, um die Daten zu komprimieren.

Im Allgemeinen können alle vorhandenen Methoden zum Codieren von Audioinformationen bedingt in nur zwei Typen unterteilt werden.

1. Die verlustfreie Datenkomprimierung (“verlustfreie Codierung”) ist eine Methode zum Codieren (Komprimieren) digitaler Audioinformationen, die eine hundertprozentige Wiederherstellung der Originaldaten aus der komprimierten Übertragung ermöglicht (der Begriff “Originaldaten” bedeutet hier die ursprüngliche Form von die digitalisierten Audiodaten). Diese Methode der Datenkomprimierung wird in Fällen verwendet, in denen eine hundertprozentige absolute Erhaltung der Qualität der ursprünglichen Audiodaten erforderlich ist. Die heute existierenden verlustfreien Komprimierungsalgorithmen können das Datenvolumen um 20-50% reduzieren und gleichzeitig eine 100% ige Wiederherstellung des ursprünglichen digitalen Materials aus den komprimierten Daten gewährleisten. Die Betriebsmechanismen solcher Codierer ähneln den Betriebsmechanismen allgemeiner Datenarchivierer wie ZIP oder RAR, sind jedoch gleichzeitig speziell für die Komprimierung von Audiodaten angepasst. Verlustfreie Codierung Obwohl sie im Hinblick auf die Aufbewahrung ideal ist Aufgrund der Qualität der Audiomaterialien kann kein hohes Maß an Komprimierung erzielt werden.

2. Es gibt eine andere modernere Möglichkeit, Daten zu komprimieren. Diese sogenannte verlustbehaftete Datenkomprimierung (engl. “Lossy Coding”) Der Zweck der Codierung besteht darin, mit allen Mitteln die höchste Datenkomprimierungsrate zu erzielen und gleichzeitig die Klangqualität auf einem akzeptablen Niveau zu halten. Die Idee hinter verlustbehafteter Codierung basiert auf zwei einfachen Überlegungen:

Die ursprünglichen digitalen Audiodaten sind redundant: Sie enthalten viele unnötige Informationen, die für das Ohr unbrauchbar sind und entfernt werden können, wodurch das Komprimierungsverhältnis erhöht wird.
Die Anforderungen an die Klangqualität von Audiomaterial können variieren und hängen von bestimmten Zwecken und Anwendungsbereichen ab.
Eine verlustbehaftete Codierung wird daher als “verlustbehaftet” bezeichnet, was zum Verlust einiger Audioinformationen führt. Eine solche Codierung führt dazu, dass das decodierte Signal bei seiner Wiedergabe ähnlich wie das Original klingt, in Wirklichkeit jedoch nicht mehr mit diesem identisch ist. Die meisten verlustbehafteten Codierungsmethoden beruhen auf der Verwendung der psychoakustischen Eigenschaften des menschlichen Hörsystems sowie auf verschiedenen Tricks, die mit dem Resampling und Resampling des Signals verbunden sind. In der Frequenz analysiert der Encoder während des Komprimierungsprozesses die Audiodaten, um verschiedene Details des Sounds zu identifizieren, die ignoriert werden können. Verdeckte Frequenzen, unhörbare und unhörbare Klangdetails können für ein höheres Kompressionsverhältnis geopfert werden. Wenn Verständlichkeit nur für den Ton wichtig ist (z. B. in der Telefonie, wo das Vorhandensein von Frequenzen über 4 kHz nicht erforderlich ist), werden die Audioinformationen während des Codierungsprozesses ernsthaft “vereinfacht”, was zusammen mit der Verwendung von ” intelligente “Quantifizierer” und “gierige” Datenkomprimierungsalgorithmen.

Wie Ton codiert wird

Wie Ton codiert wird

How sound is encoded

Schall ist eine Welle, die sich häufiger in Luft, Wasser oder einem anderen Medium mit einer sich ständig ändernden Intensität und Frequenz ausbreitet.

How sound is encoded

Eine Person kann Schallwellen (Luftschwingungen) mit Hilfe des Hörens in Form von Schall wahrnehmen und dabei zwischen Lautstärke und Tonhöhe unterscheiden.

Je höher die Intensität der Schallwelle ist, desto lauter der Schall, desto höher die Frequenz der Welle, desto höher die Tonhöhe.

Wir haben zuvor ausführlicher über die menschliche Wahrnehmung von Geräuschen geschrieben. Sie können sie hier lesen.

Wie Audio codiert wird (digitale Codierung und Audioverarbeitung)
Abhängigkeit der Lautstärke sowie des Tons von der Intensität und Frequenz der Schallwelle.

Hertz (bezeichnet mit Hz oder Hz) ist eine Maßeinheit für die Frequenz periodischer Prozesse (z. B. Schwingungen).
1 Hz bedeutet eine Ausführung des Prozesses in einer Sekunde: 1 Hz = 1 / s.

Wenn wir 10 Hz haben, bedeutet dies, dass wir zehn Ausführungen dieses Prozesses in einer Sekunde haben.

Das menschliche Ohr kann Schall mit Frequenzen von 20 Schwingungen pro Sekunde (20 Hertz, leiser Schall) bis 20.000 Schwingungen pro Sekunde (20 KHz, hoher Schall) wahrnehmen.

Darüber hinaus kann eine Person Schall in einem weiten Bereich von Intensitäten wahrnehmen, bei denen die maximale Intensität 1014-mal höher ist als die minimale (einhunderttausend Milliarden Mal).

Zur Messung der Schalllautstärke wurde eine spezielle Einheit von “Dezibel” (dB) erfunden und verwendet.

Eine Abnahme oder Zunahme der Schalllautstärke um 10 dB entspricht einer 10-fachen Abnahme oder Zunahme der Schallintensität.

Charakteristischer Klang Lautstärke gemessen in Dezibel
Untergrenze der Empfindlichkeit des menschlichen Ohrs 0
Blatt flüstert zehn
Gespräch 60
Horn 90
Düsentriebwerk 120
Schmerzschwelle 140

Lautstärke in Dezibel

Audio-Sampling synchronisieren

Damit Computersysteme Ton verarbeiten können, muss ein kontinuierliches Audiosignal durch Zeitabtastung in eine diskrete digitale Form umgewandelt werden.

Dazu wird eine kontinuierliche Schallwelle in separate kleine Zeitabschnitte unterteilt, für jeden Abschnitt wird ein bestimmter Wert der Schallintensität eingestellt.

Daher wird die kontinuierliche Abhängigkeit der Lautstärke des Schalls zum Zeitpunkt A (t) durch eine diskrete Folge von Lautstärkepegeln ersetzt. In der Grafik scheint dies eine glatte Kurve durch eine Folge von “Schritten” zu ersetzen.

Wie Audio codiert wird (digitale Codierung und Audioverarbeitung)
Audio-Sampling synchronisieren

Ein an die Soundkarte angeschlossenes Mikrofon wird verwendet, um analoges Audio aufzunehmen und in ein digitales Format umzuwandeln.

Je dichter die einzelnen Streifen auf der Grafik sind, desto besser ist es, den Originalton endgültig wiederherzustellen.

Die resultierende digitale Klangqualität hängt von der Anzahl der Schallpegelmessungen pro Zeiteinheit ab, dh von der Abtastfrequenz.

Die Audio-Abtastrate ist die Anzahl der Audio-Lautstärkemessungen in einer Sekunde.

Je mehr Messungen in einer Sekunde durchgeführt werden (je höher die Abtastfrequenz), desto genauer wiederholt die “Leiter” des digitalen Audiosignals die Kurve des analogen Signals.

Jedem “Schritt” des Diagramms wird ein bestimmter Wert für die Lautstärke zugewiesen. Lautheitspegel können als eine Reihe möglicher N-Zustände (Abstufungen) betrachtet werden, für deren Codierung eine bestimmte Menge an I-Informationen erforderlich ist, die als Audiocodierungstiefe bezeichnet wird.

Die Audiocodierungstiefe ist die Informationsmenge, die zum Codieren der diskreten Lautstärkepegel von digitalem Audio erforderlich ist.

Bei bekannter Codierungstiefe kann die Anzahl der digitalen Audio-Lautstärkepegel nach der allgemeinen Formel N = 2 I berechnet werden.

Die Audiocodierungstiefe beträgt beispielsweise 16 Bit. In diesem Fall beträgt die Anzahl der Lautstärkepegel:

N = 2I = 2 16 = 65 536.

Während des Codierungsprozesses wird jedem Schallpegel ein eigener 16-Bit-Binärcode zugewiesen, der kleinste Schallpegel entspricht dem Code 0000000000000000 und der höchste – 1111111111111111.

Digitalisierte Audioqualität

Je höher die Abtastrate und die Tiefe der Audiokodierung sind, desto besser klingt der digitalisierte Ton und desto besser können Sie den digitalisierten Ton näher an den Originalton bringen.

Die niedrigste Qualität des digitalisierten Tons, die der Qualität der Telefonkommunikation entspricht, wird mit einer Abtastrate von 8000 Mal pro Sekunde, einer Abtastrate von 8 Bit und durch Aufzeichnen einer Audiospur (“Mono” -Modus) erhalten.
Es sollte jedoch beachtet werden, dass zur Verbesserung dieses Klangs in der Telefonie Geräte verwendet werden, die Sprachsynthesizern und Sprachcodierern ähneln. Über Sprachcodierer auch dieser Artikel