Warum werden AV-Festplatten für digitale Aufnahmen verwendet?


Free Download Mp4Gain
picture

Warum werden AV-Festplatten für digitale Aufnahmen verwendet?
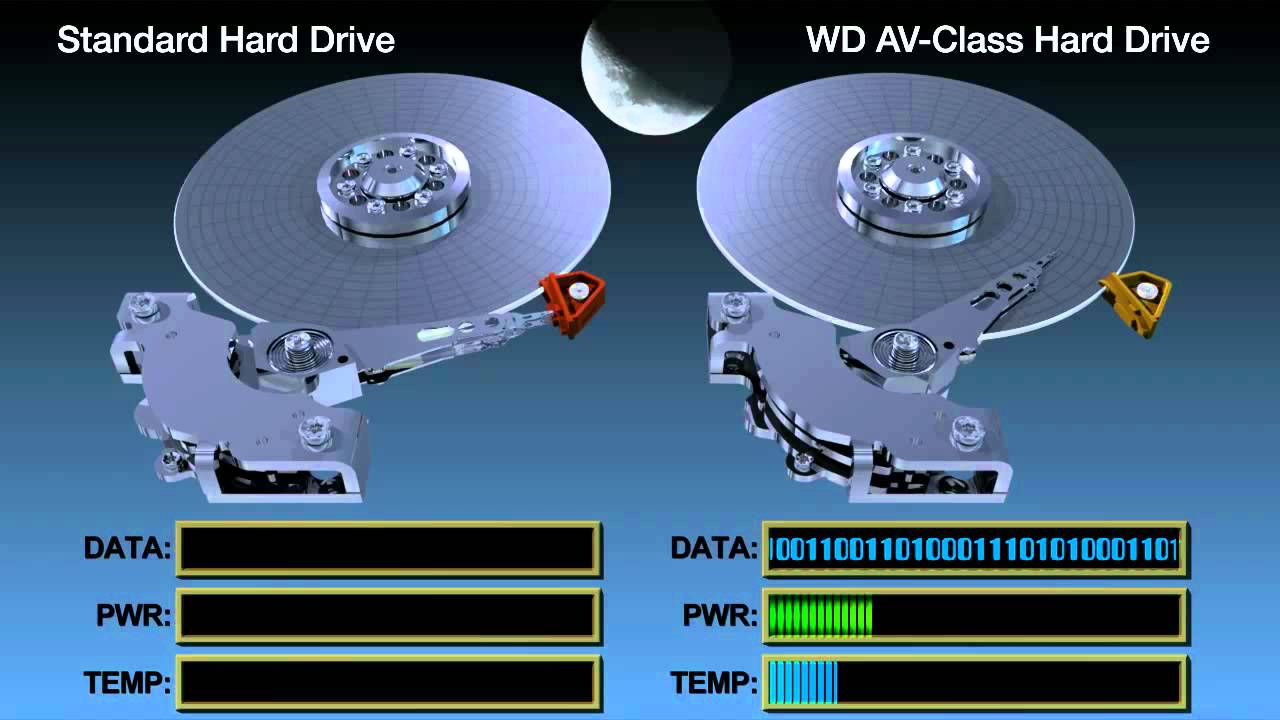
AV Hard drives


AV HARD DRIVE

Die Klasse der AV-Festplatten (Audio / Video) bedeutet ihre Fähigkeit dazu
Lesen und Schreiben von Datenströmen effizient und reibungslos ohne Pausen. Reserve Army-
Einige Festplatten werden mit einem größeren internen Puffer geliefert und sind nicht unterbrochen
Sie lesen / schreiben das Prozess-Wärmekalibrierungs-Positionierungssystem.
Für digitale Aufzeichnungssysteme mit unzureichender Leistung und
Mengen an RAM, um mögliche Unregelmäßigkeiten im Betrieb des zu glätten
Discs, AV-Discs sind die einzig mögliche Ausgabe.

Beachten Sie, dass die Abkürzung AV in der Bezeichnung der Disc vorhanden ist
es bedeutet nicht, dass es zur Audio / Video-Klasse gehört; muss sein
Es muss ausdrücklich im Pass der CD erwähnt werden.

Die angegebene Funktion ist jedoch in der Regel nur beim Arbeiten erforderlich
Bot mit hochwertigen Videoinformationen, deren Geschwindigkeit
Es sind ungefähr 10 Megabyte pro Sekunde pro Kanal. Im Falle von Ton
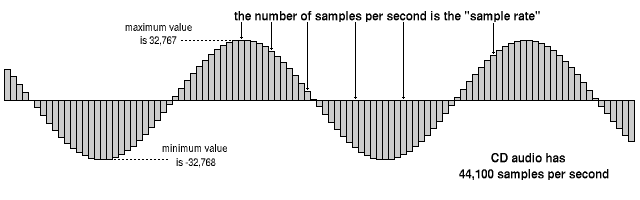
Systeme geben die Rate eines einzelnen 16-Bit-Kanalstroms mit einer Frequenz aus
Die Abtastrate von 48 kHz ist zwei Größenordnungen niedriger und beträgt nur 94 Kilogramm.
Bytes pro Sekunde. Zur gleichen Zeit fast keine Workstation
um den gleichzeitigen Betrieb mit Hunderten von Kanälen zu gewährleisten, sowie
Die Festplatte kann nicht so viele Daten parallel verarbeiten.
befindet sich in verschiedenen Teilen davon. In realen Anwendungen Mehrkanal
Brennen von Disc zu Disc, der größte Teil der Gesamtkosten der Disc
Das heulende Subsystem beruht auf Kopfbewegungen zwischen Aufnahmebereichen.
und nichts in der Datenübertragung selbst. Die niedrige Schallgeschwindigkeit fließt.
kov macht es bequemer und zuverlässiger, sie im RAM des Computers zu speichern.
Kompensation der thermischen Kalibrierung der Scheibe innerhalb von 0,5 – 1 s statt
Verwendung teurer und seltener Discs der AV-Klasse. Auch ist es weit davon entfernt
Bei allen herkömmlichen Scheiben hat die thermische Kalibrierung einen bemerkenswerten Effekt auf die
Datenstromnummer.

“Gebrochene” Datenübertragung kann auch bei Verwendung von “unbeabsichtigt” auftreten.
korrektes “Betriebssystem (DOS, Windows ohne 32-Bit-Treiber
Vertrauen auf die Festplatte usw.), unzureichende Anzahl und Größe der Dateipuffer
das Betriebssystem und das Brennprogramm loszuwerden, die Verwendung von Low-Class-Discs mit
Übertragungsrate in der Größenordnung von 1-2 Megabyte pro Sekunde und niedriger, falsch
Schließen Sie eine Disc usw. an. In jedem Fall sind diese Situationen normalerweise
Sprechen Sie über Fehlkonfigurationen und Hardware- und Softwarekonfigurationen
Teile des Systems.

Free Download Mp4Gain
picture

Mit welchen Methoden wird digitales Audio effektiv komprimiert?

Mit welchen Methoden wird digitales Audio effektiv komprimiert?

Compress Digital Audio

COMPRESS DIGITAL AUDIO

Derzeit sind Audio MPEG, PASC und ATRAC die bekanntesten. Alle von ihnen
Verwenden Sie die sogenannte “Wahrnehmung”
Codierung), bei der Informationen aus dem Tonsignal entfernt werden,
für das Ohr wahrnehmbar. Infolgedessen trotz der Änderung in Form und Spektrum
Signal, Ihre Hörwahrnehmung ist praktisch unverändert, und der Grad
Die Kompression führt zu einer leichten Qualitätsminderung. Eine solche Codierung
bezieht sich auf verlustbehaftete Komprimierungsmethoden, wenn
Es ist nicht mehr möglich, die ursprüngliche Wellenform aus dem komprimierten Signal genau zu rekonstruieren
gestalten.

Die Techniken zum Eliminieren eines Teils der Informationen basieren auf den Eigenschaften des Menschen.
wem man zuhört, Maskierung genannt: wenn es ein Hoch gibt
starke Spitzen (dominante Harmonische) schwächerer Frequenzgehalt
hören in unmittelbarer nähe von ihnen praktisch nein
akzeptiert (maskiert). Beim Codieren wird der gesamte Audiostream aufgeteilt
ist in kleine Quadrate unterteilt, von denen jedes ein Spektral wird
Präsentation und ist in mehrere Frequenzbänder unterteilt. Innerhalb der Streifen gibt es
führt die Definition und Entfernung von maskierten Sounds durch, nach denen jeder Frame
es wird direkt in spektraler Form adaptiv codiert. Alle
Diese Vorgänge können das Volumen (mehrmals) erheblich reduzieren
Daten unter Beibehaltung einer für die meisten Hörer akzeptablen Qualität
Ich lese.

Jedes der beschriebenen Codierungsverfahren ist durch eine Bitrate gekennzeichnet
die Bitrate, mit der die komprimierten Informationen kommen sollen
auf der Kabelbox, wenn das Audiosignal wiederhergestellt ist. Decoder konvertiert
eine Reihe von Momentansignalspektren, die zu einer herkömmlichen digitalen Wellenform komprimiert sind
gestalten.

MPEG Audio – Eine Gruppe von MPEG-standardisierten Audiokomprimierungsmethoden
(Moving Pictures Experts Group – eine Expertengruppe zur Verarbeitung von Bewegungen
Bilder). MPEG-Audiomethoden gibt es in verschiedenen
Typen – MPEG-1, MPEG-2 usw.; derzeit am häufigsten
kein MPEG-1-Typ.

Es gibt drei MPEG-1-Audioebenen für die Stereokomprimierung.
Ihre Signale:

Komprimierungsverhältnis 1 – 1: 4 mit einem Datenstrom von 384 kbps;
2-1: 6..1: 8 bei 256..192 kbps;
3 – 1: 10..1: 12 bei 128..112 kbps.

Die minimale Datenrate in jeder Schicht ist als 32 definiert
kbps; Die angegebenen Bitraten behalten die Signalqualität bei
ungefähr auf dem Niveau einer CD.

Alle drei Ebenen verwenden die Eingangs-Split-Spektraltransformation
Ändern des Rahmens in 32 Frequenzbändern. Das Optimalste in Bezug
Datenlautstärke und Klangqualität werden als Stufe 3 mit Bitrate erkannt
128 kbps und eine Datendichte von ungefähr 1 Mb / min. Wenn von unten zusammengedrückt
bei welchen Geschwindigkeiten beginnt die erzwungene Begrenzung des Frequenzbandes
15-16 kHz und Kanalphasenverzerrungen treten ebenfalls auf (Effekte wie z
Phaser oder Flanger).

MPEG-Audio wird in Computer-Soundsystemen, CD-i / DVD, verwendet.
CD-ROM “Audio”, digitales Radio / Fernsehen und andere Systeme
massive Schallübertragung.

PASC (Precision Adaptive Subband Coding – Präzises adaptives Intraband
Codierung) – ein Sonderfall von Audio MPEG-1 Layer 1 mit einer Geschwindigkeit
Stream 384 kbps (1: 4-Komprimierung). Wird im DCC-System verwendet.

ATRAC (Adaptive TRansform Acoustic Coding – Akustische Codierung
adaptive Transformation) basiert auf stereophonem Klang
Quantisiertes 16-Bit-Format mit einer Abtastrate von 44,1 kHz.
Beim Komprimieren wird jeder Frame in 52 Frequenzbänder unterteilt, was zu
Übertragungsgeschwindigkeit: 292 kbps (1: 5-Komprimierung). Im System angewendet

Welche Schnittstellen werden für die digitale Audioübertragung verwendet?

Welche Schnittstellen werden für die digitale Audioübertragung verwendet?

Digital Interfaces

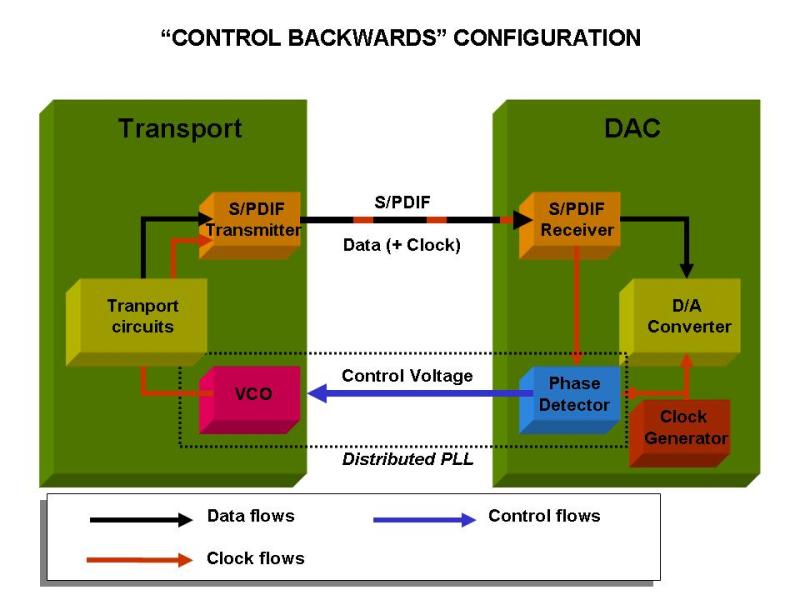
S / PDIF (Sony / Phillips Digital Interface Format – digitales Informationsformat
Schnittstelle von Sony und Philiрs) – digitale Schnittstelle für Heimradio
Mannschaft.

Digital Audio Interfaces

AES / EBU (Gesellschaft der Audioingenieure / Europäische Rundfunkunion – Gesellschaft
Toningenieure / European Broadcasting Association) – Digital Engineering
Schnittstelle für Studiofunkgeräte.

Beide Schnittstellen sind seriell und verwenden dieselbe Form
Markierungsmatte und Codiersystem: BMC-Code mit automatischer Synchronisation
(Zweiphasiger Markencode: Code mit einer doppelten Änderungsdarstellung einer Einheit
Phase) und kann Signale im PCM-Format von bis zu 24 Bit übertragen
bei Abtastraten bis zu 48 kHz.

Jeder Signalabtastwert wird als 32-Bit-Wort (Frame) übertragen, in dem
Rum 20 Ziffern werden verwendet, um die Zählung zu übertragen, und 12 – um sich zu bilden
Synchronisationspräambel, Übermittlung zusätzlicher Informationen und
Paritätsbit. Es können 4 Bits der Servicegruppe verwendet werden
Erweiterung des Sample-Formats auf 24 Bit.

192 aufeinanderfolgende Frames bilden einen Block, dessen Anfang markiert ist
spezieller Präambelcode des ersten Rahmens.

Zusätzlich zum Paritätsbit enthält der Serviceteil des Wortes ein Gültigkeitsbit
(Gültigkeit), die für jede gültige Antwort Null sein muss
Konten. Wenn ein Wort mit einem einzigen Bit Gültigkeit oder mit einer Verletzung empfangen wird
Parität im Wort interpretiert der Empfänger die gesamte Stichprobe als falsch und
Sie können ihn durch den alten Wert ersetzen oder interpolieren
basierend auf mehreren benachbarten gültigen Lesevorgängen. Zählt
als ungültig markiert kann CD-Player übertragen, die
DAT-Rekorder und andere Geräte, ja, wenn Sie Informationen von lesen
Das Medium konnte bei Lesefehlern nicht korrigiert werden
Ki.

Der Serviceteil des Wortes enthält auch die C-Bits (Kanalstatus – Status
Kanal) und U (Benutzerbit). Konstanter Preis
Niere jedes dieser Bits, einzeln aus jedem Blockrahmen entnommen,
bildet ein 192-Bit-Wort von Blockdienstbits, in denen Informationen übertragen werden
Informationen über den Titel der Arbeit, Titelnummer,
Gerät, CD-Subcodes usw. S / PDIF sendet
Kopierschutzeinstellungen (SCMS).

Das Standardcodierungsformat ist für die Übertragung von eins und zwei ausgelegt
Kanalsignal jedoch, wenn Servicebits verwendet werden
Durch Codieren der Kanalnummer kann ein Mehrkanalsignal übertragen werden.

Auf der elektrischen Seite bietet S / PDIF eine koaxiale Verbindung
Kabel mit charakteristischer Impedanz von 75 Ohm und Cinch-Steckern (“Tüll”
pan “), Signalamplitude – 0,5 V. AES / EBU stellt die Verbindung her
2-adriges abgeschirmtes symmetrisches Kabel mit Transformator
Entkopplung über RS-422-Schnittstelle mit Signalamplitude 3-10 V, Anschlüsse –
Kanone XLR 3-polig. Es gibt auch optische Optionen
Transceiver: TosLink (Kunststofffaser) und AT & T Link
(Glasfaser).

Missverständnisse über digitales Audio

Missverständnisse über digitales Audio

Digital Audio

Je höher die Bitrate, desto besser die Spur

Dies ist nicht immer der Fall. Lassen Sie mich zunächst daran erinnern, welche Bitrate t (Bitrate statt Bitterkeit). Tatsächlich ist dies die Datenrate in Kilobit pro Sekunde während der Wiedergabe. Das heißt, wenn wir die Größe der Spur in Kilobit nehmen und durch ihre Dauer in Sekunden dividieren, erhalten wir ihre Bitrate, den Aufruf. Dateibasierte Bitrate (FBR), die sich normalerweise nicht zu stark von der Bitrate des Audiostreams unterscheidet (der Grund für die Unterschiede ist das Vorhandensein von Metadaten auf der Spur: Tags, “eingebettete” Bilder usw.) .

Digital audio

Nehmen wir nun ein Beispiel: Die auf einer normalen Audio-CD aufgezeichnete unkomprimierte PCM-Audio-Bitrate wird wie folgt berechnet: 2 (Kanäle) × 16 (Bits pro Abtastung) × 44100 (Abtastungen pro Sekunde) = 1411200 (bps) ) = 1411.2 kbps … Lassen Sie uns nun den Track mit einem verlustfreien Codec (“verlustfrei” – “verlustfrei”, dh einem, der nicht zu Datenverlust führt), zum Beispiel dem FLAC-Codec, greifen und komprimieren. Infolgedessen erhalten wir eine niedrigere Bitrate als das Original, aber die Qualität bleibt unverändert. Hier ist deine erste Gegenargumentation.

Hier ist noch etwas hinzuzufügen. Die verlustfreie Komprimierungsausgangsbitrate kann sehr unterschiedlich sein (ist jedoch im Allgemeinen niedriger als bei unkomprimiertem Audio). Dies hängt von der Komplexität des komprimierten Signals bzw. von der Datenredundanz ab. Einfachere Signale werden also besser komprimiert (dh wir haben eine kleinere Dateigröße bei gleicher Dauer => niedrigere Bitrate), und komplexere Signale sind schlechter. Deshalb hat verlustfreie klassische Musik eine niedrigere Bitrate als beispielsweise Rock. Es muss jedoch betont werden, dass die Bitrate hier in keiner Weise ein Indikator für die Qualität des Klangmaterials ist.

Lassen Sie uns nun über verlustbehaftete Komprimierung sprechen. Zunächst müssen Sie verstehen, dass es viele verschiedene Encoder und Formate gibt, und selbst innerhalb desselben Formats kann sich die Codierungsqualität für verschiedene Encoder unterscheiden (z. B. QuickTime AAC-Codierungen sind viel besser als veraltete FAAC), ganz zu schweigen von der Überlegenheit von moderne Formate (OGG Vorbis, AAC, Opus) in MP3. Einfach ausgedrückt, von zwei identischen Spuren, die von verschiedenen Encodern mit derselben Bitrate codiert wurden, klingen einige besser und andere schlechter.

Es gibt auch eine Aufwärtskonvertierung. Das heißt, Sie können einen Titel im MP3-Format mit einer Bitrate von 96 kbps aufnehmen und in MP3 mit 320 kbps konvertieren. Die Qualität wird sich nicht nur nicht verbessern (schließlich können Daten, die während der vorherigen 96-kbit / s-Codierung verloren gegangen sind, nicht zurückgegeben werden), sondern auch noch schlechter werden. Es ist erwähnenswert, dass bei jeder verlustbehafteten Codierungsstufe (bei jeder Bitrate und jedem Codierer) eine gewisse Verzerrung in das Audio eingeführt wird.

Und noch mehr. Es gibt noch eine Nuance. Wenn beispielsweise die Bitrate eines Audiostreams 320 kbit / s beträgt, bedeutet dies nicht, dass die 320 kbit / s genau in dieser Sekunde codiert wurden. Dies ist typisch für die Codierung mit konstanter Bitrate und für Fälle, in denen eine Person in der Hoffnung auf höchste Qualität eine zu hohe konstante Bitrate erzwingt (z. B. Einstellen von CBR auf 512 kbps für Nero AAC ). Wie Sie wissen, wird die Anzahl der einem bestimmten Rahmen zugewiesenen Bits durch das psychoakustische Modell reguliert. Falls der zugewiesene Betrag jedoch viel niedriger als die eingestellte Bitrate ist, wird auch die Bitablagerung nicht gespeichert (Begriffe siehe Artikel “Was ist CBR, ABR, VBR?”) – Als Ergebnis erhalten wir nutzlose “Null-Bits”, die die Frame-Größe einfach auf die gewünschte “umbrechen” (dh die Größe des Streams auf die angegebene Größe erhöhen). Dies ist übrigens leicht zu überprüfen: Komprimieren Sie die resultierende Datei mit einem Aktenschrank (vorzugsweise 7z) und betrachten Sie das Komprimierungsverhältnis – je mehr, desto mehr Null-Bits (da sie zu Redundanz führen), desto mehr Speicherplatz wird verschwendet.

Verlustbehaftete Codecs (MP3 und andere) können mit moderner elektronischer Musik umgehen, aber klassische (akademische), Live- und Instrumentalmusik nicht effizient codieren.
Die “Ironie des Schicksals” ist hier, dass tatsächlich alles genau das Gegenteil ist. Wie Sie wissen, folgt akademische Musik in den allermeisten Fällen melodischen und harmonischen Prinzipien sowie der Instrumentalkomposition. Aus mathematischer Sicht führt dies zu einer relativ einfachen harmonischen Komposition der Musik.