Mit welchen Methoden wird digitales Audio effektiv komprimiert?


Free Download Mp4Gain
picture

Mit welchen Methoden wird digitales Audio effektiv komprimiert?
Compress Digital Audio

COMPRESS DIGITAL AUDIO

Derzeit sind Audio MPEG, PASC und ATRAC die bekanntesten. Alle von ihnen
Verwenden Sie die sogenannte “Wahrnehmung”
Codierung), bei der Informationen aus dem Tonsignal entfernt werden,
für das Ohr wahrnehmbar. Infolgedessen trotz der Änderung in Form und Spektrum
Signal, Ihre Hörwahrnehmung ist praktisch unverändert, und der Grad
Die Kompression führt zu einer leichten Qualitätsminderung. Eine solche Codierung
bezieht sich auf verlustbehaftete Komprimierungsmethoden, wenn
Es ist nicht mehr möglich, die ursprüngliche Wellenform aus dem komprimierten Signal genau zu rekonstruieren
gestalten.

Die Techniken zum Eliminieren eines Teils der Informationen basieren auf den Eigenschaften des Menschen.
wem man zuhört, Maskierung genannt: wenn es ein Hoch gibt
starke Spitzen (dominante Harmonische) schwächerer Frequenzgehalt
hören in unmittelbarer nähe von ihnen praktisch nein
akzeptiert (maskiert). Beim Codieren wird der gesamte Audiostream aufgeteilt
ist in kleine Quadrate unterteilt, von denen jedes ein Spektral wird
Präsentation und ist in mehrere Frequenzbänder unterteilt. Innerhalb der Streifen gibt es
führt die Definition und Entfernung von maskierten Sounds durch, nach denen jeder Frame
es wird direkt in spektraler Form adaptiv codiert. Alle
Diese Vorgänge können das Volumen (mehrmals) erheblich reduzieren
Daten unter Beibehaltung einer für die meisten Hörer akzeptablen Qualität
Ich lese.

Jedes der beschriebenen Codierungsverfahren ist durch eine Bitrate gekennzeichnet
die Bitrate, mit der die komprimierten Informationen kommen sollen
auf der Kabelbox, wenn das Audiosignal wiederhergestellt ist. Decoder konvertiert
eine Reihe von Momentansignalspektren, die zu einer herkömmlichen digitalen Wellenform komprimiert sind
gestalten.

MPEG Audio – Eine Gruppe von MPEG-standardisierten Audiokomprimierungsmethoden
(Moving Pictures Experts Group – eine Expertengruppe zur Verarbeitung von Bewegungen
Bilder). MPEG-Audiomethoden gibt es in verschiedenen
Typen – MPEG-1, MPEG-2 usw.; derzeit am häufigsten
kein MPEG-1-Typ.

Es gibt drei MPEG-1-Audioebenen für die Stereokomprimierung.
Ihre Signale:

Komprimierungsverhältnis 1 – 1: 4 mit einem Datenstrom von 384 kbps;
2-1: 6..1: 8 bei 256..192 kbps;
3 – 1: 10..1: 12 bei 128..112 kbps.

Die minimale Datenrate in jeder Schicht ist als 32 definiert
kbps; Die angegebenen Bitraten behalten die Signalqualität bei
ungefähr auf dem Niveau einer CD.

Alle drei Ebenen verwenden die Eingangs-Split-Spektraltransformation
Ändern des Rahmens in 32 Frequenzbändern. Das Optimalste in Bezug
Datenlautstärke und Klangqualität werden als Stufe 3 mit Bitrate erkannt
128 kbps und eine Datendichte von ungefähr 1 Mb / min. Wenn von unten zusammengedrückt
bei welchen Geschwindigkeiten beginnt die erzwungene Begrenzung des Frequenzbandes
15-16 kHz und Kanalphasenverzerrungen treten ebenfalls auf (Effekte wie z
Phaser oder Flanger).

MPEG-Audio wird in Computer-Soundsystemen, CD-i / DVD, verwendet.
CD-ROM “Audio”, digitales Radio / Fernsehen und andere Systeme
massive Schallübertragung.

PASC (Precision Adaptive Subband Coding – Präzises adaptives Intraband
Codierung) – ein Sonderfall von Audio MPEG-1 Layer 1 mit einer Geschwindigkeit
Stream 384 kbps (1: 4-Komprimierung). Wird im DCC-System verwendet.

ATRAC (Adaptive TRansform Acoustic Coding – Akustische Codierung
adaptive Transformation) basiert auf stereophonem Klang
Quantisiertes 16-Bit-Format mit einer Abtastrate von 44,1 kHz.
Beim Komprimieren wird jeder Frame in 52 Frequenzbänder unterteilt, was zu
Übertragungsgeschwindigkeit: 292 kbps (1: 5-Komprimierung). Im System angewendet

Free Download Mp4Gain
picture

Welche Schnittstellen werden für die digitale Audioübertragung verwendet?

Welche Schnittstellen werden für die digitale Audioübertragung verwendet?

Digital Interfaces

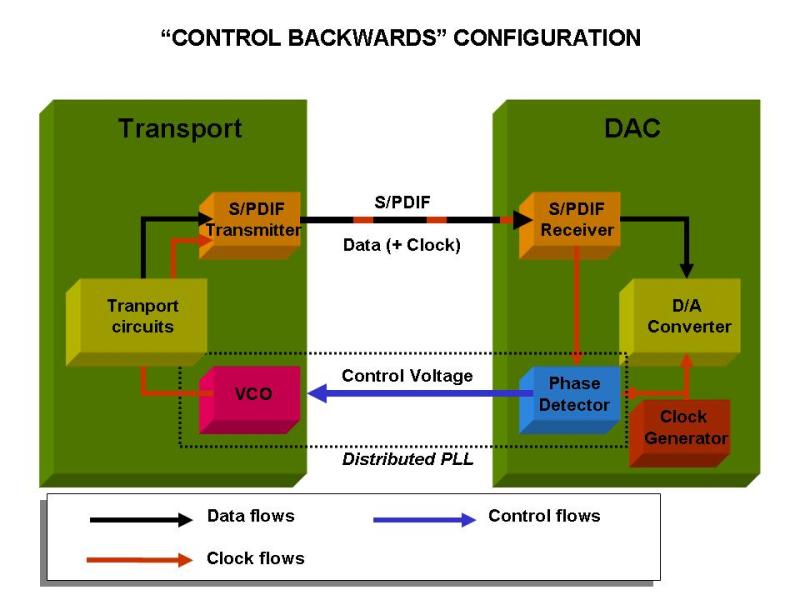
S / PDIF (Sony / Phillips Digital Interface Format – digitales Informationsformat
Schnittstelle von Sony und Philiрs) – digitale Schnittstelle für Heimradio
Mannschaft.

Digital Audio Interfaces

AES / EBU (Gesellschaft der Audioingenieure / Europäische Rundfunkunion – Gesellschaft
Toningenieure / European Broadcasting Association) – Digital Engineering
Schnittstelle für Studiofunkgeräte.

Beide Schnittstellen sind seriell und verwenden dieselbe Form
Markierungsmatte und Codiersystem: BMC-Code mit automatischer Synchronisation
(Zweiphasiger Markencode: Code mit einer doppelten Änderungsdarstellung einer Einheit
Phase) und kann Signale im PCM-Format von bis zu 24 Bit übertragen
bei Abtastraten bis zu 48 kHz.

Jeder Signalabtastwert wird als 32-Bit-Wort (Frame) übertragen, in dem
Rum 20 Ziffern werden verwendet, um die Zählung zu übertragen, und 12 – um sich zu bilden
Synchronisationspräambel, Übermittlung zusätzlicher Informationen und
Paritätsbit. Es können 4 Bits der Servicegruppe verwendet werden
Erweiterung des Sample-Formats auf 24 Bit.

192 aufeinanderfolgende Frames bilden einen Block, dessen Anfang markiert ist
spezieller Präambelcode des ersten Rahmens.

Zusätzlich zum Paritätsbit enthält der Serviceteil des Wortes ein Gültigkeitsbit
(Gültigkeit), die für jede gültige Antwort Null sein muss
Konten. Wenn ein Wort mit einem einzigen Bit Gültigkeit oder mit einer Verletzung empfangen wird
Parität im Wort interpretiert der Empfänger die gesamte Stichprobe als falsch und
Sie können ihn durch den alten Wert ersetzen oder interpolieren
basierend auf mehreren benachbarten gültigen Lesevorgängen. Zählt
als ungültig markiert kann CD-Player übertragen, die
DAT-Rekorder und andere Geräte, ja, wenn Sie Informationen von lesen
Das Medium konnte bei Lesefehlern nicht korrigiert werden
Ki.

Der Serviceteil des Wortes enthält auch die C-Bits (Kanalstatus – Status
Kanal) und U (Benutzerbit). Konstanter Preis
Niere jedes dieser Bits, einzeln aus jedem Blockrahmen entnommen,
bildet ein 192-Bit-Wort von Blockdienstbits, in denen Informationen übertragen werden
Informationen über den Titel der Arbeit, Titelnummer,
Gerät, CD-Subcodes usw. S / PDIF sendet
Kopierschutzeinstellungen (SCMS).

Das Standardcodierungsformat ist für die Übertragung von eins und zwei ausgelegt
Kanalsignal jedoch, wenn Servicebits verwendet werden
Durch Codieren der Kanalnummer kann ein Mehrkanalsignal übertragen werden.

Auf der elektrischen Seite bietet S / PDIF eine koaxiale Verbindung
Kabel mit charakteristischer Impedanz von 75 Ohm und Cinch-Steckern (“Tüll”
pan “), Signalamplitude – 0,5 V. AES / EBU stellt die Verbindung her
2-adriges abgeschirmtes symmetrisches Kabel mit Transformator
Entkopplung über RS-422-Schnittstelle mit Signalamplitude 3-10 V, Anschlüsse –
Kanone XLR 3-polig. Es gibt auch optische Optionen
Transceiver: TosLink (Kunststofffaser) und AT & T Link
(Glasfaser).

Wie Ton codiert wird

Wie Ton codiert wird

How sound is encoded

Schall ist eine Welle, die sich häufiger in Luft, Wasser oder einem anderen Medium mit einer sich ständig ändernden Intensität und Frequenz ausbreitet.

How sound is encoded

Eine Person kann Schallwellen (Luftschwingungen) mit Hilfe des Hörens in Form von Schall wahrnehmen und dabei zwischen Lautstärke und Tonhöhe unterscheiden.

Je höher die Intensität der Schallwelle ist, desto lauter der Schall, desto höher die Frequenz der Welle, desto höher die Tonhöhe.

Wir haben zuvor ausführlicher über die menschliche Wahrnehmung von Geräuschen geschrieben. Sie können sie hier lesen.

Wie Audio codiert wird (digitale Codierung und Audioverarbeitung)
Abhängigkeit der Lautstärke sowie des Tons von der Intensität und Frequenz der Schallwelle.

Hertz (bezeichnet mit Hz oder Hz) ist eine Maßeinheit für die Frequenz periodischer Prozesse (z. B. Schwingungen).
1 Hz bedeutet eine Ausführung des Prozesses in einer Sekunde: 1 Hz = 1 / s.

Wenn wir 10 Hz haben, bedeutet dies, dass wir zehn Ausführungen dieses Prozesses in einer Sekunde haben.

Das menschliche Ohr kann Schall mit Frequenzen von 20 Schwingungen pro Sekunde (20 Hertz, leiser Schall) bis 20.000 Schwingungen pro Sekunde (20 KHz, hoher Schall) wahrnehmen.

Darüber hinaus kann eine Person Schall in einem weiten Bereich von Intensitäten wahrnehmen, bei denen die maximale Intensität 1014-mal höher ist als die minimale (einhunderttausend Milliarden Mal).

Zur Messung der Schalllautstärke wurde eine spezielle Einheit von “Dezibel” (dB) erfunden und verwendet.

Eine Abnahme oder Zunahme der Schalllautstärke um 10 dB entspricht einer 10-fachen Abnahme oder Zunahme der Schallintensität.

Charakteristischer Klang Lautstärke gemessen in Dezibel
Untergrenze der Empfindlichkeit des menschlichen Ohrs 0
Blatt flüstert zehn
Gespräch 60
Horn 90
Düsentriebwerk 120
Schmerzschwelle 140

Lautstärke in Dezibel

Audio-Sampling synchronisieren

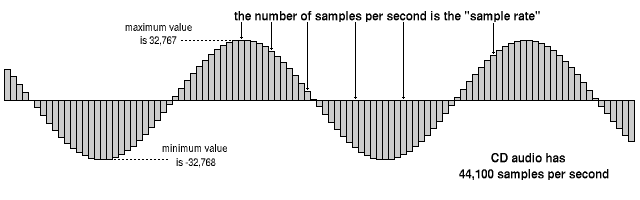
Damit Computersysteme Ton verarbeiten können, muss ein kontinuierliches Audiosignal durch Zeitabtastung in eine diskrete digitale Form umgewandelt werden.

Dazu wird eine kontinuierliche Schallwelle in separate kleine Zeitabschnitte unterteilt, für jeden Abschnitt wird ein bestimmter Wert der Schallintensität eingestellt.

Daher wird die kontinuierliche Abhängigkeit der Lautstärke des Schalls zum Zeitpunkt A (t) durch eine diskrete Folge von Lautstärkepegeln ersetzt. In der Grafik scheint dies eine glatte Kurve durch eine Folge von “Schritten” zu ersetzen.

Wie Audio codiert wird (digitale Codierung und Audioverarbeitung)
Audio-Sampling synchronisieren

Ein an die Soundkarte angeschlossenes Mikrofon wird verwendet, um analoges Audio aufzunehmen und in ein digitales Format umzuwandeln.

Je dichter die einzelnen Streifen auf der Grafik sind, desto besser ist es, den Originalton endgültig wiederherzustellen.

Die resultierende digitale Klangqualität hängt von der Anzahl der Schallpegelmessungen pro Zeiteinheit ab, dh von der Abtastfrequenz.

Die Audio-Abtastrate ist die Anzahl der Audio-Lautstärkemessungen in einer Sekunde.

Je mehr Messungen in einer Sekunde durchgeführt werden (je höher die Abtastfrequenz), desto genauer wiederholt die “Leiter” des digitalen Audiosignals die Kurve des analogen Signals.

Jedem “Schritt” des Diagramms wird ein bestimmter Wert für die Lautstärke zugewiesen. Lautheitspegel können als eine Reihe möglicher N-Zustände (Abstufungen) betrachtet werden, für deren Codierung eine bestimmte Menge an I-Informationen erforderlich ist, die als Audiocodierungstiefe bezeichnet wird.

Die Audiocodierungstiefe ist die Informationsmenge, die zum Codieren der diskreten Lautstärkepegel von digitalem Audio erforderlich ist.

Bei bekannter Codierungstiefe kann die Anzahl der digitalen Audio-Lautstärkepegel nach der allgemeinen Formel N = 2 I berechnet werden.

Die Audiocodierungstiefe beträgt beispielsweise 16 Bit. In diesem Fall beträgt die Anzahl der Lautstärkepegel:

N = 2I = 2 16 = 65 536.

Während des Codierungsprozesses wird jedem Schallpegel ein eigener 16-Bit-Binärcode zugewiesen, der kleinste Schallpegel entspricht dem Code 0000000000000000 und der höchste – 1111111111111111.

Digitalisierte Audioqualität

Je höher die Abtastrate und die Tiefe der Audiokodierung sind, desto besser klingt der digitalisierte Ton und desto besser können Sie den digitalisierten Ton näher an den Originalton bringen.

Die niedrigste Qualität des digitalisierten Tons, die der Qualität der Telefonkommunikation entspricht, wird mit einer Abtastrate von 8000 Mal pro Sekunde, einer Abtastrate von 8 Bit und durch Aufzeichnen einer Audiospur (“Mono” -Modus) erhalten.
Es sollte jedoch beachtet werden, dass zur Verbesserung dieses Klangs in der Telefonie Geräte verwendet werden, die Sprachsynthesizern und Sprachcodierern ähneln. Über Sprachcodierer auch dieser Artikel

Digitale Audiokodierung

Digitale Audiokodierung

Digital audio encoding

Um Schallschwingungen in digitaler Form darzustellen, wird die Amplitude des Schallsignals zu jedem bestimmten Moment des Schalls gemessen.

DIGITAL AUDIO ENCODING

Da die Wellenform des Schalls von Natur aus kontinuierlich ist, ist es für seine genaue digitale Anzeige erforderlich, die Amplitude unendlich oft pro Sekunde zu messen und die Amplitudenskala durch eine unendliche Anzahl von Abstufungen zu teilen. In der Realität liegt die Anzahl der Messungen pro Sekunde (Abtastrate) typischerweise zwischen 10.000 und 96.000. Derzeit sind die häufigsten Abtastraten 44100 Hz (der Standard für CD-Audio) und 48000 Hz (der Hauptstandard für CD-Audio). DAT). Die Anzahl der Amplitudenabstufungen (Auflösung) wird im Allgemeinen gleich 28, 216 oder 224 angenommen (abhängig von der Anzahl der für diese Informationen zugewiesenen Bits).

Natürlich ist eine Verzerrung beim Abtasten eines kontinuierlichen Signals unvermeidbar. Je niedriger die Abtastrate und / oder Auflösung ist, desto näher liegt die Ausgangswellenform am Rechteck. In diesem Fall treten Hochfrequenzverzerrungen auf, die teilweise durch am DAC-Ausgang installierte Filter unterdrückt werden.

Digitalisiertes Audio benötigt viel Speicher. Bei einer Standard-Abtastrate von 44100 Hz und einer Auflösung von 16 Bit würde das Audiomaterial (Stereo) für eine Minute 10.584.000 Byte (ungefähr 10,09 MB) betragen. Außerdem werden die Audiodateien von Standardarchivprogrammen (zip, arj usw.) sehr schlecht komprimiert. Daher gibt es spezielle Komprimierungsalgorithmen für sie. Beispielsweise benötigt eine mit ADPCM komprimierte WAV-Datei etwa viermal weniger Speicherplatz. Es kann jedoch zu Verzerrungen kommen. Daher ist es besser, bei der professionellen Arbeit keine Audiokomprimierungsalgorithmen zu verwenden.