Klangkomprimierung mit Software


Free Download Mp4Gain
picture

Klangkomprimierung mit Software
Sound Compression

Es gibt viele Arten von Kompressoren sowie andere Tonverarbeitungseinheiten: digital und analog, Hardware und Software, manuell und automatisch, optoelektronisch, Ventil, Transistor usw.

Music Loudness War: Alternative Sound Compression

Jeder Kompressor hat 5 Hauptparameter:

– Schwellenwert. In Dezibel ausgedrückt. Dies ist der Wert, über dem der Kompressor beginnt, das Signal zu dämpfen. So funktioniert ein Schallkompressor
Abbildung: 12. Funktionsweise des Schallkompressors.
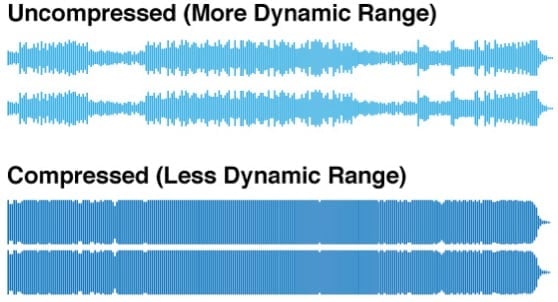
Die Wahl der richtigen Schwelle ist die schwierigste Aufgabe. Bei Einstellung auf einen hohen Pegel wird das Signal praktisch unkomprimiert, und bei einem niedrigen Schwellenwert wird das Signal gedämpft und verliert seinen Informationsgehalt.

– Kompressionsverhältnis (Verhältnis). Ausgedrückt im “x: 1” -Format. Dieser Wert bestimmt den Dämpfungsgrad des Signals, dessen Pegel den Schwellenwert überschritten hat. Wenn das Verhältnis beispielsweise 1: 1 beträgt, wird das Signal nicht komprimiert. Wenn der Wert auf ∞: 1 eingestellt ist, ist das Signal stark eingeschränkt und der Kompressor führt die Funktionen eines anderen Geräts aus, des Begrenzers (English Limit – to limit). Die Amplitude des Kompressorausgangssignals bei Überschreitung des Schwellenwerts kann durch die folgende Formel bestimmt werden:
OUT = Schwelle + (IN – Schwelle) / Verhältnis

Wenn das Eingangssignal beispielsweise IN = -4 dB ist, der Schwellenwert auf -12 dB eingestellt ist und das Kompressionsverhältnis 2: 1 beträgt, beträgt der Ausgangspegel OUT = -8 dB.

– Angriffszeit. Sie wird normalerweise in Millisekunden ausgedrückt. Dieser Wert definiert das Zeitintervall zwischen dem Signal, das den Schwellenwert überschreitet, und dem Aktivieren des Kompressors. Ein Beispiel für eine akustische Kompressoranwendung

– Wiederherstellungszeit (Release). Sie wird normalerweise in Millisekunden ausgedrückt. Dieser Wert bestimmt das Zeitintervall, in dem die Komprimierung fortgesetzt wird, wenn der Pegel des Eingangssignals unter den Schwellenwert fällt. Einfach ausgedrückt, wenn die Angriffszeit die Aggressivität und Reaktionsfähigkeit des Kompressors bestimmt, ist die Abklingzeit die Trägheit des Kompressionsprozesses.

Durch die Kombination der Einstellungen für Angriffs- und Wiederherstellungszeit können Sie eine Vielzahl von Ergebnissen erzielen. Beispielsweise ermöglicht eine lange Angriffszeit die Komprimierung, ohne schnelle Transienten zu beeinträchtigen. Für die natürliche Wiedergabe wird die Release-Zeit meistens entsprechend der Dauer des Musikinstruments eingestellt. Einige Kompressoren erlauben keine manuelle Anpassung der Attack- und Release-Zeiten, sondern stellen sie automatisch durch Analyse des Eingangssignals ein. Dies vereinfacht die Arbeit mit dem Gerät erheblich, verringert jedoch gleichzeitig seine Fähigkeiten, insbesondere im Bereich der künstlerischen Klangverarbeitung.

– Verstärkung oder Wiederherstellung eines Signals (Kompensationsverstärkung). In Dezibel ausgedrückt. Dieser Wert bestimmt die Amplitude der Kompressorleistung. Der Kompressionsprozess führt zwangsläufig zu einer Verringerung der Amplitude. Daher haben viele dieser Geräte einen Verstärker am Ausgang, mit dessen Hilfe die sogenannte Normalisierung des Signals durchgeführt wird, dh dessen Amplitude auf den Wert gebracht wird, den das Eingangssignal hatte. Darüber hinaus vereinfacht die Normalisierung die Arbeit des Toningenieurs, da die Signale am Ein- und Ausgang des Kompressors beim Hören die gleiche Amplitude haben.
Die meisten modernen Kompressoren bieten zusätzliche Modi, Einstellungen und Funktionen:

–Bypass (Bypass). Wenn diese Funktion aktiviert ist, geht das Eingangssignal ohne Verarbeitung direkt zum Ausgang. Auf diese Weise können Sie “saubere” und verarbeitete Signale effektiv vergleichen und Anpassungen an den Kompressoreinstellungen vornehmen.
Empfindlichkeitseinstellung. Diese Einstellung erfolgt normalerweise mit einem Pegelschalter und ermöglicht es dem Kompressor, Signale mit einer Amplitude von -10,0 oder +4 dB zu verarbeiten.

Art der Kompression (Knie). Unterscheiden Sie zwischen weicher Kompression (weiches Knie) und harter Kompression (hartes Knie). Die Unterschiede bestehen darin, wie schnell und reibungslos der Kompressor vom “Leerlauf” in den Kompressionsmodus wechselt, nachdem das Signal den Schwellenwert überschritten hat. Beispiele für akustische Eigenschaften für weiche und harte Kompressionsmodi

Der Hard-Modus wird verwendet, um die Peaks zu “begrenzen”. Der Klang aufgrund der “ausgeprägten” Unterbrechung der Tonhöhencharakteristik ist scharf und abrupt, insbesondere bei einem hohen Kompressionspegel. Bei einer gleichmäßigen Reaktion beginnt die Komprimierung früh, wenn sich der Signalpegel einem vorbestimmten Schwellenwert nähert. Das Kompressionsverhältnis steigt gleichmäßig an und erreicht den eingestellten Wert an dem Punkt, der dem Schwellenwert entspricht. “Sanfte” Komprimierung wird für die meisten Instrumente und Stimmen bevorzugt, da sie transparenter und natürlicher klingt.


Free Download Mp4Gain
picture

AUDIOVERARBEITUNGSGERÄTE.

AUDIOVERARBEITUNGSGERÄTE.

Processing Device

Die Bürger sind der festen Überzeugung, dass Klangverarbeitungsgeräte die Qualität eines professionellen Klangwiedergabesystems verbessern können. Dies ist wahr … Diese These sollte jedoch nicht auf die Klangqualität extrapoliert werden, die dieses System wiedergibt.

Processing Devices

Bei Verwendung eines Tonverarbeitungsgeräts kann sich dessen Qualität im Prinzip nur verschlechtern. Tatsache ist, dass sie das Problem des Klangs selbst überhaupt nicht lösen, sondern es Toningenieuren und Toningenieuren ermöglichen, die Härte der Leistung von Sängern und Musikern auszugleichen, Ungenauigkeiten im Klang von Musikinstrumenten zu beseitigen und zu kompensieren Defekte, die durch die falsche Wahl des Geräts und seines Standorts verursacht werden, verringern auch die Auswirkungen auf die Reproduktion. die akustischen Eigenschaften der Räumlichkeiten. Aber wenn zum Beispiel ein Sänger seine Stimme gut beherrscht und weiß, wie man ein Mikrofon benutzt, braucht er keinen Kompressor.

Anfänglich wurden die mit der speziellen Verzerrung des wiedergegebenen Signals verbundenen Prozesse nur in kommerziellen Soundsystemen wie Telefonen, Funk- oder Beschallungssystemen verwendet. Sie haben inzwischen breite Anwendung in der Musik gefunden und werden verwendet, um ein Instrument oder eine Stimme ungewöhnlich oder unnatürlich zu machen. Dies geschieht in erster Linie, um das Publikum zu überraschen und die Wirkung des Hörens des Stücks zu steigern.

Aus wissenschaftlicher Sicht ist jedes Audiogerät (ein Mikrofon, ein Leistungsverstärker oder ein Lautsprechersystem) auch ein Tonverarbeitungsgerät. Erstens sind sie nicht ideal und ändern die Amplitude und Phase der Signale, zweitens treten diese Änderungen auf unterschiedliche Weise bei unterschiedlichen Frequenzen auf, und drittens führen nichtlineare Verzerrungen in ihnen zum Auftreten neuer Komponenten spektral in ihnen. Das erste Klangverarbeitungsgerät war übrigens der Leslie-Lautsprecher, der in den 1930er und 1940er Jahren in Verbindung mit der elektrischen Orgel von Hammond verwendet wurde und ihm ein “Knurren” gab.

Parameter und Klassifizierung von Audioverarbeitungsgeräten.
Tonarbeiten können sowohl in digitalen als auch in analogen Formaten oder sogar ohne elektroakustische Umwandlung durchgeführt werden. In diesem Sinne muss entschieden werden: Was ist mit Tonverarbeitungsgerät gemeint?

Daher werden wir Software und Hardware betrachten, die mit elektrischen Audiofrequenzsignalen (sowohl in analoger als auch in digitaler Form) in Echtzeit arbeiten. Bevor die einzelnen Methoden zur Arbeit mit ihnen qualitativ bewertet werden, muss verstanden werden, wie und zu welchem ​​Zweck die Verarbeitung von Audiosignalen durchgeführt wird.

Alle Audioverarbeitungsgeräte können unter bestimmten Bedingungen in drei Gruppen unterteilt werden:

1. Geräte, die dem Signal keine zusätzlichen Komponenten hinzufügen (Audioverarbeitungseinheiten);
2. Geräte, die dem Signal zusätzliche Komponenten hinzufügen (Soundeffekte);
3. Geräte, die neue Signale basierend auf den Eigenschaften des ursprünglichen Signals synthetisieren (Vocoder).

AUDIOVERARBEITUNGSEINHEITEN
Dazu gehören Verzögerungsblöcke, Equalizer, Frequenzweichen und Kompressoren.

Der Bedarf an Verzögerungseinheiten trat in den 40er Jahren des 20. Jahrhunderts auf, als Stereoklang im Kino eingesetzt wurde. Wie Sie wissen, nimmt eine Person Schall als eine Reihe von Signalen wahr, die jedes der Ohren erreichen. Durch die Analyse der Verzögerung der Schallwelle, die jedes Ohr erreicht, kann unser Gehirn leicht den Ort der Schallquelle bestimmen.

Mit einer Verzögerungseinheit, die beispielsweise auf einem der Kanäle verwendet wird, ist es möglich, eine Änderung der Position der Schallquelle in Bezug auf den Hörer zu simulieren. Natürlich nimmt der Hörer bei der Bildung räumlicher Effekte freiwillig am Klangbild teil. Im Allgemeinen ist die Schallverzögerung ein natürliches Phänomen, das mit der Tatsache verbunden ist, dass die Ausbreitungsgeschwindigkeit einer Schallwelle relativ gering ist. Sicher ist jeder mit dem Echoeffekt vertraut, der auftritt, wenn eine Welle von einem Hindernis reflektiert wird und ihren Rückweg passiert. Der Unterschied zwischen dem mit Hilfe der Verzögerungseinheit erzielten Effekt besteht darin, dass sich das “reflektierte” Signal nicht vom Original unterscheidet. Unter realen Bedingungen ändert sich das Spektrum des Signals während der Reflexion erheblich, da seine verschiedenen Komponenten unterschiedlich von Hindernissen reflektiert werden.

Ein Beispiel für die Schallausbreitung in einem Raum
Derzeit sind Verzögerungseinheiten in Audioprozessoren weit verbreitet. Sie werden verwendet, um das Schallfeld in großen und komplexen Räumen, in Konferenzräumen auszugleichen sowie um Soundeffekte wie Echo, Verzögerung, Hall usw. zu erzeugen.

DRUCKREGELN

DRUCKREGELN

Compression

Eine Minute reinen, unkomprimierten und digitalisierten Tons erfordert ungefähr 10 MB auf der Festplatte eines Computers, wodurch Musikdateien für die überwiegende Mehrheit in komprimierter Form gespeichert werden, um Platz zu sparen. Wie lange dauert eine Minute unkomprimiertes Video? Um beispielsweise ein 60-Sekunden-Video mit einer Rate von 30 Bildern pro Sekunde, einer Auflösung von 720 x 576 Pixel und einer Farbtiefe von 16 Bit zu platzieren, benötigen Sie ungefähr eineinhalb Gigabyte freien Speicherplatz. Und das ohne Berücksichtigung der Audiospur. Nach diesen Zahlen muss wahrscheinlich nicht erklärt werden, warum digitale Videos ausschließlich in komprimierter Form auf unseren Computern gespeichert werden.

Compression

Es gibt mehrere Dutzend gängige Komprimierungsformate, die unterschiedliche Komprimierungsalgorithmen verwenden und jeweils unterschiedliche Ergebnisse liefern.

DV (Digital Video) ist einer der ersten Komprimierungsalgorithmen für Videoübertragungen, dessen Entwicklung 1993 gemeinsam von mehreren Unternehmen begonnen wurde, die die größten Hersteller von Videogeräten sind (Sony, JVC, Panasonic, Philips und Hitachi). Das DV-Format bietet ein niedriges Datenkomprimierungsverhältnis (5: 1) und zeichnet sich durch eine hohe Bitrate aus, sodass die ausgegebene Videodatei ziemlich groß ist. Eine Minute DV-Video benötigt also etwa 200 MB (1 Stunde – 12 GB) auf digitalen Speichermedien.

Dieses Format wird am häufigsten für die Komprimierung beim Aufnehmen von Videos mit Consumer-Digitalkameras und professionellen Camcordern verwendet. Gleichzeitig wird das Filmmaterial aufgrund des geringen Komprimierungsverhältnisses in sehr hoher Qualität erhalten, und das Komprimierungsverfahren selbst, das in Echtzeit erfolgt, erfordert keine leistungsstarken technischen Komponenten.

Es ist wahr, dass es immer noch unpraktisch ist, Videos auf einem Heimcomputer zu speichern, und noch mehr auf optischen Datenträgern im DV-Format, da dies zu viel Platz beansprucht. Die Spezialisten mussten sich also zusätzliche Komprimierungsalgorithmen überlegen, mit deren Hilfe es möglich wäre, die Größe eines digitalen Films um ein Vielfaches zu reduzieren.

MPEG (Moving Picture Experts Group) ist eine vollständige Familie von Standards zur Komprimierung digitaler Informationen, die von der gleichnamigen Expertengruppe entwickelt und standardisiert wurden, die 1988 von der ISO-Organisation gegründet wurde.

Die erste Frucht seiner Entwicklung war der ursprüngliche MPEG-1-Video- und Audiokomprimierungsstandard. 1993 wurde unter Beteiligung von JVC und Philips die Video-CD-Spezifikation (VCD) entwickelt, die vielen Benutzern bekannt ist. Wie der Name schon sagt, ist VCD ein Format zum Speichern von komprimiertem Video mit normalem CD-Audio.

Durch die Verwendung von MPEG-1-Algorithmen für die Codierung können Sie einen Videostream von bis zu 1,5 Mbit pro Sekunde mit einer Bildauflösung von 352 x 288 Pixel für PAL oder 352 x 240 für NTSC empfangen. Danach kann eine normale CD 74 Minuten speichern Video mit Ton in VHS-Qualität (wie ein normaler Videorecorder) …

1995 wurde der beliebteste MPEG-2-Standard veröffentlicht, der später in digitalen Video-DVDs sowie bei der Übertragung von Kabel- und Satellitenfernsehsignalen weit verbreitet wurde. Die Bildqualität ist hier viel höher als beim Vorgänger: Bei 25 Bildern pro Sekunde beträgt die Auflösung 720 x 576 Pixel für das PAL-System und für das NTSC-System: 720 x 480 bei 30 Bildern / s. Gleichzeitig beträgt die durchschnittliche maximale Übertragungsbreite 9,8 Mbit / s, was fast dem 7-fachen der von Video-CD entspricht. Ein weiterer unbestreitbarer Vorteil von MPEG-2 ist die Möglichkeit, eine fünfkanalige Audiospur (Dolby Digital 5.1 und DTS) zu speichern.

Die maximale Kapazität einer DVD-Double-Layer-Disc (DVD-9) beträgt 8,5 GB, auf der bis zu drei Stunden Video in maximaler Qualität gespeichert werden können. Wenn Ihnen eine DVD mit mehreren Filmen gleichzeitig angeboten wird, sollten Sie wissen, dass Sie höchstwahrscheinlich ein Bild von geringer Qualität wie eine Video-CD mit sehr niedriger Auflösung und Bitrate erwarten.

Zusammen mit MPEG-2 begann ungefähr zur gleichen Zeit die Entwicklung eines neuen MPEG-3-Standards, der Audio- und Videoübertragungen auf hochauflösendem Fernsehen mit einer Datenübertragungsrate von 20 bis 40 Mbit / s codieren soll. Aber sehr Es wurde schnell klar, dass für diese Aufgaben eine leicht modifizierte Version des MPEG-2-Standards verwendet werden kann. Danach wurden alle Weiterentwicklungen von MPEG-3 eingestellt und dieser Standard wird heute nicht mehr verwendet.

Es ist anzumerken, dass der Begriff “MPEG-3” häufig mit der beliebten MP3-Audiokomprimierungstechnologie assoziiert wird. Dies ist jedoch grundsätzlich falsch, da der korrekte Name MPEG-1 Audio Layer 3 lautet.

Schließlich erschien 1998 eine neue Familie von Videokomprimierungsformaten: MPEG-4. Es wurde mit dem Ziel entwickelt, die Bildqualität bei niedrigen Bitraten zu verbessern.

Verlustbehaftete Komprimierung: Komprimieren Sie Audio und Video

Verlustbehaftete Komprimierung: Komprimieren Sie Audio und Video

Lossy cmpression

Hochwertiges digitalisiertes Audio erfordert viel Speicherplatz. Versuche, die Dateigröße mit Standard-Aktenschränken zu reduzieren, führen aufgrund der Spezifität der Audiodaten nicht zu signifikanten Gewinnen. Es ist jedoch möglich, mit speziellen Methoden, die auf der Analyse der Datenstruktur und der anschließenden Komprimierung mit einigen Verlusten basieren, ein ziemlich signifikantes Maß an Komprimierung der Audioinformationen zu erreichen.

Lossy Compression

Die reale Möglichkeit einer Klangverarbeitung, deren Qualität mit den vorhandenen analogen Beispielen vergleichbar ist, trat erst Ende der 1980er Jahre auf. 1988 bildete die Internationale Organisation für Normung (ISO) das MPEG-Komitee (Moving Image Experts Group). , deren Hauptaufgabe es ist, Standards für die Codierung von bewegten Bildern, Ton und deren Kombination zu entwickeln. In den zehn Jahren seines Bestehens hat das Komitee eine Reihe von Normen zu diesem Thema entwickelt. Zusammenfassend wurden mehrere spezifische Formate für die Speicherung von Daten empfohlen, die sich durch hervorragende Qualität der Ergebnisse und Datenfluss auszeichnen.

Derzeit sind MPEG-1, MPEG-2 und MPEG-4 die drei am häufigsten verwendeten Videospeicherstandards. Innerhalb der ersten beiden Formate gibt es auch Formate zum Speichern von Audioinformationen: Layer-1, Layer-2 und Layer-3. Diese drei Audioformate sind für MPEG-1 definiert und kleinere Erweiterungen werden in MPEG-2 verwendet. Die drei Formate ähneln sich, verwenden jedoch unterschiedliche Kompromisse zwischen Komprimierung und Komplexität. Layer-1 ist die einfachste Stufe, erfordert keine signifikanten Komprimierungskosten, bietet aber auch ein vernachlässigbares Komprimierungsverhältnis. Layer-3-Level: Am zeitaufwändigsten und bietet die beste Komprimierung. In letzter Zeit hat dieses Format immense Popularität erlangt. Es wird oft als MP3 bezeichnet. Dieser Name ist mit der Erweiterung der in diesem Format gespeicherten Audiodateien verbunden.

Grundidee, bei der alle Komprimierungsmethoden für Audiosignalverluste – die subtilen Details des Originaltons ignorieren, die außerhalb dessen liegen, was das menschliche Ohr wahrnimmt. Hier können mehrere Punkte hervorgehoben werden.

Geräuschpegel. Die Klangkomprimierung basiert auf einer einfachen Tatsache: Wenn sich eine Person in der Nähe einer lauten Sirene befindet, ist es unwahrscheinlich, dass sie die Konversation der Personen in der Nähe hört. Dies geschieht auch nicht, weil eine Person einem lauten Geräusch große Aufmerksamkeit schenkt, sondern in größerem Maße, weil das menschliche Ohr tatsächlich Geräusche übersieht, die im gleichen Frequenzbereich wie ein lauteres Geräusch liegen. Dieser Effekt wird als Maskierung bezeichnet und ändert sich mit dem Unterschied in Lautstärke und Frequenz des Klangs.

Der zweite Punkt ist die Aufteilung des Audiofrequenzbandes in Teilbänder, von denen jedes separat weiterverarbeitet wird. Das Codierungsprogramm extrahiert die lautesten Töne in jedem Band und verwendet diese Informationen, um einen akzeptablen Rauschpegel für dieses Band zu bestimmen. Die besten Codierungsprogramme berücksichtigen auch den Einfluss benachbarter Bänder. Ein sehr lauter Ton in einem Band kann den Maskierungseffekt und benachbarte Bänder beeinflussen.

Ein weiterer Punkt der Kodifizierung ist die Verwendung eines psychoakustischen Modells, das auf den Besonderheiten der menschlichen Wahrnehmung von Schall basiert. Komprimierung Die Verwendung dieses Modells basiert auf der Entfernung offensichtlich unhörbarer Frequenzen unter sorgfältigerer Erhaltung von Geräuschen, die vom menschlichen Ohr klar unterschieden werden können. Leider kann es hier keine genauen mathematischen Formeln geben. Die menschliche Wahrnehmung von Geräuschen ist ein komplexer Prozess, der nicht vollständig verstanden wird. Daher basiert die Auswahl der Komprimierungsmethoden auf der Analyse des Hörens und dem unterschiedlichen Vergleich komprimierter Geräusche durch Expertenteams. Hier gibt es jedoch praktisch unbegrenzte Möglichkeiten, psychoakustische Modelle zu verbessern. Die meisten der vorhandenen Algorithmen zum Codieren der menschlichen Stimme basieren auf der hohen Vorhersagbarkeit des Signals; Universelle MPEG-Komprimierungsalgorithmen haben versucht, diese Technik mit variablem Erfolg anzuwenden.

Eine weitere Komprimierungstechnik ist die Verwendung von sogenanntem Joint Stereo. Es ist bekannt, dass das menschliche Hörgerät nur die Richtung der Mittenfrequenzen, des hohen und des niedrigen Tons sozusagen getrennt von der Quelle bestimmen kann. Dies bedeutet, dass diese Hintergrundfrequenzen in ein Monosignal codiert werden können. Darüber hinaus nutzt die Komprimierung den Unterschied in der Komplexität der Flüsse in den Kanälen. Wenn beispielsweise für einige Zeit auf dem rechten Kanal völlige Stille herrscht, wird dieser “reservierte” Ort verwendet, um die Qualität des linken Kanals zu verbessern.