Über Lossy


Free Download Mp4Gain
picture

Über Lossy

Lossy

Wir alle lieben gute Musik. In jüngerer Zeit war die Audio-CD gute digitale Musik. Dies sind 44100 Hz, Stereo, 16 Bit (linear) pro Kanal, in keiner Weise komprimiert, was laut Wikipedia 1411,2 kbps bedeutet.

Lossy

Aber am Ende des 20. Jahrhunderts, in der Ära der Geburt von Multimedia, als Musik nicht nur auf Playern, sondern auch auf Computern abgespielt wurde, stellte sich heraus, dass die Audio-CD (dh nacktes PCM) gerade ist besser. Kompresse. Es gab zum Beispiel Microsoft ADPCM, das diesen Fall in WAV-Dateien ein wenig komprimierte, ohne an Qualität zu verlieren. Aber im Allgemeinen würde die ursprüngliche 44-kHz-Stereoanlage auf diese Weise immer noch viel Platz benötigen. Daher sank die Qualität auf 22 kHz Mono. Eines der ersten Multimedia-Alben dieser Zeit: “Immersion” der Gruppe “Nautilus Pompilius” ist immer noch da draußen, und ich habe es getan.

Also hat MP3 gewonnen. Speichern und Verteilen von komprimierter Musik. Bei 128 kbps “CD-Qualität”.

MP3 kam seltsamerweise hoch. Technisch gesehen ist dies MPEG-1 Audio Layer 3. Eine Schicht zum Komprimieren von Audiodaten zu einem modernen, progressiven Standard zum Speichern von Videodaten auf Video-CDs. Nur in seinem eigenen MP3-Dateiformat gepackt. Die Video-CD ist für niemanden mehr interessant. Der folgende MPEG-2-Standard wird für DVD- und digitale Fernsehsendungen (nicht HD) verwendet. Der nächste MPEG-4-Standard wird jetzt für HD-Videos verwendet und entwickelt sich weiter.

MP3 war revolutionär. Es war (fast) das erste verlustbehaftete Komprimierungsformat. Wenn wir nicht versuchen, alles zu bewahren, was im ursprünglichen Signal enthalten war, sondern basierend auf einem psychoakustischen Modell herausschneiden, was eine Person sowieso nicht hören wird, und den Rest komprimieren. Wie JPEG.

Dann habe ich versucht, die gesammelte Audiosammlung zu digitalisieren. Kompaktkassetten (nur “Kassetten”, aber richtiger “Kompaktkassetten”) erwiesen sich als völlige Scheiße. Der Frequenzbereich ist so, dass es keinen Sinn macht, mit mehr als 22 kHz abzutasten. Es gab keine Rekorder von Rolle zu Rolle im Haus. Aber Schallplatten erschütterten die Klangqualität. Mit guter Ausrüstung können Sie eine bessere Qualität als mit einer CD zeichnen. Sie müssen nur die Klicks loswerden.

Und dann wurde mir klar, dass MP3 auch Scheiße ist. Bei diesen 128 kbps leidet die Klangqualität stark. Und das Schrecklichste ist, dass abscheuliche Metalltöne dort erscheinen, wo sie nicht sein sollten. Meine Ohren brauchen mindestens 192 kbps und je mehr desto besser.

Nehmen wir einen Hinweis von einer berühmten Punkrock-Band aus der Vergangenheit. Wie FLAC. Es ist ein so moderner verlustfreier Kompressionsstandard, dass es WAV erfolgreich ersetzt hat. Weil es kostenlos ist.

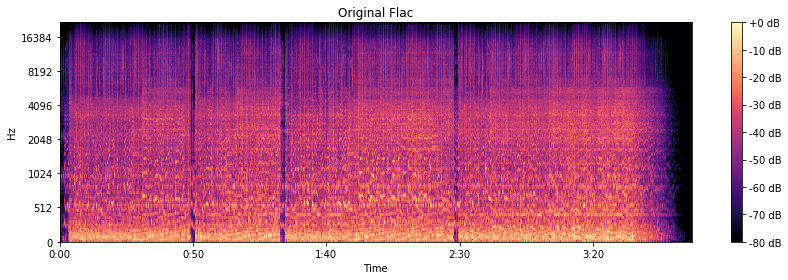
Das Original ist in CD-Qualität, sodass erwartungsgemäß Frequenzen bis zu 22 kHz vorhanden sind.

Original flac

Wir werden mit FFmpeg oder besser gesagt mit LAME ernten.

Mit 320 kbps und 256 kbps sieht das Spektrogramm fast wie das Original aus.

Bei 192 kbps gibt es Anzeichen für eine 16-kHz-Abschaltung. Das Spektrogramm “verdunkelt” sich anscheinend, das psychoakustische Modell hat etwas herausgeschnitten. Nach Gehör verschwanden die höherfrequenten “Bursts” wirklich.

MP3 192 kbps

Bei den berüchtigten 128 kbit / s ist bei 16 kHz bereits alles speziell abgeschaltet. Hintergrundgeräusche sind “unscharf” und beginnen zu sprudeln. Nichts mit dem Original zu tun, um die musikalischen Details zu genießen.

MP3 128 kbps

Aber Sie können 64 kbps in MP3 machen. Die Stereoanlage ist weg. Alles gurgelt furchtbar und irritiert mit völlig seltsamen Geräuschen.


Free Download Mp4Gain
picture

Verlustbehaftete Komprimierung: Komprimieren Sie Audio und Video

Verlustbehaftete Komprimierung: Komprimieren Sie Audio und Video

Lossy cmpression

Hochwertiges digitalisiertes Audio erfordert viel Speicherplatz. Versuche, die Dateigröße mit Standard-Aktenschränken zu reduzieren, führen aufgrund der Spezifität der Audiodaten nicht zu signifikanten Gewinnen. Es ist jedoch möglich, mit speziellen Methoden, die auf der Analyse der Datenstruktur und der anschließenden Komprimierung mit einigen Verlusten basieren, ein ziemlich signifikantes Maß an Komprimierung der Audioinformationen zu erreichen.

Lossy Compression

Die reale Möglichkeit einer Klangverarbeitung, deren Qualität mit den vorhandenen analogen Beispielen vergleichbar ist, trat erst Ende der 1980er Jahre auf. 1988 bildete die Internationale Organisation für Normung (ISO) das MPEG-Komitee (Moving Image Experts Group). , deren Hauptaufgabe es ist, Standards für die Codierung von bewegten Bildern, Ton und deren Kombination zu entwickeln. In den zehn Jahren seines Bestehens hat das Komitee eine Reihe von Normen zu diesem Thema entwickelt. Zusammenfassend wurden mehrere spezifische Formate für die Speicherung von Daten empfohlen, die sich durch hervorragende Qualität der Ergebnisse und Datenfluss auszeichnen.

Derzeit sind MPEG-1, MPEG-2 und MPEG-4 die drei am häufigsten verwendeten Videospeicherstandards. Innerhalb der ersten beiden Formate gibt es auch Formate zum Speichern von Audioinformationen: Layer-1, Layer-2 und Layer-3. Diese drei Audioformate sind für MPEG-1 definiert und kleinere Erweiterungen werden in MPEG-2 verwendet. Die drei Formate ähneln sich, verwenden jedoch unterschiedliche Kompromisse zwischen Komprimierung und Komplexität. Layer-1 ist die einfachste Stufe, erfordert keine signifikanten Komprimierungskosten, bietet aber auch ein vernachlässigbares Komprimierungsverhältnis. Layer-3-Level: Am zeitaufwändigsten und bietet die beste Komprimierung. In letzter Zeit hat dieses Format immense Popularität erlangt. Es wird oft als MP3 bezeichnet. Dieser Name ist mit der Erweiterung der in diesem Format gespeicherten Audiodateien verbunden.

Grundidee, bei der alle Komprimierungsmethoden für Audiosignalverluste – die subtilen Details des Originaltons ignorieren, die außerhalb dessen liegen, was das menschliche Ohr wahrnimmt. Hier können mehrere Punkte hervorgehoben werden.

Geräuschpegel. Die Klangkomprimierung basiert auf einer einfachen Tatsache: Wenn sich eine Person in der Nähe einer lauten Sirene befindet, ist es unwahrscheinlich, dass sie die Konversation der Personen in der Nähe hört. Dies geschieht auch nicht, weil eine Person einem lauten Geräusch große Aufmerksamkeit schenkt, sondern in größerem Maße, weil das menschliche Ohr tatsächlich Geräusche übersieht, die im gleichen Frequenzbereich wie ein lauteres Geräusch liegen. Dieser Effekt wird als Maskierung bezeichnet und ändert sich mit dem Unterschied in Lautstärke und Frequenz des Klangs.

Der zweite Punkt ist die Aufteilung des Audiofrequenzbandes in Teilbänder, von denen jedes separat weiterverarbeitet wird. Das Codierungsprogramm extrahiert die lautesten Töne in jedem Band und verwendet diese Informationen, um einen akzeptablen Rauschpegel für dieses Band zu bestimmen. Die besten Codierungsprogramme berücksichtigen auch den Einfluss benachbarter Bänder. Ein sehr lauter Ton in einem Band kann den Maskierungseffekt und benachbarte Bänder beeinflussen.

Ein weiterer Punkt der Kodifizierung ist die Verwendung eines psychoakustischen Modells, das auf den Besonderheiten der menschlichen Wahrnehmung von Schall basiert. Komprimierung Die Verwendung dieses Modells basiert auf der Entfernung offensichtlich unhörbarer Frequenzen unter sorgfältigerer Erhaltung von Geräuschen, die vom menschlichen Ohr klar unterschieden werden können. Leider kann es hier keine genauen mathematischen Formeln geben. Die menschliche Wahrnehmung von Geräuschen ist ein komplexer Prozess, der nicht vollständig verstanden wird. Daher basiert die Auswahl der Komprimierungsmethoden auf der Analyse des Hörens und dem unterschiedlichen Vergleich komprimierter Geräusche durch Expertenteams. Hier gibt es jedoch praktisch unbegrenzte Möglichkeiten, psychoakustische Modelle zu verbessern. Die meisten der vorhandenen Algorithmen zum Codieren der menschlichen Stimme basieren auf der hohen Vorhersagbarkeit des Signals; Universelle MPEG-Komprimierungsalgorithmen haben versucht, diese Technik mit variablem Erfolg anzuwenden.

Eine weitere Komprimierungstechnik ist die Verwendung von sogenanntem Joint Stereo. Es ist bekannt, dass das menschliche Hörgerät nur die Richtung der Mittenfrequenzen, des hohen und des niedrigen Tons sozusagen getrennt von der Quelle bestimmen kann. Dies bedeutet, dass diese Hintergrundfrequenzen in ein Monosignal codiert werden können. Darüber hinaus nutzt die Komprimierung den Unterschied in der Komplexität der Flüsse in den Kanälen. Wenn beispielsweise für einige Zeit auf dem rechten Kanal völlige Stille herrscht, wird dieser “reservierte” Ort verwendet, um die Qualität des linken Kanals zu verbessern.