Die Vorteile von digitalem Audio


Free Download Mp4Gain
picture

Die Vorteile von digitalem Audio

DIGITAL AUDIO

Die Grundlagen von “Zahlen”

Digital Audio

Jedes der heute angebotenen Multimedia-Geräte, sei es ein CD-Player, ein Diktiergerät oder ein Flash-Speicher-Player, verwendet viele verschiedene Arten der Darstellung von Datenströmen, die dann in Sound umgewandelt werden. Und es wurden noch mehr Klangformate erfunden, die für professionelle Zwecke verwendet werden. Ein unerfahrener Käufer ist gezwungen, Informationen über Bezeichnungen auf Boxen und Geräten aus verschiedenen Quellen zu sammeln, wobei er häufig falsche Informationen oder noch mehr Verwirrung erhält.

Fast alle Geräte im Abschnitt “Portable Audio” des ZOOM.CNews.ru-Katalogs unterstützen mehrere Soundformate gleichzeitig, und viele Geräte, die nicht zu dieser Kategorie gehören, sind auch mit der Unterstützung für die Wiedergabe von Sounddateien gekennzeichnet. Um unseren Lesern zu helfen, haben wir beschlossen, ein kurzes Glossar mit Abkürzungen zu erstellen und über die gängigsten Formate zu sprechen. Wir planen, es für Aktualisierungen und Änderungen offen zu lassen, neue Formate hinzuzufügen und die Vor- und Nachteile der bereits üblichen oder vergessenen Formate detaillierter zu beschreiben.

Eine kleine Theorie

Denken Sie zunächst daran, dass digitaler Sound nichts anderes als eine Sammlung von Zahlen ist. Der bestimmende Faktor ist das System, mit dem Schall als Luftdruck in Datenströme umgewandelt und zur weiteren Verarbeitung und Wiedergabe codiert wird. Folglich ist digitaler Sound normalerweise in Computerdateien mit verschiedenen Erweiterungen enthalten, die häufiger (aber nicht immer) ihr Format bestimmen können. Und dasselbe Formatkonzept kann paradoxerweise zwei Bedeutungen haben. Erstens kann das Format als allgemeines Merkmal vorliegen, einschließlich sowohl des Typs als auch der physikalischen Eigenschaften des Mediums (Platte oder Kassette), des Aufzeichnungsverfahrens, der Codierungsprinzipien und des Schutzes vor Fehlern. Zweitens kann das Format nur als das Verfahren zum Codieren und Komprimieren von Ton verstanden werden, da Standardmedien für die Übertragung verwendet werden, beispielsweise ein Computer.

Analoger Ton wird im Gegensatz zu digitalem auf analogen Geräten wiedergegeben und weist eine Reihe signifikanter Unterschiede auf. Analoges Audio ist zwar kein Datenstrom, wird jedoch als kontinuierliches elektrisches Signal dargestellt, das eine Änderung der Schallwelle darstellt. Um es in ein digitales Format zu übersetzen, wird der Ton “digitalisiert”, dh er wird in bestimmte Segmente unterteilt, in denen der numerische Wert der Amplitude zu diesem Zeitpunkt festgelegt ist. Wir werden uns nicht mit den Prinzipien der digitalen Klangerzeugung befassen, aber es ist unbedingt zu beachten, dass das Klangbild selbst umso klarer und vollständiger erzeugt wird, je öfter ein Tonsegment geteilt und seine Eigenschaften beschrieben werden.

Dieser Prozess erzeugt einen enormen Datenfluss, der den Ton beschreibt, und es ist klar, dass jedes digitale Audioformat nichts anderes als ein Kompromiss zwischen der Notwendigkeit, den Ton so laut wie möglich darzustellen, und den Einschränkungen des Speichers des Computers oder Geräts ist. Der Reproduktion.

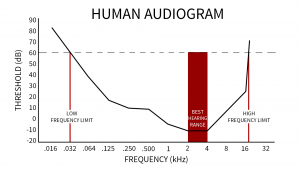
Ein bisschen mehr Theorie. In den meisten Fällen nimmt das menschliche Ohr Schall mit einer Frequenz von nicht mehr als 22.000 Hz wahr. Um ihn vollständig in digitaler Form zu beschreiben, ist eine Abtastfrequenz von mindestens 44,1 kHz erforderlich. Da es absolut unmöglich ist, den Wert des Signals zu einem bestimmten Zeitpunkt zu bestimmen, erfolgt während der Digitalisierung eine Quantisierung, dh das Ersetzen der tatsächlichen Werte des Signals durch ungefähre Werte. Je mehr Audioquantisierungspegel vorhanden sind, desto genauer wird der Signalpegel beschrieben. Infolgedessen trägt jede Standard-CD ein Audiosignal mit einer Abtastfrequenz von 44,1 kHz und einem 16-Bit-Quantisierungspegel.

Die Vorteile von digitalem Audio

Und nun kurz, warum dieser Algorithmus entwickelt wurde. Digitaler Sound hat enorme Vorteile gegenüber analogem, obwohl wir seine gewissen Nachteile nicht vergessen dürfen. Der Hauptwert des digitalen Klangs ist die Möglichkeit einer unendlich langen Speicherung und endlosen Wiedergabe von Material, ohne die ursprüngliche Qualität zu verlieren, während der analoge Klang bei jeder erneuten Aufnahme an Qualität verliert. Darüber hinaus wird die Übertragung von Ton und seine Verarbeitung mit modernen digitalen Mitteln vor allem durch spezialisierte Computer erleichtert. Darüber hinaus ist das digitale Signal auf Übertragungsleitungen störungsresistenter als das analoge Signal. Es ist auch wichtig, dass digitale Technologie,

In der Vergangenheit war digitaler Sound zweifellos die Initiative von Ingenieuren des Unternehmens, die von Philips entwickelte Audio-CDs, auch CDDA – Compact Disk Digital Audio genannt, übernommen haben.


Free Download Mp4Gain
picture

Digitale Audiokodierung

Digitale Audiokodierung

Digital audio encoding

Tatsächlich ist diese oder jene digitale Form der Darstellung von analogen Audiosignalen bereits ein Codierungsverfahren. – Eine Zahlenfolge, die ein analoges Audiosignal beschreibt, ist selbst ein digitaler Code.

Digitl Audio Encoding

Die Kodierung, über die wir jetzt sprechen werden, ist jedoch etwas anderes. Schauen wir uns nun die Methoden zum Codieren digitaler Audiosignale an.
Ein digitalisiertes Audiosignal “in seiner reinen Form” (zum Beispiel in Form einer der oben diskutierten PCM-Variationen) ist eine ziemlich genaue, aber nicht die kompakteste Art, das ursprüngliche analoge Signal aufzuzeichnen.

Urteile selbst. Um vollständige Informationen über das ursprüngliche analoge Signal im Frequenzbereich 0-20 kHz (im hörbaren Frequenzbereich) zu erhalten, muss das analoge Signal mit einer Frequenz von mindestens 40 kHz abgetastet werden. Der CD-DA-Standard (der Standard für die Aufzeichnung von Daten auf Audio-CDs, die allen bekannt sind) legt daher die folgenden Codierungsparameter fest: Aufzeichnung von zwei oder einem Kanal im PCM-Format mit einer Abtastfrequenz von 44,1 kHz und einer Tiefe 16-Bit-Quantisierungsbits. Eine Stunde Musik in diesem Format benötigt ungefähr 600 MB (60 Minuten * 60 Sekunden * 2 Kanäle * 44100 Samples pro Sekunde * 2 Bytes pro Sample = ungefähr 605 MB). Wenn man bedenkt, dass beispielsweise die Musiksammlung eines gewöhnlichen Musikliebhabers 5000 Titel mit einer durchschnittlichen Länge von jeweils etwa 3 Minuten enthält, ist die Menge an Speicher, die erforderlich ist, um sie in ihrer ursprünglichen digitalen Form zu speichern, sehr beeindruckend. . Daher erfordert das Speichern relativ großer Mengen von Audiodaten, um eine ziemlich gute Klangqualität sicherzustellen, die Verwendung verschiedener “Tricks”, um die Daten zu komprimieren.

Im Allgemeinen können alle vorhandenen Methoden zum Codieren von Audioinformationen bedingt in nur zwei Typen unterteilt werden.

1. Verlustfreie Datenkomprimierung (“Verlustfreie Codierung”) ist eine Methode zum Codieren (Komprimieren) digitaler Audioinformationen, die eine hundertprozentige Wiederherstellung der Originaldaten aus dem komprimierten Stream ermöglicht (der Begriff “Daten”) Original “bedeutet hier die Originalform der digitalisierten Audiodaten). Diese Methode der Datenkomprimierung wird in Fällen verwendet, in denen eine hundertprozentige absolute Erhaltung der Qualität der ursprünglichen Audiodaten erforderlich ist. Die heute existierenden verlustfreien Komprimierungsalgorithmen können das Datenvolumen um 20-50% reduzieren und gleichzeitig eine 100% ige Wiederherstellung des ursprünglichen digitalen Materials aus den komprimierten Daten gewährleisten. Die Betriebsmechanismen solcher Codierer ähneln den Betriebsmechanismen allgemeiner Datenarchivierer wie ZIP oder RAR, sind jedoch gleichzeitig speziell für die Komprimierung von Audiodaten geeignet. Verlustfreie Codierung Es ist zwar ideal, um die Qualität von Audiomaterial zu erhalten, kann jedoch kein hohes Maß an Komprimierung bieten.

2. Es gibt eine andere modernere Form der Datenkomprimierung. Diese sogenannte verlustbehaftete Datenkomprimierung (engl. “Lossy Coding”) Der Zweck der Codierung besteht darin, mit allen Mitteln die höchste Datenkomprimierungsrate zu erzielen und gleichzeitig die Klangqualität auf einem akzeptablen Niveau zu halten. Die Idee hinter verlustbehafteter Codierung basiert auf zwei einfachen Überlegungen:

Die ursprünglichen digitalen Audiodaten sind redundant: Sie enthalten viele unnötige Informationen, die für das Ohr unbrauchbar sind und entfernt werden können, wodurch das Komprimierungsverhältnis erhöht wird.
Die Anforderungen an die Klangqualität von Audiomaterial können variieren und hängen von bestimmten Zwecken und Anwendungsbereichen ab.
Eine verlustbehaftete Codierung wird daher als “verlustbehaftet” bezeichnet, was zum Verlust einiger Audioinformationen führt. Eine solche Codierung führt dazu, dass das decodierte Signal bei seiner Wiedergabe ähnlich wie das Original klingt, in Wirklichkeit jedoch nicht mehr mit diesem identisch ist. Die meisten verlustbehafteten Codierungsmethoden beruhen auf der Verwendung psychoakustischer Eigenschaften des menschlichen Hörsystems sowie auf verschiedenen Tricks, die mit dem Resampling und Resampling des Signals verbunden sind. In der Frequenz analysiert der Encoder während des Komprimierungsprozesses die Audiodaten, um verschiedene Details des Sounds zu identifizieren, die ignoriert werden können. Verdeckte Frequenzen, unhörbare und unhörbare Klangdetails können für ein höheres Kompressionsverhältnis geopfert werden. Dort, wo nur die Verständlichkeit für den Ton wichtig ist (zum Beispiel bei der Telefonie, wo das Vorhandensein von Frequenzen über 4 kHz nicht erforderlich ist), werden die Audioinformationen im Codierungsprozess ernsthaft “vereinfacht”.