Was ist digitales Audio?


Free Download Mp4Gain
picture

Was ist digitales Audio?

digital audio

Digitales Audio ist eine numerische Darstellung von Ton.

Digital Audio

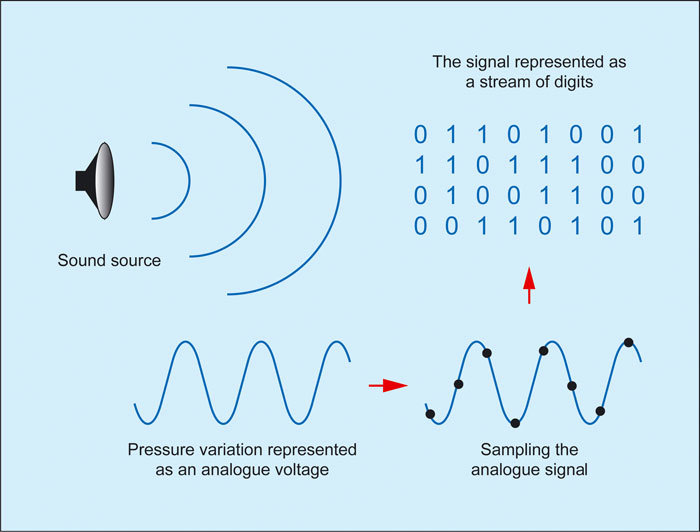
Das Aufnehmen von Ton als digitaler Ton ähnelt dem Aufnehmen von Ton auf einem Kassettenrekorder. Angenommen, Sie haben ein Mikrofon an Ihren Computer angeschlossen. Immer wenn ein Ton zu hören ist (Sprechen, Singen, Spielen eines Musikinstruments oder irgendein Geräusch), “hört” das Mikrofon ihn und wandelt den Ton in ein elektrisches Signal um. Das Mikrofon sendet dann das Signal an die Soundkarte des Computers, die das Signal in Zahlen umwandelt. Diese Zahlen werden als Samples bezeichnet.

Eine Soundkarte ist ein Gerät, das in einen Computer eingesetzt wird und es ihm ermöglicht, die elektrischen Signale von jedem Soundgerät zu verstehen. Sie können sich eine Soundkarte als “Übersetzer” vorstellen. Wenn ein Audiogerät (z. B. ein Mikrofon, ein elektronisches Musikinstrument, ein CD-Player oder ein anderes Gerät, das ein Audiosignal ausgeben kann) Signale an den Computer sendet, empfängt die Soundkarte die Signale und wandelt sie in Zahlen um, die Computer kann verstehen.

Die Beispiele enthalten Informationen, die dem Computer mitteilen, wie das aufgezeichnete Signal zu bestimmten Zeiten klang. Je mehr Abtastwerte zur Darstellung des Signals verwendet werden, desto höher ist die Qualität des aufgezeichneten Signals. Um beispielsweise eine digitale Tonaufnahme mit der gleichen Qualität wie eine CD-Aufnahme zu erstellen, muss der Computer 44.100 Samples pro Sekunde empfangen. Die Anzahl der pro Sekunde entnommenen Proben wird als Abtastrate bezeichnet.

Die Größe jedes einzelnen Samples beeinflusst auch die Qualität des aufgenommenen Klangs. Diese Größe wird als Bittiefe bezeichnet. Je höher die Bittiefe, desto höher die Klangqualität. Um beispielsweise digitales Audio in CD-Qualität zu erstellen, muss jedes Sample 16-Bit sein.

Computer verwenden die Binärform, um Zahlen darzustellen. Die Stelle einer Binärzahl wird als Bit bezeichnet. Jedes Bit repräsentiert eine von zwei Zahlen: 1 oder 0. Durch Kombinieren von Bits können Computer eine beliebige Zahl anzeigen. Beispielsweise wird jede Zahl zwischen 0 und 255 als Acht-Bit-Zahl dargestellt. Mit 16 Bit kann es Zahlen im Bereich von 0 bis 65.535 darstellen.

Ihr Computer kann alle eingereichten Muster speichern. Die zeitlichen Eigenschaften der Probe werden ebenfalls gespeichert. Später kann der Computer in denselben Intervallen Samples an die Soundkarte senden, sodass Sie den Sound genau so hören, wie er aufgenommen wurde. Das Grundkonzept lautet wie folgt: Eine Soundkarte zeichnet ein elektrisches Signal von einem Audiogerät (z. B. einem Mikrofon oder einem CD-Player) auf. Die Soundkarte wandelt die Signale in Zahlenreihen um, die als Samples bezeichnet werden und auf Ihrem Computer gespeichert sind. Während der Wiedergabe werden die Samples an die Soundkarte zurückgesendet, die sie in ein elektrisches Signal umwandelt. Das Signal wird an Ihre Lautsprecher (oder ein anderes Audiogerät) gesendet und Sie hören den Ton genau so, wie Sie ihn aufgenommen haben.

Was ist der Unterschied?
Nachdem Sie die Beschreibung von MIDI und digitalem Audio gelesen haben, sind Sie möglicherweise immer noch verwirrt über den Unterschied zwischen beiden. Immerhin zeichnen beide Prozesse die an den Computer gesendeten Signale auf und reproduzieren sie dann, oder? Der Punkt ist, wenn Sie MIDI-Daten aufnehmen, nehmen Sie keinen tatsächlichen Ton auf. Notieren Sie einfach die Anweisungen für die Wiedergabe. Es ist wie bei einem Musiker, der Noten spielt, wobei die Noten MIDI-Daten sind und der Musiker der Computer. Der Musiker (oder Computer) liest die Noten (oder MIDI-Daten) und speichert sie dann im Speicher. Der Musiker spielt dann eine Melodie auf einem Musikinstrument. Was ist, wenn der Musiker ein anderes Instrument zum Spielen nimmt? Das Spiel bleibt gleich, aber der Sound ändert sich. Gleiches gilt für MIDI-Daten.

Ein Keyboard-Synthesizer kann jeden Sound erzeugen, aber die Wiedergabe derselben MIDI-Daten mit dem Keyboard ist genau gleich.

Wenn Sie digitales Audio aufnehmen, nehmen Sie echtes Audio auf. Wenn Sie eine Aufführung eines Musikstücks als digitalen Ton aufnehmen, können Sie den Klang dieser Aufführung nicht wie oben beschrieben ändern. Aufgrund dieser Unterschiede haben MIDI und digitaler Sound ihre eigenen Vor- und Nachteile. Da MIDI als Daten für die Wiedergabe und nicht als tatsächlicher Ton aufgezeichnet wird, haben Sie viel mehr Freiheit, den Ton zu manipulieren als mit digitalem Ton. Sie können den Fehler beispielsweise leicht korrigieren, indem Sie die Tonhöhe ändern. MIDI-Daten können in Standard-Musiknotation konvertiert werden, was mit digitalem Sound nicht möglich ist.


Free Download Mp4Gain
picture

Ist das digitale Signal während der Übertragung und Speicherung verzerrt?

Ist das digitale Signal während der Übertragung und Speicherung verzerrt?

DIGITAL AUDIO

Da jedes digitale Signal als reale elektrische Spannungs- oder Stromkurve dargestellt wird, wird seine Form während einer Übertragung auf die eine oder andere Weise verzerrt, und ein zur Speicherung “eingefrorenes” Signal (Signalogramm) unterliegt aus physikalischen Gründen einer Verschlechterung. verbreitet.

Digital Audio

Alle diese Einflüsse auf die Form des Trägersignals sind Interferenzen, die bis zu einem bestimmten Wert den Informationsgehalt des Signals nicht verändern, da individuelle Verzerrungen und Buchstabenverluste in Wörtern das korrekte Verständnis von Wörtern im Allgemeinen nicht beeinträchtigen. Wörter und Informationsredundanz, wie z. B. eine Erhöhung der Länge der Wörter, erhöhen die Wahrscheinlichkeit einer erfolgreichen Erkennung. … Mit anderen Worten, das Trägersignal selbst kann verzerrt sein, aber die darin enthaltenen Informationen, das codierte Audiosignal, bleiben in den allermeisten Fällen unverändert.

Damit sich die Qualität des Trägersignals nicht verschlechtert, muss jede Übertragung nützlicher Audioinformationen (Kopieren, Schreiben auf einen Träger und Lesen) notwendigerweise den Vorgang des Wiederherstellens der Form des Trägersignals und im Idealfall der digitalen Form umfassen Primär des Informationssignals, und erst danach kann das neu erzeugte Trägersignal an den nächsten Verbraucher übertragen werden. Bei einer direkten Kopie ohne Wiederherstellung (z. B. einfaches Umschreiben einer Videokassette mit einem digitalen Signal, das mit einem PCM-Decoder in herkömmlichen Videorecordern erhalten wurde) verschlechtert sich die Qualität des digitalen Signals, obwohl es immer noch alle darin enthaltenen Informationen enthält. Nach wiederholten aufeinanderfolgenden Kopien oder Langzeitspeicherung verschlechtert sich die Qualität jedoch so sehr, dass nicht behebbare Fehler auftreten, die die vom Signal übertragenen Informationen irreversibel verzerren. Daher sollte das Kopieren und Übertragen digitaler Signale nur auf digitalen Geräten erfolgen und, wenn sie auf Medien gespeichert sind, rechtzeitig “aktualisiert” werden, ohne auf eine irreversible Verschlechterung zu warten (für magnetische Medien wird dieser Zeitraum auf mehrere Jahre geschätzt ). Ein ordnungsgemäß übertragenes oder aktualisiertes digitales Signallogramm verliert nicht an Qualität und kann kopiert werden und für immer in absolut unveränderter Form existieren. ohne auf einen irreversiblen Abbau zu warten (für magnetische Träger wird dieser Zeitraum auf mehrere Jahre geschätzt). Ein ordnungsgemäß übertragenes oder aktualisiertes digitales Signallogramm verliert nicht an Qualität und kann kopiert werden und für immer in absolut unveränderter Form existieren. ohne auf einen irreversiblen Abbau zu warten (für magnetische Träger wird dieser Zeitraum auf mehrere Jahre geschätzt). Ein ordnungsgemäß übertragenes oder aktualisiertes digitales Signallogramm verliert nicht an Qualität und kann kopiert werden und für immer in absolut unveränderter Form existieren.

Es sollte jedoch nicht vergessen werden, dass die Richtigkeit eines Codes endlich ist und die tatsächlichen Träger bei weitem nicht ideal sind. Daher ist das Auftreten nicht behebbarer Fehler eine so seltene Sache, insbesondere bei unachtsamer Handhabung des Trägers. Beim Lesen neuer und korrekt gespeicherter DAT-Kassetten oder -CDs auf hochwertigen und zuverlässigen Geräten treten diese Fehler praktisch nicht auf. Bei Alterung, Verunreinigung und Beschädigung von Medien und Lesesystemen treten sie jedoch häufiger auf. Ein einzelner unkorrigierter Fehler ist aufgrund der Interpolation für das Ohr fast immer unsichtbar, führt jedoch zu einer Verzerrung des ursprünglichen Tonsignals, und die Anhäufung solcher Fehler im Laufe der Zeit ist im Ohr zu spüren.

Ein weiteres Problem ist die Schwierigkeit, nicht korrigierte Fehler aufzuzeichnen und die Identität des Originals und der Kopie zu überprüfen. Sehr oft kümmern sich Entwickler von digitalen Audiogeräten, die in Echtzeit arbeiten, nicht um die Frage der genauen Überprüfung der Zuverlässigkeit der Übertragung, da die Maßnahmen zur Korrektur der Fehler ausreichend sind. Im allgemeinen Fall führt die Unmöglichkeit der erneuten Übertragung eines fehlerhaften Samples oder Blocks zu einer geheimen Interpolation, und nach dem Kopieren kann nicht mit Sicherheit gesagt werden, ob das ursprüngliche Signal genau kopiert wurde. Fehleranzeigen, die auf einigen Geräten zu finden sind, leuchten normalerweise nur zum Zeitpunkt ihres Auftretens auf, und bei einzelnen Fehlern kann ihre Funktion leicht unbemerkt bleiben. Selbst in PC-basierten Systemen ist es oft unmöglich, die Empfangsgenauigkeit über eine digitale Schnittstelle oder das direkte Lesen von einer CD zu steuern. Der einzige Ausweg besteht darin, den Vorgang zu wiederholen und die Ergebnisse zu vergleichen.

Was sind die Vor- und Nachteile von digitalem Audio?

Was sind die Vor- und Nachteile von digitalem Audio?

Digital Audio

Die digitale Darstellung von Ton ist vor allem für die Möglichkeit der endlosen Speicherung und Wiedergabe ohne Qualitätsverlust wertvoll; Die Umstellung von analog auf digital und umgekehrt führt jedoch zwangsläufig zu einem teilweisen Verlust.

digital audio

Die unangenehmsten Verzerrungen, die in der Digitalisierungsstufe eingeführt werden, sind das granulare Rauschen, das auftritt, wenn das Signal aufgrund der Rundung der Amplitude auf den nächsten diskreten Wert durch den Pegel quantisiert wird. Im Gegensatz zu einfachem Breitbandrauschen, das durch Quantisierungsfehler verursacht wird, ist granulares Rauschen die harmonische Verzerrung des Signals, die im oberen Teil des Spektrums am deutlichsten erkennbar ist.

Die Leistung des körnigen Rauschens ist umgekehrt proportional zur Anzahl der Quantisierungsschritte; Aufgrund der logarithmischen Charakteristik des Hörens mit linearer Quantisierung (konstanter Schrittwert) haben leise Töne weniger Quantisierungsschritte als laute Töne, und infolgedessen fällt die Hauptdichte nichtlinearer Verzerrungen in den Bereich der Töne. Leise. Dies führt zu einer Begrenzung des Dynamikbereichs, die idealerweise (ohne Berücksichtigung der harmonischen Verzerrung) dem Signal-Rausch-Verhältnis entspricht. Die Notwendigkeit, diese Verzerrung zu begrenzen, verringert jedoch den Dynamikbereich für die 16-Bit-Codierung auf 50-60 dB. Die Situation hätte durch logarithmische Quantifizierung gerettet werden können, aber ihre Implementierung in Echtzeit ist sehr schwierig und teuer.

Die durch granulares Rauschen verursachte Verzerrung kann verringert werden, indem dem Signal normales weißes Rauschen (zufälliges oder pseudozufälliges Signal) mit einer Amplitude von der Hälfte des niedrigstwertigen Bits hinzugefügt wird; Eine solche Operation wird Dithering genannt. Dies führt zu einem leichten Anstieg des Rauschpegels, schwächt jedoch die Korrelation von Quantisierungsfehlern mit den Komponenten des Hochfrequenzsignals und verbessert die subjektive Wahrnehmung. Anti-Aliasing wird auch angewendet, bevor die Samples durch Verringern ihrer Bittiefe gerundet werden. Dithering und Rauschformung sind im Wesentlichen Sonderfälle derselben Technologie, mit dem Unterschied, dass im ersten Fall weißes Rauschen mit einem flachen Spektrum und im zweiten Fall Rauschen mit einem Spektrum mit einer “Form” verwendet wird “Besondere.

Beim Wiederherstellen von Audio von digital auf analog besteht das Problem, die gestufte Wellenform zu glätten und die durch die Abtastrate eingeführten Harmonischen zu unterdrücken. Aufgrund der Unvollkommenheit des Frequenzgangs der Filter kann eine unzureichende Unterdrückung dieser Störung oder eine übermäßige Dämpfung nützlicher Hochfrequenzkomponenten auftreten. Schlecht unterdrückte Oberwellen der Abtastrate verzerren die Form des analogen Signals (insbesondere im Hochfrequenzbereich), was zu einem “rauen” und “schmutzigen” Klang führt.

MP3- und Audio-Digitalisierung.

MP3- und Audio-Digitalisi
erung.

Die ganze Menschheit hat sich an alltägliche Dinge wie das Aufnehmen und Wiedergeben von Ton gewöhnt, sei es ein Diktiergerät, ein Anrufbeantworter oder Musikaufnahmen ihrer Lieblingskünstler. Und Menschen, die die meiste Zeit in der Nähe des Computers verbringen, können sich ein Leben ohne Ton wahrscheinlich nicht vorstellen. Dieser Artikel konzentriert sich auf ein allgemeines Codierungsformat wie MP3.

Nun, Thomas Alva Edison begann mit der Aufnahme, als er die Worte “Mary hatte ein Lamm” auf seiner “Talking Machine” rief. Die “sprechende Maschine” war das weltweit erste Gerät, das Ton aufzeichnete und wiedergab: ein Phonograph, der einen Soundtrack mechanisch auf einer Wachswalze aufzeichnete. Zu dieser Zeit war dies sicherlich ein großer Fortschritt, wie zu dieser Zeit, und dies war im Jahr 1877, als niemand auf die Idee kam, etwas Ähnliches zu schaffen.

Der größte Nachteil dieses Tonträgers war jedoch die Fragilität der Aufnahme. Mit der Entwicklung von Wissenschaft und Technologie lernten die Menschen, Ton nicht nur mechanisch wie Edison, sondern auch elektromechanisch und fotoelektrisch aufzunehmen, und mit dem Aufkommen von Computern wurde es möglich, Ton in digitaler Form aufzunehmen. Der Hauptvorteil dieser Aufnahmemethode ist die Beibehaltung der Klangqualität, unabhängig davon, wie oft sie abgespielt oder neu geschrieben wurde. Da digitale Informationen auf einem Computer verarbeitet werden können, eröffnete sich eine Vielzahl von Möglichkeiten für die Arbeit mit Ton. . Da die Aufnahme einer Komposition in der frühen Phase der Entwicklung des digitalen Klangs viel Speicherplatz kostete und magnetische Medien nur eine geringe Kapazität hatten, begannen Softwareentwickler, diese Tatsache zu verblüffen. wie man viel Musik auf eine kleine Festplatte legt. Dies führte zum Erscheinen verschiedener Programme – Kompressoren, die die Größe der Audiodatei reduzierten. Komprimierungsalgorithmen ermöglichten das Entfernen bestimmter Frequenzen, was zu einem Verlust der Klangqualität führte, und dann stand der Benutzer vor der Wahl, Geld für den Kauf zusätzlicher Megabyte und das Speichern unkomprimierter Musikdateien auszugeben oder Geld zu sparen. und Kompressoren verwenden.

Lassen Sie uns zunächst herausfinden, was “Klang” im wirklichen Leben ist. Die Übertragung von Informationen aus der Ferne mit akustischen Schwingungen ist nur aufgrund der Eigenschaften der akustischen Umgebung möglich, in der dieselben Schallschwingungen auftreten. Sie sind aufgrund des Vorhandenseins elastischer Bindungen zwischen Partikeln im leitenden Medium möglich. Die Schallquelle erzeugt einen Druckbereich durch Komprimieren von Luftmolekülen. Diese Moleküle übertragen ihre Energie auf andere in der Nähe und diese wiederum auf andere usw., was dazu führt, dass Bereiche mit erhöhtem und verringertem Druck im Verhältnis zum Umgebungsdruck auftreten. Dies erzeugt eine Schallwelle, die von Natur aus kontinuierlich ist. Einer der Parameter der Welle ist die Amplitude. Nehmen wir ein einfaches Beispiel: eine Gitarrensaite. Jeder weiß, dass es zur Erhöhung der Lautstärke des Klangs erforderlich ist, die Saite mit mehr Kraft zu ziehen, wodurch die Schwingungsamplitude erhöht wird, was zu einer Erhöhung der Druckabweichung führt. Eine Welle reicht jedoch nicht aus, um einen Schall zu übertragen, der vom menschlichen Ohr wahrgenommen werden kann. Ein weiterer wichtiger Punkt ist die Schwingungsfrequenz, dh die Frequenz, mit der die Schallquelle eine Druckänderung erzeugt, und diese Frequenz bestimmt die Tonhöhe des übertragenen Schalls. Um die Tonhöhe einer Gitarre zu ändern, müssen Sie die Saite an einem bestimmten Bund gedrückt halten, dh die Länge der Saite und folglich die Frequenz ihrer Vibrationen ändern. Ein weiterer wichtiger Punkt ist die Schwingungsfrequenz, dh die Frequenz, mit der die Schallquelle eine Druckänderung erzeugt, und diese Frequenz bestimmt die Tonhöhe des übertragenen Schalls. Um die Tonhöhe einer Gitarre zu ändern, müssen Sie die Saite an einem bestimmten Bund gedrückt halten, dh die Länge der Saite und folglich die Frequenz ihrer Vibrationen ändern. Ein weiterer wichtiger Punkt ist die Schwingungsfrequenz, dh die Frequenz, mit der die Schallquelle eine Druckänderung erzeugt, und diese Frequenz bestimmt die Tonhöhe des übertragenen Schalls. Um die Tonhöhe einer Gitarre zu ändern, müssen Sie die Saite an einem bestimmten Bund gedrückt halten, dh die Länge der Saite und folglich die Frequenz ihrer Vibrationen ändern.

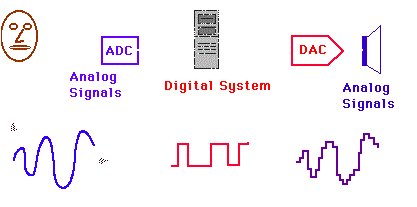
Nachdem wir die Natur des Klangs ein wenig verstanden haben, wechseln wir von analog zu digital. Um “natürlichen” Klang zu digitalisieren, müssen Sie ihn zuerst in ein analoges elektrisches Signal umwandeln. In diesem Fall ist das Analogon der Amplitude der Schallwelle die Amplitude der Spannungsänderung. Wie oben erwähnt, sind die Welle und das analoge elektrische Signal kontinuierliche Funktionen, aber für die Digitalisierung müssen sie in diskreter Form dargestellt werden. Hierzu wird ein ADC (Analog-Digital-Wandler) verwendet, der die kontinuierliche Welle in Abschnitte zerlegt (Sample) und die Amplitude der Welle in diesen Abschnitten als Zahl darstellt, dh quantifiziert. Es ist klar, dass für eine größere Präzision und Reinheit des Klangs die Anzahl der Samples gegen unendlich tendieren und ihre Größe gegen Null gehen muss. Die Anzahl der Abtastungen pro Sekunde wird als Abtastrate oder Abtastrate bezeichnet und in Hz gemessen. Es stellt sich die Frage, welche Abtastrate beim Digitalisieren verwendet werden soll, damit das Ergebnis am natürlichsten ist. Es ist theoretisch bekannt, dass für die genaueste Rekonstruktion eines kontinuierlichen analogen Signals aus diskreten Werten eine Abtastfrequenz verwendet werden muss, die mindestens doppelt so hoch ist wie die Schallfrequenz (Satz von Nyquist). Es ist bekannt, dass das menschliche Ohr Geräusche mit einer Frequenz von 18 bis 20.000 Hz wahrnehmen kann. Daher beträgt die optimale Abtastfrequenz 40 kHz oder mehr. Die häufigsten Abtastfrequenzen sind 44,1 kHz, 48 kHz. Aufgrund der Tatsache, dass Harmonische über 20 kHz auch den Gesamtklang beeinflussen, werden auch Encoder mit Abtastraten von 96 und 192 kHz verwendet. Die Klangqualität hängt auch von der Anzahl der Stellen ab, die zur Aufzeichnung der gemessenen Amplitude verwendet werden. Der Quantisierungsfehler ist umgekehrt proportional zur Bitbreite. Daher wird bei einer 8-Bit-Quantisierung der Schallpegel unter Verwendung von Zahlen im Bereich [-128; 128] mit 16 Bits von [-32768; 32768]. Bei der Aufnahme von Audio-CDs wird beispielsweise eine exakte 16-Bit-Quantisierung verwendet, damit sie eine hohe Klangqualität aufweisen.

Lassen Sie uns eine mittlere Schlussfolgerung ziehen: Der ADC wandelt das analoge Signal in Zahlen um und schreibt sie als Sequenz. Dann kommt Wave, ein Soundformat. Beachten Sie, dass Audio-CDs Ton im gleichen Format aufnehmen. Diese Speichermethode ist jedoch nicht wirtschaftlich. Viele Leute bevorzugen wahrscheinlich eine MP3-Disc, die mehr als 200 Songs enthalten kann, als eine normale CD. Dazu wird die Wave-Datei auf Kosten der Qualität komprimiert. Seien Sie jedoch nicht beunruhigt, da das menschliche Ohr den Verlust der Klangqualität nach der Komprimierung praktisch nicht erkennen kann. Lassen Sie mich jetzt erklären. Alles begann, als die Internationale Organisation für Normung (ISO) Ende der 1980er Jahre die Expertengruppe Moving Pictrures gründete, deren Aufgabe es war, einen internationalen Standard für die Darstellung digitaler Video- und Audiodaten zu entwickeln. Das Ergebnis der Arbeit der Gruppe ist das MPEG-1 Layer 3-Format, kurz MP3, das Audiodaten praktisch ohne Qualitätsverlust um 1/12 komprimiert. Der Audiokomprimierungsalgorithmus in diesem Format basiert auf den psychoakustischen Eigenschaften des menschlichen Hörorgans, und daher hat die Entfernung von Elementen, die vom Ohr nicht wahrgenommen werden, keinen Einfluss auf die spürbare Qualitätsverschlechterung. Angenommen, es befinden sich viele Personen im Raum, die alle lautstark miteinander sprechen. Wenn Sie versuchen, eine Person anzurufen, die nur wenige Meter von Ihnen entfernt ist, ohne Ihre Stimme zu erheben, erwarten Sie nicht, dass sie Ihren Anruf entgegennimmt. , da es Sie aufgrund des erzeugten Geräusches nicht hört. Dies liegt daran, dass Klänge derselben Frequenz mit höherer Amplitude andere Frequenzen mit niedrigerer Amplitude maskieren. Dieser unglückliche Effekt wird jedoch gerne zum Komprimieren von digitalisiertem Audio verwendet. Der Wellenstrom enthält alle Toninformationen, auch maskiert, die für das Ohr nicht hörbar sind. Nach der Komprimierung werden diese Informationen jedoch entfernt, wodurch die Dateigröße verringert wird. Ein weiteres wichtiges Merkmal des zur Kompression verwendeten menschlichen Hörorgans ist die Trägheit. Das Ohr ist, um es vulgär auszudrücken, ein Trägheitsgerät, daher kann eine Person an der Grenze des Unterschieds des Schallpegels vom höchsten zum niedrigsten für eine bestimmte Zeit (~ 100 ms) keinen Schall mit niedrigerer Amplitude hören Daher wird der Ton in diesem Zeitraum möglicherweise nicht gespeichert. Es ist auch möglich, den Schall, der über der Empfindlichkeitsschwelle liegt, nicht zu speichern, dh dessen Schallpegel unter einem bestimmten Wert liegt und daher für eine Person unhörbar ist. Eine weitere interessante Eigenschaft, die zum Codieren verwendet wird (jedoch nicht von ”

Zusammen führt dies zu erheblichen Einsparungen beim von der Audiodatei belegten Speicherplatz. Eine durchschnittliche Musikdatei, die 30-40 MB in “voller” Form belegt, belegt nach dem Codieren in MP3 bereits 3-4 MB, sodass Sie mehr als 11 Stunden Musik auf einer Disc aufnehmen können. Dies ist jedoch nicht die Grenze. Im Jahr 2001 hatte das MP3-Format einen Nachfolger: das MP3Pro-Format. Schöpfer sind Thomson Multimedia und das Fraunhofer-Institut in Deutschland. Eine Besonderheit des neuen verbesserten Formats ist, dass die Dateien im neuen Format bei gleicher Qualität im Vergleich zu normalen MP3s doppelt so viel Speicherplatz beanspruchen. Beispielsweise hat eine MP3Pro-Datei mit einer Klangqualität von 128 kbit / s dieselbe Größe wie eine MP3-Datei mit 64 kbit / s. Ein weiterer Vorteil ist

Mal sehen, wie dies erreicht wird. Das Funktionsprinzip des MP3Pro-Formats ist recht einfach. Beim Codieren wird der Audiostream in zwei Teile unterteilt, zwei Streams. Das erste ist das niederfrequente, das im üblichen MP3-Format codiert ist, wodurch die Formate übrigens abwärtskompatibel werden, da normale Player nur diesen Teil der Datei abspielen. Der zweite Stream ist eine Hochfrequenz, die in dem Teil des MP3-Streams codiert ist, den ältere Player ignorieren. Der neue Decoder kombiniert diese beiden Streams und führt zu einem vollen Klang über das gesamte Frequenzband.
In Bezug auf die Förderung des neuen Formats auf dem Markt hat MP3Pro im Vergleich zu seinem älteren Bruder keine so breite Verbreitung erhalten. Thomson Multimedia bietet eine kostenlose Version des MP3Pro Player / Encoder zum Download von seiner Website an. Die Einschränkungen dieser Version bestehen darin, dass nur 64 kbit / s für die Codierung verfügbar sind. WinAmp-Liebhaber haben ein Plugin zum Abspielen von MP3Pro-Dateien

Natürlich konvergierte das Licht nicht bei MP3, es gibt andere digitale Codierungsformate, aber trotzdem ist es immer noch das beliebteste.