Videokodierung, wie es funktioniert (Teil 2)


Free Download Mp4Gain
picture

Videokodierung, wie es funktioniert (Teil 2)
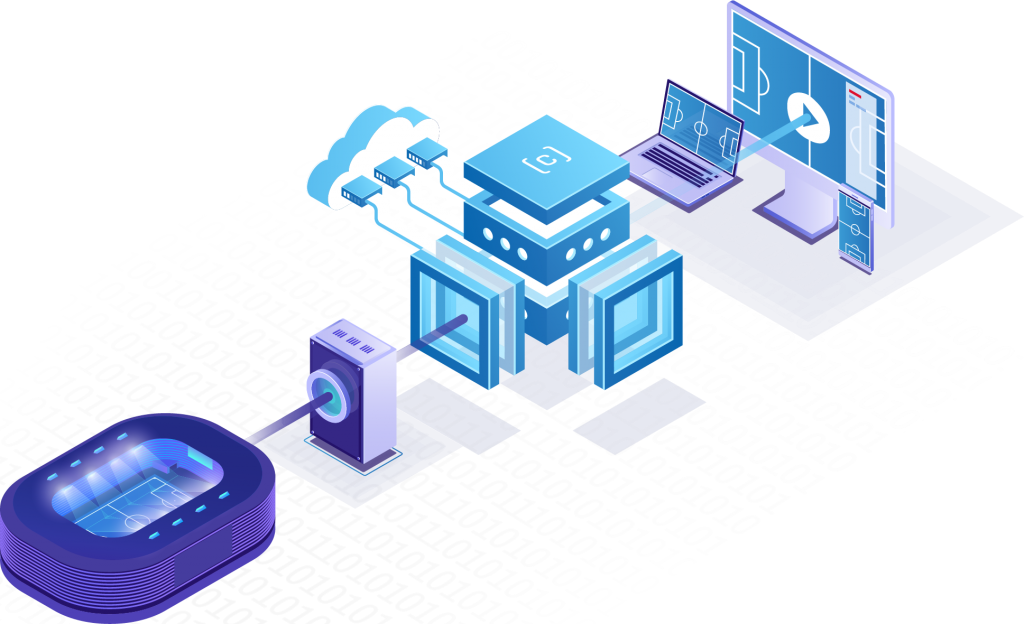
video encoding

Bisher haben wir nur über Bildkomprimierung gesprochen. Ein vollständiges Video beinhaltet jedoch auch eine Audiokomponente. Es wird angenommen, dass Sound in CD-Qualität mit 44,1 kHz und 16 Bit pro Kanal digitalisiert werden muss, was 706 Kbit / s pro Kanal entspricht (1,4 Mbit / s für Stereo). Die Qualität des DAT-Signals bestimmt die Abtastrate von 48 kHz (Frequenzband 4-24000 Hz) und erhöht den Stream auf 768 Kbit / s pro Kanal.

Video Encoding


Der Ansatz der Informationskomprimierung ist der gleiche: Verwerfen des Teils, der für das menschliche Ohr nicht sehr wichtig ist. Der MPEG-Standard ermöglicht 3 Ebenen der Audiokomprimierung. Schicht 1 verwendet den einfachsten Algorithmus mit minimaler Komprimierung, wobei 192 Kbit / s pro Kanal angenommen werden. Der Layer 2-Algorithmus ist komplexer, aber die Komprimierungsrate ist höher und beträgt nur 128 Kbit / s pro Kanal. Ein leistungsstarker digitaler Audiokomprimierungsalgorithmus in CD-Qualität (11-mal verlustfrei vom menschlichen Ohr unterscheidbar) Layer 3 bietet die höchstmögliche Klangqualität bei strengen Übertragungsbeschränkungen – nicht mehr als 64 Kbit / s pro Kanal. Es ist in erster Linie für das Internet gedacht. Seine Bedeutung ist so groß, dass es eine spezielle Abkürzung MP3 erhalten hat, die für MPEG Layer 3 steht. Es gibt viele Internetseiten, die Hunderttausende von MP3-Dateien mit populärer Musik enthalten. Mit Hilfe spezieller Wiedergabeprogramme (Real Audio) kann MP3-Musik in Echtzeit über das Internet angehört, unbegrenzt kopiert (beachten Sie, dass ein typischer Song 2-8 MB groß ist) und illegal verbreitet werden. Es gibt bereits tragbare MP3-Player zum Preis von rund 200 US-Dollar (wie den Diamond Rio). Die Musikindustrie begann mit spürbaren Verlusten einen aktiven Kampf gegen MP3-Sites (die Recording Industry Association of America fand und schloss die meisten von ihnen). Aber der Gin ist raus, man kann nicht jeden schließen. Adaptec prognostiziert, dass in den kommenden Jahren Milliarden von Songs aus dem Internet heruntergeladen werden, und kündigt MP3-Unterstützung in der nächsten Version von EasyCD Creator an. Bei digitalen Bearbeitungsaufgaben wird die Audiosignalkomprimierung jedoch nicht verwendet. Daher ist es bei zulässigen Stream-Berechnungen erforderlich, der Audiokomponente bis zu 1,5 Mbit / s zuzuweisen.

MPEG2 für nichtlineare Bearbeitungsaufgaben

Der Begriff nichtlineare Bearbeitung entspricht nicht dem Wesen des Prozesses, sondern spiegelt nur eine seiner Eigenschaften wider. In der Tat sprechen wir über Videobearbeitung, die in digitalem Format auf Computern durchgeführt wird. In diesem Fall müssen die Originalvideoclips in Form entsprechender Dateien digitalisiert und auf der Festplatte aufgezeichnet werden. Im Gegensatz zu Bandlaufwerken erfordert der Zugriff auf eine dieser fragmentierten Dateien kein langwieriges Zurückspulen (und dieser Vorgang ist linear), sodass alle Videobilder in zufälliger Reihenfolge verfügbar sind. Diese wichtige Eigenschaft führte dazu, dass die digitale Bearbeitung als nichtlinear bezeichnet wurde, obwohl die Möglichkeiten der digitalen Verarbeitung offensichtlich viel breiter und umfangreicher sind.

Denken Sie daran, dass ein Fernsehbild gemäß der Empfehlung ITU-R BT.601 eine 720×576-Matrix ist. Unter Berücksichtigung der Fernsehbildrate von 25 Hz schließen wir, dass eine Sekunde digitales Video in 4: 2: 2-Darstellung 25 x 2 x 720 x 576 = 20.736.000 Byte erfordert, dh der Datenstrom beträgt 21 MBit / s. Das Aufzeichnen dieser Streams ist technisch machbar, aber schwierig, teuer und hinsichtlich der Nachbearbeitung ineffizient. Die tatsächlichen Möglichkeiten der Praxis erfordern eine erhebliche Reduzierung der Flüsse. Es ist bekannt, dass viele Algorithmen eine verlustfreie Komprimierung durchführen, aber selbst die effektivsten bieten bei typischen Bildern nicht mehr als die doppelte Komprimierung.

Bis vor kurzem war M-JPEG in der Welt der nichtlinearen Videobearbeitungssysteme führend. Die verschiedenen Lösungen unterschieden sich im Grad der Komprimierung, was unterschiedlichen Qualitätsstufen des resultierenden Videos entsprach. Unter bestimmten Bedingungen können hier 4 Ebenen unterschieden werden: Standardvideo (VHS, C-VHS, Video8), Supervideo (SVHS, C-SVHS, Hi8), Digitalvideo (Betacam SP, DV / DVCAM / DVCPRO, Mini) -DV, Digital8) und Studio Video (Digital-S, DVCPRO50). Der Einfachheit halber werden wir sie im Folgenden als Video, S-Video, DV und Studio-TV bezeichnen. Quantitativ sind sie im Allgemeinen durch eine horizontale Auflösung gekennzeichnet (die Anzahl der unterscheidbaren Elemente in einer Zeile: Fernsehleitungen). Video bietet eine Auflösung von bis zu 280 Zeilen und entspricht einem MJPEG-Stream von ca. 2 MBit / s.


Free Download Mp4Gain
picture

Videokodierung, wie es funktioniert (Teil 1)

Videokodierung, wie es funktioniert (Teil 1)

video encoding

Die effektive Komprimierung von Videoinformationen basiert auf zwei Hauptideen: der Unterdrückung kleiner Details der räumlichen Verteilung einzelner Frames, die für die visuelle Wahrnehmung unbedeutend sind, und der Beseitigung zeitlicher Redundanz in der Reihenfolge dieser Frames. Folglich sprechen wir von räumlicher und zeitlicher Komprimierung.

Video Encoding

Der erste nutzt die experimentell ermittelte geringe Empfindlichkeit der menschlichen Wahrnehmung gegenüber Verzerrungen kleiner Bilddetails. Das Auge bemerkt einen ungleichmäßigen Hintergrund schneller als die Krümmung einer dünnen Kante oder eine Änderung der Helligkeit und Farbe eines kleinen Bereichs. Aus der Mathematik sind zwei äquivalente Darstellungen des Bildes bekannt: die bekannte räumliche Verteilung von Helligkeit und Farbe und die sogenannte Häufigkeitsverteilung, die mit der räumlichen diskreten Kosinustransformation (DCT) verbunden ist. Theoretisch sind sie äquivalent und reversibel, speichern jedoch Informationen über die Bildstruktur auf völlig unterschiedliche Weise: Die Übertragung glatter Hintergrundänderungen erfolgt durch niederfrequente (Mitten-) Werte der Frequenzverteilung und die hochfrequenten Koeffizienten. Sie sind oft für die feinen Details der räumlichen Verteilung verantwortlich. Dadurch kann der folgende Komprimierungsalgorithmus verwendet werden. Der Rahmen ist in 16×16 Blöcke unterteilt (720×576 entspricht 45×36 Blöcken), von denen jeder im Frequenzbereich in DCT konvertiert wird. Dann werden die entsprechenden Frequenzkoeffizienten quantisiert (Rundung von Werten mit einem gegebenen Intervall). Wenn die DCT selbst nicht zu Datenverlust führt, bewirkt die Quantisierung der Koeffizienten offensichtlich eine Verdickung des Bildes. Die Quantisierungsoperation wird mit einem variablen Intervall durchgeführt: Niederfrequenzinformationen werden genauer übertragen, während viele Hochfrequenzkoeffizienten Nullwerte annehmen. Dies führt zu einer signifikanten Komprimierung des Datenstroms, führt jedoch zu einer Verringerung der effektiven Auflösung und dem möglichen Auftreten kleinerer unechter Details (insbesondere an Blockgrenzen). Offensichtlich

Für aufmerksame Leser wiederholen wir, dass dieser Algorithmus aus der digitalen Fotografie stammt, wo er unter dem Namen JPEG entwickelt wurde, um einzelne Bilder effizient zu komprimieren (JPEG ist eine Abkürzung für den Namen der Joint Photographic Experts Group, die ihn befürwortet hat). Es wurde dann erfolgreich auf Frame-Videosequenzen angewendet (jede vollständig unabhängig verarbeitet) und in MJPEG (Motion-JPEG) umbenannt. Es sollte auch beachtet werden, dass die DV-Codierung der digitalen DV / DVCAM / DVCPRO-Standards im Wesentlichen auf demselben Algorithmus basiert, jedoch ein flexibleres Schema mit adaptiver Auswahl von Quantisierungstabellen verwendet. Das Komprimierungsverhältnis für verschiedene Blöcke variiert im Gegensatz zu MJPEG mit dem Bild: Bei nicht informativen Blöcken (z. B. an den Bildrändern) nimmt es zu und bei Blöcken mit einer großen Anzahl kleiner Details relativ zu die mittlere Ebene des Bildes. Infolgedessen wird bei gleicher Qualität das Datenvolumen um ca. 15% reduziert (oder umgekehrt, bei gleichem Durchfluss ist die Qualität des Ausgangssignals höher).

Bei der zeitlichen MPEG-Komprimierung wird eine hohe Informationsredundanz in Bildern verwendet, die durch kleine Intervalle voneinander getrennt sind. Tatsächlich ändert sich zwischen benachbarten Bildern normalerweise nur ein kleiner Teil der Szene. Zum Beispiel gibt es eine sanfte Bewegung eines kleinen Objekts auf dem Hintergrund eines festen Hintergrunds. In diesem Fall sollten die vollständigen Informationen zur Szene nur selektiv für Referenzbilder gespeichert werden. Im Übrigen reicht es aus, nur Differenzinformationen zu übertragen: über die Position des Objekts, die Richtung und Größe seiner Verschiebung, über neue Hintergrundelemente (die sich hinter dem Objekt öffnen, wenn es sich bewegt). Darüber hinaus können sich diese Unterschiede nicht nur im Vergleich zu den vorherigen, sondern auch zu den späteren Bildern bilden (da sich in ihnen beim Bewegen des Objekts der Teil des Hintergrunds befindet, der zuvor hinter dem Objekt verborgen war). Beachten Sie, dass mathematisch gesehen das schwierigste Element die Suche nach verschobenen Blöcken, aber nur eine geringe Änderung der Struktur (16 x 16) und die Bestimmung der entsprechenden Vektoren ihrer Verschiebung ist. Dieses Element ist jedoch das wichtigste, da es die erforderliche Informationsmenge erheblich reduzieren kann. Es ist die Effizienz der Echtzeitausführung dieses “intelligenten” Elements, die verschiedene MPEG-Codierer auszeichnet.

Was ist Videokodierung?

Was ist Videokodierung?

Video Encoding

Bei der Videokodierung werden digitale Videodateien von einem Format in ein anderes konvertiert. Die Codierung wird auch als “Transcodierung” oder “Videokonvertierung” bezeichnet. Während der Aufnahme stellt das Gerät eine Videodatei in einem bestimmten Format und anderen Spezifikationen bereit. Wenn ein Videobesitzer ein Video veröffentlichen möchte, muss er die verschiedenen Geräte berücksichtigen, auf denen das Video abgespielt werden kann.

Video Encoding

Alle Videos, die wir auf unseren Computern, Tablets und Mobiltelefonen ansehen, haben einen Codierungsprozess durchlaufen, bei dem das Originalvideo so konvertiert wird, dass es in verschiedenen Ausgabeformaten angezeigt werden kann. Dies liegt daran, dass viele Arten von Geräten und Browsern nur bestimmte Videoformate unterstützen. Oft ist es das Ziel eines Video-Editors, die Kompatibilität mit verschiedenen Formaten sicherzustellen.

Digitales Video kann in vielen verschiedenen Formaten mit jeweils bestimmten Variablen wie Videocontainern (.MOV, .FLV, .MP4, .OGG, .WMV, WebM), Codecs (H264, VP6, ProRes) und Bitraten (in Megabit oder Kilobit pro Sekunde). Unterschiedliche Geräte und Browser haben unterschiedliche Spezifikationen, von denen die meisten einer oder mehreren dieser Variablen und anderen Variablen zugeordnet sind.

Beim Codieren eines Videos sollten Sie (a) das ursprüngliche Quellformat und die Videoaufnahmemethode, (b) alle nachfolgenden Codierungsvorgänge, die möglicherweise an der Videoquelle ausgeführt wurden, und (c) die erforderlichen Ausgabeformate berücksichtigen.

Der Container dient zum Speichern verschiedener Datentypen. Dies umfasst Audio, Video und manchmal Untertitel. Sie sind wie die Kisten, in die wir unsere Süßigkeiten legen. Beachten Sie, dass der größte Unterschied zwischen diesen Containern in der Unterstützung der grundlegenden Informationen besteht. Verschiedene Container unterstützen verschiedene Audio- und Videokomprimierungen. Bei einigen können mehrere Audiospuren oder Untertitel eingefügt werden, bei anderen nur eine oder keine. Wenn Sie einer AVI- oder WMV-Datei Untertitel hinzufügen möchten, müssen Sie diese möglicherweise in das Bild brennen. Video- / Audio-Codecs Der tatsächliche Unterschied zwischen den meisten Videodateien hängt weniger vom verwendeten Container als vielmehr vom Video- oder Audio-Codec im Container ab. Der Video-Codec bestimmt, wie die Informationen verarbeitet werden. Einige der beliebtesten Video-Codecs sind DivX / XviD h264 / x264 FFMPEG Theora. Sie müssen bedenken, dass der Inhalt oder die Art und Weise, wie der Inhalt gespeichert wird, nicht immer vom Container bestimmt wird, obwohl er häufig begrenzt ist (z. B. unterstützen einige Container mehrere Streams Audio, während AVI nur eines unterstützt). Infolgedessen stehen verschiedene Kombinationen zwischen Containern und Codecs zur Verfügung.