Audiokomprimierung, wie es funktioniert Teil 4
Andere Unterteilungen von Kompressionsverfahren.
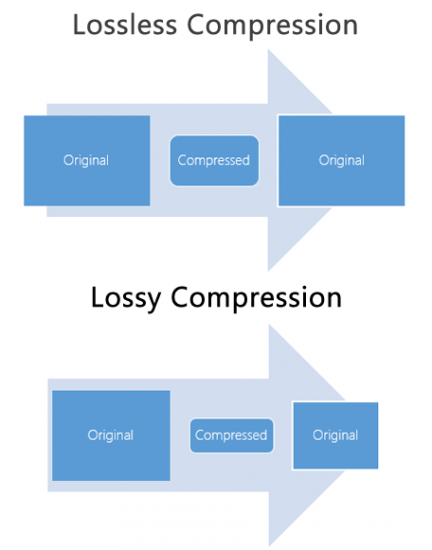
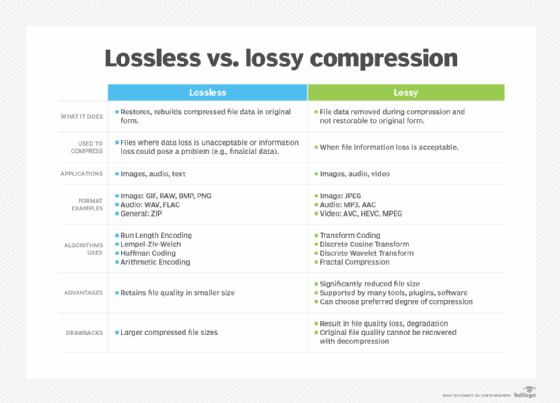
Auf dem Gebiet der Audiokomprimierung gibt es zwei Komprimierungsverfahren, verlustbehaftete Komprimierung und verlustfreie Komprimierung. Häufig gesehene MP3, WMA, OGG werden als verlustbehaftete Komprimierung bezeichnet. Wie der Name schon sagt, reduziert die verlustbehaftete Komprimierung die Audio-Samplerate und Bitrate, und die ausgegebene Audiodatei ist kleiner als die Originaldatei. Eine andere Audiokomprimierung wird als verlustfreie Komprimierung bezeichnet, worüber wir sprechen. Die verlustfreie Komprimierung kann die Lautstärke der Audiodatei unter der Prämisse, 100 % aller Daten in der Originaldatei zu speichern, auf eine kleinere Größe komprimieren, und nach der Wiederherstellung der komprimierten Audiodatei kann sie dieselbe Größe und dieselbe Bitrate wie die Quelle erreichen Datei. Zu den verlustfreien Komprimierungsformaten gehören APE, FLAC, WavPack, LPAC, WMALossless, AppleLossless, La, OptimFROG, Shorten, während gängige und herkömmliche verlustfreie Komprimierungsformate nur APE und FLAC sind. [1]
Hauptklassifikationen und typische Vertreter von Audiokomprimierungsalgorithmen.Streaming bearbeiten
Allgemein können Audiokomprimierungstechniken in zwei Kategorien eingeteilt werden: verlustfreie Komprimierung und verlustbehaftete Komprimierung, und gemäß unterschiedlichen Komprimierungsschemata können sie in Zeitdomänenkomprimierung, Transformationskomprimierung und Zeitdomänenkomprimierung, Teilband sowie unterteilt werden hybride Komprimierung, bei der mehrere Technologien miteinander kombiniert werden. Verschiedene Komprimierungstechniken weisen große Unterschiede in der Algorithmuskomplexität (einschließlich Zeitkomplexität und Raumkomplexität), Audioqualität, Algorithmuseffizienz (dh Komprimierungsverhältnis) und Codec-Verzögerung auf. Auch die Anwendungen verschiedener Komprimierungstechniken sind unterschiedlich.
Zeitbereichskomprimierungstechnologie (oder Wellenformcodierung)
Es verarbeitet direkt die Abtastwerte des Audio-PCM-Codestroms und komprimiert den Codestrom mithilfe von Stilleerkennung, nichtlinearer Quantisierung und Differenz. Gemeinsame Merkmale dieser Art von Komprimierungstechnologie sind eine geringe Algorithmuskomplexität, durchschnittliche Klangqualität, ein kleines Komprimierungsverhältnis (CD-Qualität > 400 kbps) und die kürzeste Codec-Verzögerung (im Vergleich zu anderen Technologien). Diese Art von Komprimierungstechnologie wird im Allgemeinen für Anwendungen mit Sprachkomprimierung und niedriger Bitrate (kleine Quellsignalbandbreite) verwendet. Die Zeitbereichskomprimierungstechnologie umfasst hauptsächlich G.711, ADPCM, LPC, CELP und Blockkomprimierungstechnologie, die auf diesen Technologien entwickelt wurde, wie z. B. NICAM, Subband ADPCM (SB-ADPCM)-Technologie.
Subband-Komprimierungstechnologie
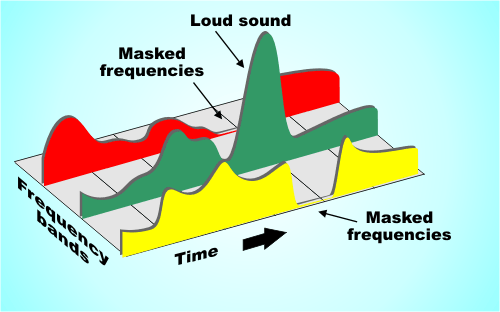
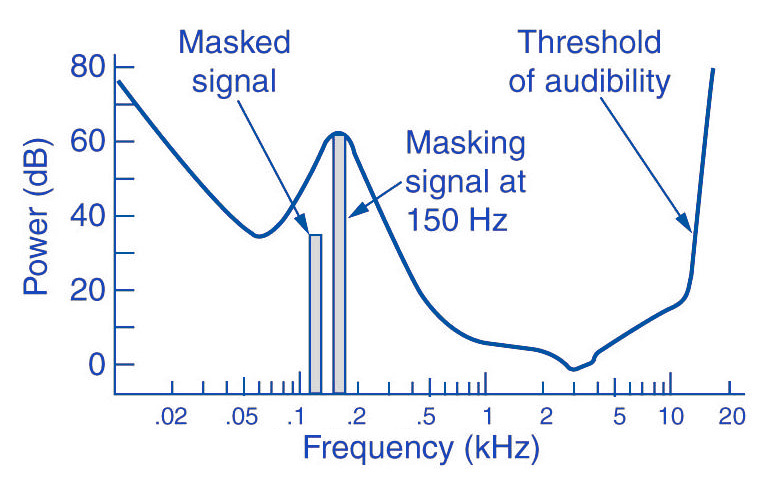
Die Subband-Codierungstheorie wurde erstmals 1976 von Crochiere et al. vorgeschlagen. Die Grundidee besteht darin, das Signal in die Summe der Komponenten in mehrere Subbänder zu zerlegen und dann unterschiedliche Komprimierungsstrategien für jede Subbandkomponente gemäß ihren unterschiedlichen Layoutmerkmalen anzuwenden, um die Coderate zu reduzieren . Die unten beschriebene übliche Teilbandkompressionstechnologie und Transformationskompressionstechnologie basieren auf dem menschlichen Wahrnehmungsmodell (psychoakustisches Modell) des Tonsignals und der Quantisierungsreihenfolge der Teilbandabtastwerte oder der Abtastwerte. Der Frequenzbereich wird durch Analysieren des Spektrums des Signals bestimmt . andere Parameter ausgewählt werden, so dass es auch als wahrnehmungsbezogene Kompressionscodierung (Perceptual) bezeichnet werden kann. Im Vergleich zur Time-Domain-Kompressionstechnik sind diese beiden Kompressionsverfahren deutlich aufwendiger, gleichzeitig wird aber auch die Codiereffizienz und Tonqualität stark verbessert und die Codierverzögerung entsprechend erhöht. Im Allgemeinen ist die Komplexität der Teilbandcodierung etwas geringer als die der Transformationscodierung, und die Codierungsverzögerung ist relativ kurz.
Standardisierung der Audiokomprimierungstechnologie und MPEG-1-Übertragung
Da die digitale Audiokompressionstechnologie ein breites Anwendungsspektrum und gute Marktaussichten hat, scheuen einige Forschungsinstitute und Unternehmen keine Mühe, ihre eigenen proprietären Technologien und Produkte zu entwickeln. Die Standardisierung dieser Audiokompressionstechniken ist sehr wichtig. Ein großer Erfolg bei der Standardisierung der Audiokomprimierung ist MPEG-1 Audio (ISO/IEC11172-3). In MPEG-1 sind drei Modi für die Audiokomprimierung spezifiziert, nämlich Schicht I, Schicht II (dh MUSICAM, auch bekannt als MP2) und Schicht III (auch bekannt als MP3). die drei Modi