PCM-Audiokodierung


Free Download Mp4Gain
picture

PCM-Audiokodierung

pcm

Pulse Code Modulation PCM ist die Abkürzung für Pulse Code Modulation.

PCM AUDIO ENCODING

Die Pulscodemodulation ist eines der Verschlüsselungsverfahren der digitalen Kommunikation. Der Hauptprozess besteht darin, die Sprach-, Bild- und anderen analogen Signale in regelmäßigen Abständen abzutasten, um sie zu diskretisieren, und gleichzeitig wird der abgetastete Wert gemäß der hierarchischen Einheit gerundet und quantisiert, und der abgetastete Wert wird durch einen Satz dargestellt. des Binärcodewerts.

Prinzipien der Sprachkodierung
Jeder mit elektronischem Hintergrund weiß, dass das vom Sensor erfasste Audiosignal eine analoge Größe ist und was wir im eigentlichen Übertragungsprozess verwenden, eine digitale Größe ist. Und das beinhaltet den Prozess der Umwandlung von analog zu digital. Und die Digitalisierung analoger Signale muss drei Prozesse durchlaufen, nämlich Abtasten, Quantisieren und Codieren, um die Pulscodemodulationstechnologie (PCM, Pulscodemodulation) der Sprachdigitalisierung zu realisieren.

Wandeln Sie ein analoges Signal in ein digitales Signal um
Probenahme
Sampling ist der Vorgang des Extrahierens von Abtastwerten aus einem analogen Signal mit einer Frequenz, die doppelt so hoch wie seine Signalbandbreite ist, und deren Umwandlung in ein diskret abgetastetes Signal auf der Zeitachse.

Abtastrate (Sample): Die Anzahl der Abtastungen pro Sekunde, die aus einem kontinuierlichen Signal extrahiert werden, um ein diskretes Signal zu bilden, ausgedrückt in Hertz (Hz).

Beispiel: Zum Beispiel
die Abtastrate des Audiosignals beträgt 8000 Hz.
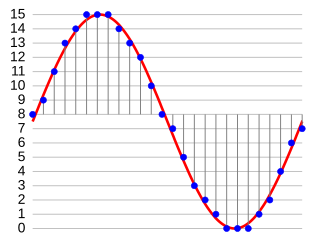
Es versteht sich, dass die Kurve der Spannungsänderung mit der Zeit, die der Abtastung in der obigen Abbildung entspricht, 1 Sekunde beträgt, sodass die folgenden 1 2 3 … 10 1-8000 Punkte haben müssen, dh 1 Sekunde wird unterteilt 8000 Teile, und der Reihe nach herausgenommen Der Spannungswert entspricht der Zeit von 8000 Punkten.

Quantisierung
Obwohl das abgetastete Signal ein diskretes Signal auf der Zeitachse ist, ist es immer noch ein analoges Signal und sein abgetasteter Wert liegt innerhalb eines bestimmten Wertebereichs und kann unendlich viele Werte haben. Offensichtlich ist es unmöglich, eine Gruppe von digitalen Codes so anzugeben, dass sie einer unendlichen Anzahl von Proben einzeln entsprechen. Um den Abtastwert durch einen digitalen Code auszudrücken, muss das “Rundungs”-Verfahren verwendet werden, um den Abtastwert gradweise “aufzurunden”, so dass der Abtastwert innerhalb eines bestimmten Wertebereichs von einer unendlichen Anzahl von Werten geändert werden kann. auf eine endliche Anzahl von Werten. Dieser Vorgang wird als Quantisierung bezeichnet.

Verglichen mit dem abgetasteten Signal vor der Quantisierung ist das quantisierte abgetastete Signal natürlich verzerrt und kein analoges Signal mehr. Diese Quantisierungsverzerrung erscheint als Rauschen, wenn das analoge Signal am Empfangsende wiederhergestellt wird, und wird als Quantisierungsrauschen bezeichnet. Die Größe des Quantisierungsrauschens hängt davon ab, wie Sie den Abtastwert „runden“.

Abtastbits: bezieht sich auf die Anzahl der Bits, die zur Beschreibung des digitalen Signals verwendet werden.
8 Bit (8 Bit) repräsentieren 2 hoch 8 = 256 und 16 Bit (16 Bit) repräsentieren 2 hoch 16 = 65536; je höher die Stichprobenzahl, desto höher die Präzision.

Die Anzahl der Samples wird hier angegeben, um den minimalen Abstand zwischen analogen Signalen zu beschreiben.
Angenommen, unsere Abtastzahl ist 8 und der Bereich des analogen Signals ist 2, 0, dann ist das Mindestintervall zwischen digitalen Signalen 2/2^8 = 2/256 = 1/128;
ähnlich ist die Sample-Nummer 16, also ist das minimale Intervall zwischen digitalen Signalen 2/256/256 = 1/(128*256)

Zum Beispiel
, der vom Audiosensor erfasste Spannungsbereich beträgt 0-3,3 V und die Abtastnummer 8 Bit (Bit).
, das heißt, wir nehmen 3,3 V/ 2 ^ 8 = 0,0128 als Quantisierungsgenauigkeit.
Wir teilen 3,3 V in 0,0128 als Schritt auf der Y-Achse, wie in Abbildung 3 gezeigt, 1 2 … 8 wird 0 0,0128 0,0256 … 3,3 V. Durch
Beispielsweise beträgt der Spannungswert eines Abtastpunkts 1,652 V (128 * 0,128 und 129 * 0,128). Wir runden ihn auf 1,65 V, was einem Quantisierungspegel von 128 entspricht.

Free Download Mp4Gain
picture

Audiokodierungsformat Teil 2

Audiokodierungsformat Teil 2

audio encoding

1950 meldete Bell Labs ein Patent für die Differential Pulse Code Modulation (DPCM) an. 1973 führten P. Cummiskey, Nikil S. Jayant und James L. Flanagan von Bell Labs Adaptive DPCM (ADPCM) ein.

AUDIO ENCODING

Wahrnehmungscodierung wurde zuerst für die Sprachcodierungskomprimierung mit linearer prädiktiver Codierung (LPC) verwendet. Das ursprüngliche Konzept von LPC geht auf die Arbeit von Fumitada Itakura (Nagoya University) und Saito Saito (Telegraph and Telephone in Japan) im Jahr 1966 zurück. In den 1970er Jahren entwickelten Bishnu S. Atal und Manfred R. Schroeder von Bell Labs eine Form von Adaptive Predictive Coding (APC) namens LPC, ein Wahrnehmungscodierungsalgorithmus, der die Maskierungseigenschaften des menschlichen Ohrs ausnutzte, und später, 1980, erschien Anfang der 1990er Jahre der Code Excited Linear Prediction (CELP)-Algorithmus, der zu dieser Zeit bemerkenswerte Komprimierungsraten erreichte . Wahrnehmungskodierung wird von modernen Audiokomprimierungsformaten wie MP3 und AAC verwendet.

Discrete Cosine Transform (DCT) von Nasir Ahmed, T. 1974 von Natarajan und KR Rao entwickelt, bildet die Grundlage für die Modified Discrete Cosine Transform (MDCT), die von modernen Audiokomprimierungsformaten wie MP3 und AAC verwendet wird. TCMD von JP Princen, A. W. Johnson und AB Bradley im Jahr 1987, nach früheren Arbeiten von Princen und Bradley im Jahr 1986. MDCT wird von modernen Audiokomprimierungsformaten wie Dolby Digital, MP3 und Advanced Audio Coding (AAC) verwendet.

Liste verlustbehafteter Formate
Allgemeines
Audio Coding Standard Basic Compression Algorithm Abkürzung stellen Marktanteil vor (2019) Siehe
Modifizierte diskrete Kosinustransformation (MDCT) Dolby Digital (AC-3) AC3 1991 58 %
ATRAC 1992 Unbekannte Adaptive Transformation Vocoding
MPEG Layer 3 MP3 1993 49 %
Erweiterte Audiocodierung (MPEG-2/MPEG-4) CAA 1997 88 %
Windows Media Audio WMA 1999 unbekannt
Ogg Vorbis Auger 2000 7%
Celtic Restricted Power Overlay Transformation 2011 gilt nicht
Arbeit Arbeit 2012 8%
Digital-Analog-Wandler Digital-Analog-Wandler 2015 unbekannt
Adaptive Differential Pulse Code Modulation (ADPCM) aptX / aptX-HD aptX 1989 unbekannt
DTS digitales Kinosystem 1990 14 %
Master of Quality Zertifizierung Quality Management Association 2014 unbekannt
Subband Coding (SBC) Audio Layer MPEG-1 II MP2 1993 unbekannt
Musepack MPC 1997
Gespräche
Weitere Informationen: Sprachcodierung
Lineare prädiktive Codierung (LPC)
Adaptive prädiktive Codierung (APC)
Codeerregte lineare Vorhersage (CELP)
Algebraischer Code Excited Linear Prediction (ACELP)
Relaxationscode Excited Linear Prediction (RCELP)
CELP mit niedriger Latenz (LD-CELP)
Adaptiver Multitarif (für GSM und 3GPP)
Codec2 (berühmt für fehlende Patentbeschränkungen)
Speex (berühmt für fehlende Patentbeschränkungen)
Modifizierte diskrete Kosinustransformation (MDCT)
AAC-LD
Constrained Energy Superposition Transformation (CELT)
Opus (hauptsächlich für Echtzeitanwendungen)

Audiokodierungsformat

Audiokodierungsformat

Audio Encoding

Vergleich der Kodierungseffizienz gängiger Audioformate.

audio encoding

Ein Audiocodierungsformat (oder manchmal ein Audiokomprimierungsformat) ist ein Inhaltsdarstellungsformat, das verwendet wird, um digitales Audio zu speichern oder zu übertragen, wie beispielsweise in digitalem Fernsehen, digitalem Radio und Audio- und Videodateien. Beispiele für Audiocodierungsformate sind MP3, AAC, Vorbis, FLAC und Opus. Eine bestimmte Software- oder Hardwareimplementierung, die in der Lage ist, Audio in einem bestimmten Audiocodierungsformat zu komprimieren und zu dekomprimieren, wird als Audiocodec bezeichnet. Ein Beispiel für einen Audio-Codec ist LAME, einer von mehreren verschiedenen Codecs, die die Audiocodierung und -decodierung in der Formatierung von MP3-Audiocodierungssoftware implementieren.

Bestimmte Audiocodierungsformate werden durch detaillierte technische Spezifikationsdokumente definiert, die als Audiocodierungsspezifikationen bekannt sind. Einige dieser Spezifikationen wurden von Standardisierungsgremien als technische Standards geschrieben und genehmigt und werden daher als Audiocodierungsstandards bezeichnet. Der Begriff “Standard” wird manchmal auch dafür verwendet, dass es sich um Normen und formale Standards handelt.

Audioinhalte, die in einem bestimmten Audiocodierungsformat codiert sind, werden normalerweise in einem Containerformat eingekapselt. Anstelle von rohen AAC-Dateien haben Benutzer also oft .m4a-Audiodateien, bei denen es sich um MPEG-4 Part 14-Container handelt, die AAC-codiertes Audio enthalten. Der Container enthält auch Metadaten wie Titel und andere Tags und möglicherweise einen Index für schnelle Suchen. Eine bemerkenswerte Ausnahme sind MP3-Dateien, bei denen es sich um rohe Audiocodierungen handelt und die kein Containerformat haben. Der De-facto-Standard für das Hinzufügen von Metadaten-Tags wie Titel und Interpret zu MP3s als ID3s ist ein Hack, der funktioniert, indem er das Tag zum MP3 hinzufügt und sich dann darauf verlässt, dass der MP3-Player die Schnipsel als fehlerhafte Audiokodierung erkennt, also überspringe den Block. In einem Video mit Audiodatei ist der codierte Audioinhalt mit dem Video (im videocodierten Format) innerhalb des Mediencontainerformats enthalten.

Ein Audiocodierungsformat gibt nicht alle Algorithmen an, die von den Codecs verwendet werden, die das Format implementieren. Laut psychoakustischen Modellen besteht ein wichtiger Teil der Funktionsweise der verlustbehafteten Audiokomprimierung darin, Daten auf eine Weise zu entfernen, die Menschen nicht hören können. Der Encoder-Implementierer kann frei wählen, welche Daten entfernt werden sollen (abhängig von seinem psychoakustischen Modell).

Verlustfreie Audiocodierungsformate reduzieren die Gesamtdaten, die zur Darstellung des Tons erforderlich sind, können ihn jedoch in seine ursprüngliche unkomprimierte Form zurückdecodieren. Verlustbehaftete Audiocodierungsformate reduzieren zusätzlich zur Komprimierung auch die Bitauflösung des Tons, was zu viel weniger Daten führt, jedoch auf Kosten eines unwiederbringlichen Informationsverlusts.

Consumer-Audio wird häufig mit verlustbehafteten Audio-Codecs komprimiert, da kleinere Größen einfacher zu verteilen sind. Die am weitesten verbreiteten Audiocodierungsformate sind MP3 und Advanced Audio Coding (AAC), die beide verlustbehaftete Formate sind, die auf modifizierter diskreter Cosinustransformation (MDCT) und perzeptiven Codierungsalgorithmen basieren.

Verlustfreie Audiocodierungsformate wie FLAC und Apple Lossless sind manchmal verfügbar, jedoch auf Kosten größerer Dateien.

Manchmal werden auch unkomprimierte Audioformate wie Pulscodemodulation (PCM oder .wav) verwendet. PCM ist das Standardformat für Compact Disc Digital Audio (CDDA), und nach der Einführung von MP3 wurde die verlustbehaftete Komprimierung schließlich zum Standard.