Datenkomprimierung Teil 3


Free Download Mp4Gain
picture

Datenkomprimierung Teil 3

Data Compression

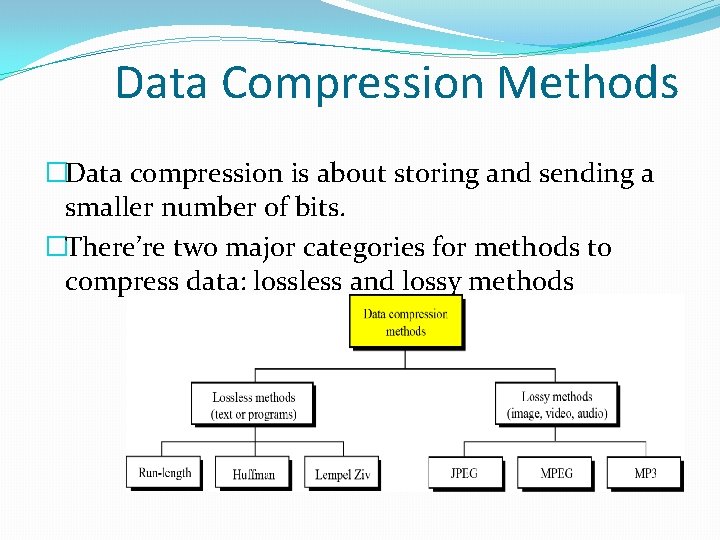
Das Komprimierungsverfahren Lempel-Ziv (LZ) ist einer der beliebtesten verlustfreien Speicheralgorithmen.

Data Compression

DEFLATE ist eine Variante von LZ, die für die Dekomprimierungsgeschwindigkeit und das Komprimierungsverhältnis optimiert ist, obwohl die Komprimierungsgeschwindigkeit sehr langsam sein kann, PKZIP , gzip und PNG verwenden alle DEFLATE. LZW (Lempel-Ziv-Welch) war bis zum Ablauf des Patents im Juni 2003 ein Unisys-Patent, dieses Verfahren wurde für GIF-Bilder verwendet. Erwähnenswert ist auch das LZR (LZ-Renau)-Verfahren, das die Grundlage des Zip-Verfahrens bildet. Das LZ-Verfahren verwendet ein tabellenbasiertes Komprimierungsmodell, bei dem Tabelleneinträge durch wiederholte Datenstrings ersetzt werden. Bei den meisten LZ-Methoden wird diese Tabelle dynamisch aus den anfänglichen Eingabedaten generiert. Diese Tabelle wird häufig unter Verwendung von Huffman-Codierung (z. B. SHRI, LZX) geführt. Ein aktuelles LZ-basiertes Codierungsschema, das gut funktioniert, ist LZX , das im CAB-Format von Microsoft verwendet wird.

Die besten Komprimierungswerkzeuge verwenden probabilistische Modellvorhersagen für die arithmetische Codierung. Die arithmetische Codierung wurde von dem finnischen Informationstheoretiker Jorma Rissanen erfunden und von Witten, Neal und Cleary in eine praktische Methode umgewandelt. Dieser Ansatz ermöglicht eine bessere Komprimierung als der wohlbekannte Huffman-Algorithmus und ist gut geeignet für eine adaptive Datenkomprimierung, bei der Vorhersagen kontextsensitiv sind. Die arithmetische Codierung wurde im JBIG-Binärbildkomprimierungsstandard, dem DejaVu-Dokumentkomprimierungsstandard, verwendet. Das Dasher-Texteingabesystem ist ein umgekehrter arithmetischer Kodierer.


Free Download Mp4Gain
picture

Datenkomprimierung Teil 2

Datenkomprimierung Teil 2

Data Compression

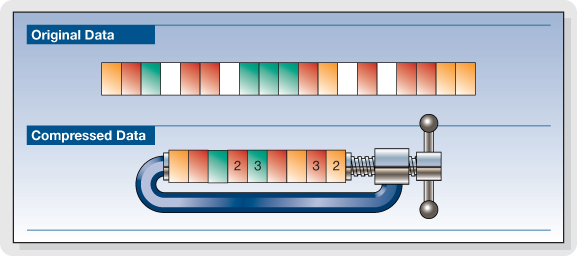
Eine sehr einfache Komprimierungsmethode ist die Lauflängencodierung, die dieselben kontinuierlichen Daten durch eine einfache Datenlängencodierung ersetzt, was ein Beispiel für eine verlustfreie Datenkomprimierung ist.

Data Compression

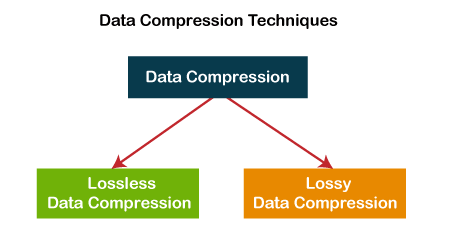
Diese Methode wird häufig auf Bürocomputern verwendet, um den Speicherplatz oder die Bandbreite in einem Computernetzwerk besser zu nutzen. Verlustfreiheit ist eine sehr wichtige Anforderung für symbolische Daten wie Tabellenkalkulationen, Text, ausführbare Dateien usw., da in den meisten Fällen sogar eine einzige Datenänderung nicht akzeptabel ist, außer in einigen begrenzten Fällen.

Bei Video- und Audiodaten ist ein gewisses Maß an Qualitätsminderung akzeptabel, solange ein erheblicher Teil der Daten nicht verloren geht. Unter Ausnutzung der Einschränkungen des menschlichen Wahrnehmungssystems kann viel Speicherplatz eingespart werden und die Qualität der erhaltenen Ergebnisse weicht nicht wesentlich von der Qualität der Originaldaten ab. Diese verlustbehafteten Datenkomprimierungsverfahren erfordern im Allgemeinen einen Kompromiss zwischen Komprimierungsgeschwindigkeit, komprimierter Datengröße und Qualitätsverlust.

Die verlustbehaftete Bildkomprimierung wird in Digitalkameras verwendet, um die Speicherkapazität bei geringer Verschlechterung der Bildqualität drastisch zu erhöhen. Die Videokomprimierung mit verlustbehaftetem MPEG-2-Codec für DVD implementiert eine ähnliche Funktion.

Bei der verlustbehafteten Audiokomprimierung werden psychoakustische Verfahren verwendet, um unhörbare oder schwer hörbare Komponenten aus einem Signal zu entfernen. Die menschliche Sprachkomprimierung verwendet häufig spezialisiertere Techniken, daher wird “Sprachkomprimierung” oder “Sprachcodierung” manchmal auch von “Audiokomprimierung” als separates Studiengebiet unterschieden. Verschiedene Audio- und Sprachkomprimierungsstandards fallen in die Kategorie der Audio-Codecs. Beispielsweise wird die Sprachkomprimierung für die Internettelefonie verwendet, während die Audiokomprimierung zum Rippen und Dekodieren von CDs mit MP3-Playern verwendet wird.

Theorie
Bearbeiten
Kompressionstheorie (die eng mit der algorithmischen Informationstheorie verwandt ist) und Ratenverzerrungstheorie, Forschungsarbeiten auf diesem Gebiet wurden hauptsächlich von dem amerikanischen Wissenschaftler Claude Elwood Shannon begründet, der Ende der 1990er und 1950er Jahre grundlegende Artikel über die veröffentlichte Thema. in den frühen 1900er Jahren. Doyle und Carlson schrieben im Jahr 2000, dass die Datenkomprimierung “eine der einfachsten und elegantesten Designtheorien in allen technischen Bereichen ist”. Kryptographie und Codierungstheorie sind ebenfalls eng verwandte Disziplinen, und auch die Idee der Datenkomprimierung und der statistischen Inferenz hat tiefe Wurzeln.

Viele verlustfreie Datenkomprimierungssysteme können als Vier-Stufen-Modell betrachtet werden, und verlustbehaftete Datenkomprimierungssysteme enthalten im Allgemeinen mehr Schritte, wie z. B. Vorhersage, Frequenztransformation und Quantisierung.

Datenkompression

Datenkompression

Data compression

Der Prozess der Codierung von Informationen mit weniger Bits als die ursprüngliche Darstellung
Data compression

In der Informatik und Informationstheorie ist die Datenkomprimierung oder Quellcodierung der Prozess der Darstellung von Informationen mit weniger Datenbits (oder anderen informationsbezogenen Einheiten), als wenn sie nicht codiert wären, gemäß einem spezifischen Codierungsmechanismus. Wenn wir beispielsweise „compression“ als „comp“ codieren, kann das Element mit weniger Datenbits dargestellt werden. Ein gängiges Beispiel ist das ZIP-Archivformat, das nicht nur eine Komprimierung bietet, sondern auch als Archivierer fungiert und viele Dateien im selben Archiv speichern kann.

Wir können Datenkonsistenz (dargestellt durch Informationsentropie, Entropie), Regelmäßigkeit und Vorhersagbarkeit verwenden, um eine Datenkomprimierung zu erreichen. Die zuerst von Menschen entwickelte Komprimierungstechnologie stellt eigentlich natürliche Sprache dar. Allgemein gesagt, wenn eine Sache in einer relativ vereinfachten natürlichen Sprache beschrieben werden kann, dann wird sie solche Dinge besser komprimieren können. Je konsistenter die Daten sind, desto konzentrierter sind ihre statistischen Merkmale. Nehmen Sie als Beispiel die Bildkomprimierung, die den Zeit- und Frequenzbereich der Fourier-Transformation, das Histogramm und die Eigenwerte zentral berücksichtigt.

Eine Datenkomprimierung ist möglich, da die meisten realen Daten statistische Redundanz aufweisen. Beispielsweise wird der Buchstabe „e“ im Englischen häufiger verwendet als der Buchstabe „z“, und es ist sehr unwahrscheinlich, dass auf den Buchstaben „q“ ein „z“ folgt. Die zerstörungsfreie Datenkomprimierung nutzt im Allgemeinen die statistische Redundanz aus, damit die Daten des Absenders prägnanter, aber vollständiger dargestellt werden können.

Das Komprimierungsverhältnis der zerstörungsfreien Datenkomprimierung reicht nicht aus, um die große Menge an Audio- und Videodaten zu verarbeiten, aber wenn ein gewisser Verlust an Wiedergabetreue zugelassen wird, kann eine höhere Komprimierung erreicht werden. Wenn Menschen beispielsweise Fotos oder Fernsehbilder betrachten, erkennen sie möglicherweise nicht, dass einige Details nicht perfekt sind. In ähnlicher Weise können zwei Audioaufzeichnungs-Sample-Streams gleich klingen, aber sie sind nicht genau gleich. Die destruktive Datenkomprimierung verwendet weniger Bits, um Bilder, Video oder Audio mit akzeptablen oder nicht wahrnehmbaren Zahlen darzustellen.

Es gibt jedoch häufig Dateien, die nicht mit destruktiver Datenkomprimierung komprimiert werden können, und tatsächlich können sie mit keinem Komprimierungsalgorithmus für Daten komprimiert werden, die keine erkennbaren Muster enthalten. Außerdem führt der Versuch, bereits komprimierte Daten zu komprimieren, häufig zu einer Datenüberflutung.

Tatsächlich wird die destruktive Datenkomprimierung irgendwann an den Punkt gelangen, an dem sie nicht mehr funktioniert. Ein extremes Beispiel: Der Komprimierungsalgorithmus löscht jedes Mal das letzte Byte der Datei, und nachdem dieser Algorithmus weiter komprimiert, bis die Datei leer ist, funktioniert der Komprimierungsalgorithmus nicht weiter.

Die Komprimierung ist wichtig, da sie dazu beiträgt, den Verbrauch teurer Ressourcen wie Festplattenspeicher und Verbindungsbandbreite zu reduzieren. Die Komprimierung erfordert jedoch Informationsverarbeitungsressourcen, die ebenfalls teuer sein können. Daher erfordert das Design des Datenkomprimierungsmechanismus einen Kompromiss zwischen der Komprimierungskapazität, dem Verzerrungsgrad, den erforderlichen Rechenressourcen und verschiedenen anderen Faktoren, die berücksichtigt werden müssen.

Wie jede Form der Kommunikation funktioniert auch die komprimierte Datenkommunikation nur, wenn sowohl Sender als auch Empfänger der Informationen den Verschlüsselungsmechanismus verstehen. Der Artikel macht zum Beispiel nur Sinn, wenn der Empfänger weiß, dass der Artikel in chinesischen Schriftzeichen interpretiert werden soll. Außerdem können komprimierte Daten vom Empfänger nur verstanden werden, wenn er das Verschlüsselungsverfahren kennt.

Audio- und Videodatenkomprimierung Teil 2

Audio- und Videodatenkomprimierung Teil 2

Audio and Video Compression

Tatsächlich wird die destruktive Datenkomprimierung irgendwann an den Punkt gelangen, an dem sie nicht mehr funktioniert. Ein extremes Beispiel: Der Komprimierungsalgorithmus löscht jedes Mal das letzte Byte der Datei, und nachdem dieser Algorithmus weiter komprimiert, bis die Datei leer ist, funktioniert der Komprimierungsalgorithmus nicht weiter.

Compression

Die Komprimierung ist wichtig, da sie dazu beiträgt, den Verbrauch teurer Ressourcen wie Festplattenspeicher und Verbindungsbandbreite zu reduzieren. Die Komprimierung erfordert jedoch Informationsverarbeitungsressourcen, die ebenfalls teuer sein können. Daher muss das Design des Datenkomprimierungsmechanismus Kompromisse hinsichtlich der Komprimierungsfähigkeit, des Verzerrungsgrads, der erforderlichen Rechenressourcen und verschiedener anderer Faktoren eingehen, die berücksichtigt werden müssen.

Wie jede Form der Kommunikation funktioniert auch die komprimierte Datenkommunikation nur, wenn sowohl Sender als auch Empfänger der Informationen den Verschlüsselungsmechanismus verstehen. Der Artikel macht zum Beispiel nur Sinn, wenn der Empfänger weiß, dass der Artikel in chinesischen Schriftzeichen interpretiert werden soll. Außerdem können komprimierte Daten vom Empfänger nur verstanden werden, wenn er das Verschlüsselungsverfahren kennt.
Tatsächlich wird die destruktive Datenkomprimierung irgendwann an den Punkt gelangen, an dem sie nicht mehr funktioniert. Ein extremes Beispiel: Der Komprimierungsalgorithmus löscht jedes Mal das letzte Byte der Datei, und nachdem dieser Algorithmus weiter komprimiert, bis die Datei leer ist, funktioniert der Komprimierungsalgorithmus nicht weiter.

Die Komprimierung ist wichtig, da sie dazu beiträgt, den Verbrauch teurer Ressourcen wie Festplattenspeicher und Verbindungsbandbreite zu reduzieren. Die Komprimierung erfordert jedoch Informationsverarbeitungsressourcen, die ebenfalls teuer sein können. Daher muss das Design des Datenkomprimierungsmechanismus Kompromisse hinsichtlich der Komprimierungsfähigkeit, des Verzerrungsgrads, der erforderlichen Rechenressourcen und verschiedener anderer Faktoren eingehen, die berücksichtigt werden müssen.

Wie jede Form der Kommunikation funktioniert auch die komprimierte Datenkommunikation nur, wenn sowohl Sender als auch Empfänger der Informationen den Verschlüsselungsmechanismus verstehen. Der Artikel macht zum Beispiel nur Sinn, wenn der Empfänger weiß, dass der Artikel in chinesischen Schriftzeichen interpretiert werden soll. Außerdem können komprimierte Daten vom Empfänger nur verstanden werden, wenn er das Verschlüsselungsverfahren kennt.