Audio Aufnahme

Audio Aufnahme

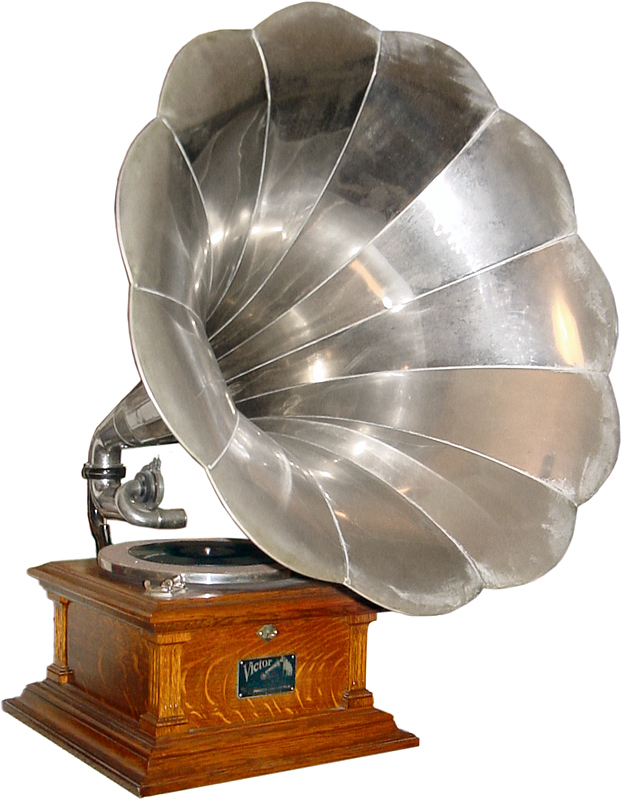
Phonograph Thomas Alva Edison

Die Ära der mechanischen Tonaufnahme begann 1877, als Thomas Alva Edison den Phonographen erfand.

Gramophon

Tatsächlich sind Grammophone, Grammophone und sogar moderne Vinyl-Player verbesserte Phonographen. Schließlich ist das Prinzip der Tonaufnahme in einem spiralförmigen Groove auf einem Medium unverändert geblieben.

1900 demonstrierte der dänische Ingenieur W. Paulsen auf der Weltausstellung in Paris ein Arbeitsmodell eines magnetischen Aufzeichnungsgeräts, das als Alternative zu Edisons Erfindung entwickelt wurde. Zum ersten Mal in der Geschichte der Menschheit ertönte auf einer Magnetaufnahme eine menschliche Stimme: Die erstaunten Pariser hörten die Stimme des österreichisch-ungarischen Kaisers Franz Joseph, der die Pfeife brach. Von diesem Moment an begann vielleicht die wahre Geschichte der Tonaufnahme, deren Theorie in den 30er Jahren des 20. Jahrhunderts aufgestellt wurde.

Ton ist ein komplexes analoges Signal. Zur Analyse solcher Signale wird eine in der Radioelektronik weit verbreitete Technik verwendet. Mit der Fourier-Transformation wird ein komplexes Signal in eine harmonische Reihe umgewandelt, die aus Sinuskurven mit unterschiedlichen Frequenzen und Amplituden besteht. Aber in der Praxis unterscheidet sich das Signal, mit dem wir es zu tun haben, natürlich stark von dem sinusförmigen.

Musiker nennen die erste Harmonische in diesem Spektrum den Grundton, und Harmonische mit höheren Frequenzen werden Harmonische genannt. Der Hauptton bestimmt die Tonhöhe und die Harmonischen geben ihm eine bestimmte Farbe, wodurch das Timbre einer Stimme oder eines Musikinstruments entsteht.

Zur Untersuchung der Spektren von Audiosignalen werden komplexe und teure Instrumente verwendet – Spektrumanalysatoren.

Mit Hilfe solcher Geräte kann festgestellt werden, dass einige Musikinstrumente wie eine Geige ein relativ einheitliches Spektrum und einige Windspektren mit ausgeprägten Maxima und Minima aufweisen, die als Formanten bezeichnet werden.

Es gibt keine Begriffe, die die Farbgebung des Timbres einer menschlichen Stimme oder von Musikinstrumenten direkt beschreiben. Daher müssen verschiedene Metaphern wie “tiefes Timbre”, “hartes Timbre”, “metallischer” Klang oder sogar “Transistor” verwendet werden.

Versuche, digitale Informationsverarbeitungsverfahren im Zusammenhang mit Tonaufnahmen zu verwenden, wurden viele Male unternommen, aber die ersten ernsthaften Ergebnisse wurden in den frühen 1980er Jahren des 20. Jahrhunderts erzielt und fielen mit der raschen Entwicklung von Computern und Computern zusammen erfolgreiche Mikrominiaturisierung von Funkkomponenten. Der Einsatz digitaler Tonverarbeitungstechniken hat aufregende neue Möglichkeiten eröffnet.

Um Ton auf einem Computer zu verarbeiten, muss er zuerst in ein digitales, codiertes Format konvertiert werden. Ein analoges Signal wird von Geräten codiert, die als Analog-Digital-Wandler (ADCs) bezeichnet werden. Das Hauptverfahren zum Codieren eines analogen Signals ist die Pulscodemodulation, die aus drei Operationen besteht: Abtasten, Quantisieren und Codieren.

Wir werden jetzt nicht auf die Codierungstheorie eingehen, zumal sie ziemlich kompliziert ist und höhere mathematische Fähigkeiten erfordert. Für uns ist es wichtig zu verstehen, dass die Qualität des digitalisierten Klangs und die daraus resultierende Dateigröße von der Abtastrate und der Bittiefe abhängen.

Die Abtastrate ist die Frequenz, mit der die Eigenschaften eines Audiosignals gemessen werden. Aus Kotelnikovs Abtasttheorem folgt, dass die Abtastfrequenz mindestens doppelt so hoch sein muss wie die höchste Frequenz des codierten Signals, um ein unverzerrtes digitales Signal zu erhalten. Daher muss beim Codieren eines Audiosignals die Abtastrate mindestens 40 kHz betragen. In digitalen Kommunikationssystemen beträgt die Abtastfrequenz 32 kHz, in Laser-CD-Playern und digitalen Consumer-Tonbandgeräten 44,1 kHz. Bei digitalen Studiogeräten ist die Abtastrate sogar noch höher: 48 kHz.

Die Bittiefe des aufgezeichneten Tons ist die Anzahl der Speicherbits, die zugewiesen sind, um jeden Wert der Amplitude des Tonsignals zum Zeitpunkt seiner Messung aufzuzeichnen. Moderne Soundkarten verwenden 8 oder 16 Bit Speicher pro Dimension, und 32-Bit-Karten höherer Qualität sind verfügbar. Je höher die Bittiefe ist, desto höher ist die Qualität des digitalisierten Klangs.

Wie bereits erwähnt, hängt die Größe einer Audiodatei von der Abtastrate und der Bittiefe des Sounds ab. Bei einer Abtastrate von 44 kHz und einer Klangtiefe von 16 Bit erfordert eine Minute Ton eine Dateigröße von 5,3 MB und bei einer Abtastrate von 11 kHz und 8 Bit 660 Kb.

Es ist klar, dass sich eine solche Verschwendung von Speicherplatz als inakzeptabel herausstellte und spezielle Algorithmen und Formate für die billigere Speicherung von Audiodateien erstellt wurden.

Parameter, die die Qualität von digitalem Audio beeinflussen. (Teil 3)

Parameter, die die Qualität von digitalem Audio beeinflussen. (Teil 3)

digital audio

Die Qualität des erhaltenen digitalen Klangs hängt von der Anzahl der Messungen des Schallpegels pro Zeiteinheit ab, dh von der Abtastfrequenz.

DIGITAL AUDIO

Die Audio-Abtastrate ist die Anzahl der Audio-Lautstärkemessungen in einer Sekunde.

Je mehr Messungen in einer Sekunde durchgeführt werden (je höher die Abtastfrequenz), desto genauer wiederholt die “Leiter” des digitalen Audiosignals die Kurve des analogen Signals.

Jedem “Schritt” des Diagramms wird ein bestimmter Wert für die Lautstärke zugewiesen. Lautheitspegel können als eine Reihe möglicher N-Zustände (Abstufungen) betrachtet werden, für deren Codierung eine bestimmte Menge an I-Informationen erforderlich ist, die als Audiocodierungstiefe bezeichnet wird.

Die Audiocodierungstiefe ist die Informationsmenge, die zum Codieren der diskreten Lautstärkepegel von digitalem Audio erforderlich ist.

Bei bekannter Codierungstiefe kann die Anzahl der digitalen Audio-Lautstärkepegel nach der allgemeinen Formel N = 2 I berechnet werden.

Wenn die Audio-Codierungstiefe beispielsweise 16 Bit beträgt, beträgt die Anzahl der Audio-Lautstärkepegel:

N = 2 I = 2 16 = 65 536.

Während des Codierungsvorgangs wird jedem Schallpegel ein eigener 16-Bit-Binärcode zugewiesen. Der niedrigste Schallpegel entspricht dem Code 0000000000000000 und der höchste – 1111111111111111.

Digitalisierte Audioqualität

Je höher die Abtastrate und die Tiefe der Audiokodierung sind, desto besser klingt der digitalisierte Ton und desto besser können Sie den digitalisierten Ton näher an den Originalton bringen.

Die höchste Qualität des digitalisierten Klangs, die der Qualität einer Audio-CD entspricht, wird mit einer Abtastrate von 48.000 Mal pro Sekunde, einer Abtastrate von 16 Bit und der Aufnahme von zwei Audiospuren (Stereomodus) erreicht. .

Es ist zu beachten, dass das Informationsvolumen in der Audiodatei umso größer ist, je höher die Qualität des digitalen Klangs ist.

Sie können das Informationsvolumen in einer digitalen Stereo-Sounddatei mit einer Dauer von 1 Sekunde und einer durchschnittlichen Klangqualität (16 Bit, 24.000 Messungen pro Sekunde) leicht abschätzen. Dazu muss die Codiertiefe mit der Anzahl der Messungen pro Sekunde multipliziert und mit 2 Kanälen multipliziert werden (Stereoton):

16 Bit × 24.000 × 2 = 768.000 Bit = 96.000 Byte = 93,75 KB.

Es gibt drei Haupttypen von Audio-Ziffern:

Format – keine Komprimierung;
Format (verlustbehaftet) – verlustbehaftete Komprimierung;
Format (verlustfrei): verlustfreie Komprimierung.
Verlustbehaftete Komprimierung: Technologie, bei der die codierte Datei im Vergleich zum Original erheblich reduziert wird, da Informationen entfernt werden, die vom menschlichen Ohr nicht wahrgenommen werden.

Der Nachteil dieser Technologie ist die Tatsache, dass die komprimierte Datei niemals mit dem Original identisch sein wird.

Liste der häufigsten verlustbehafteten Formate:

AAC (.m4a, .mp4, .m4p, .aac): Erweiterte Audiokodierung (häufig im MPEG-4-Container)
MP2 (MPEG-Schicht 2)
MP3 (MPEG Layer 3)
MPC (bekannt als Musepack, früher MPEGplus oder MP + genannt)
Ogg Vorbis
WMA (Windows Media Audio)

Verlustfrei – Verlustfreie komprimierte Audioformate, einschließlich:

FLAC (Free Lossless Audio Codec)
APE (Mono-Audio)
WV (WavPack)
Diese Formate können CDs unter Beibehaltung der Qualität in digitale Formate konvertieren. Als Beispiel können Sie eine CD nehmen, sie in WAV konvertieren, dann WAV in FLAC, dann von FLAC in WAV zurückkehren und sie dann auf eine leere CD brennen, und Sie haben eine absolut identische Kopie Ihrer Quelle.

Welches Format klingt die Musik mit der besten Qualität?
Am beliebtesten ist das verlustfreie FLAC-Format, und eines der am häufigsten verwendeten Konvertierungsprogramme von CD zu FLAC ist EAC (Exact Audio Copy).

Bei allen Parametern des digitalen Audios müssen vor allem die folgenden Indikatoren berücksichtigt werden:

Abtastrate (Genauigkeit der zeitlichen Digitalisierung eines analogen Signals),
Bitrate (Menge an Informationen, die in einer Datei in einer Sekunde enthalten sind).

Die Abtastrate ist die Frequenz, mit der digitales Audio verarbeitet wird. Die häufigste Abtastrate für hochwertige Audioformate beträgt 44,1 kHz.

Es ist allgemein anerkannt, dass eine hohe Bitrate die beste Qualität garantiert; Dies ist wahr, aber nur, wenn die Quelldatei von guter Qualität ist. Ein MP3 mit hoher Qualität sollte eine Bitrate von 320 kbps haben, aber ein FLAC-Format mit hoher Qualität hat im Allgemeinen eine Bitrate von 900 kbps und höher.

Was ist das beste Musikformat?
Zusätzlich zu den Audioformaten selbst werden für einen hochwertigen Musikklang auch hochwertige Wiedergabegeräte benötigt: Lautsprecher, Verstärker, Kopfhörer.

Parameter, die die Qualität von digitalem Audio beeinflussen. (Teil 2)

Parameter, die die Qualität von digitalem Audio beeinflussen. (Teil 2)

digital audio

Das Format wird auch als Anzahl der Kanäle in Mehrkanal-Soundsystemen (5.1; 7.1) bezeichnet. Ursprünglich wurde ein solches System für Kinos entwickelt, später jedoch vom Software Codec verbreitet

DIGITAL SOUND

Audio-Codec auf Software-Ebene

§ G.723.1 – einer der grundlegenden Codecs für IP-Telefonieanwendungen

§ G.729 – proprietärer Schmalband-Codec zur digitalen Darstellung von Sprache

§ Internet Low Code Rate Codec (iLBC) – ein beliebter kostenloser Codec für IP-Telefonie (insbesondere für Skype und Google Talk)

Audio Codec (Audio Codec; Audio Encoder / Decoder) – Ein Computerprogramm oder eine Hardware zum Codieren oder Decodieren von Audiodaten.

Software-Codec

Ein Audio-Codec auf Software-Ebene ist ein spezialisiertes Computerprogramm, ein Codec, der digitale Audiodaten gemäß einem Audiodateiformat oder einem Streaming-Audioformat komprimiert (komprimiert) oder dekomprimiert (dekomprimiert). Die Aufgabe eines Audio-Codecs als Kompressor besteht darin, ein Audiosignal mit einer bestimmten Qualität / Präzision und der kleinstmöglichen Größe bereitzustellen. Durch die Komprimierung wird der zum Speichern von Audiodaten erforderliche Speicherplatz verringert, und es ist auch möglich, die Bandbreite des Kanals zu verringern, über den die Audiodaten übertragen werden. Die meisten Audio-Codecs sind als Softwarebibliotheken implementiert, die mit einem oder mehreren Audio-Playern wie QuickTime Player, XMMS, Winamp, VLC Media Player, MPlayer oder Windows Media Player interagieren.

Beliebte Software-Audio-Codecs nach Anwendung:

§ MPEG-1 Layer III (MP3) ist ein proprietärer Codec für Audioaufnahmen (Musik, Hörbücher usw.) für Computergeräte und digitale Player

§ Ogg Vorbis (OGG) – das zweitbeliebteste Format, das in Computerspielen und Filesharing-Netzwerken zum Übertragen von Musik weit verbreitet ist

§ GSM-FR ist der erste digitale Sprachcodierungsstandard, der in GSM-Telefonen verwendet wird

Adaptive Multispeed (AMR): Sprachaufzeichnung auf Mobiltelefonen und anderen Mobilgeräten

Abhängigkeit der Lautstärke sowie des Tons von der Intensität und Frequenz der Schallwelle.

Hertz (bezeichnet mit Hz oder Hz) ist eine Maßeinheit für die Frequenz periodischer Prozesse (z. B. Schwingungen).
1 Hz bedeutet eine Ausführung des Prozesses in einer Sekunde: 1 Hz = 1 / s.

Wenn wir 10 Hz haben, bedeutet dies, dass wir zehn Ausführungen dieses Prozesses in einer Sekunde haben.

Das menschliche Ohr kann Schall mit Frequenzen von 20 Schwingungen pro Sekunde (20 Hertz, leiser Schall) bis 20.000 Schwingungen pro Sekunde (20 KHz, hoher Schall) wahrnehmen.

Darüber hinaus kann eine Person Schall in einem weiten Bereich von Intensitäten wahrnehmen, bei denen die maximale Intensität 1014-mal höher ist als die minimale (einhunderttausend Milliarden Mal).

Zur Messung der Schalllautstärke wurde eine spezielle Einheit von “Dezibel” (dB) erfunden und verwendet.

Eine Abnahme oder Zunahme der Schalllautstärke um 10 dB entspricht einer 10-fachen Abnahme oder Zunahme der Schallintensität.

Lautstärke in Dezibel

Damit Computersysteme Ton verarbeiten können, muss ein kontinuierliches Audiosignal durch Zeitabtastung in eine diskrete digitale Form umgewandelt werden.

Dazu wird eine kontinuierliche Schallwelle in separate kleine Zeitabschnitte unterteilt, für jeden Abschnitt wird ein bestimmter Wert der Schallintensität eingestellt.

Daher wird die kontinuierliche Abhängigkeit der Lautstärke des Schalls zum Zeitpunkt A (t) durch eine diskrete Folge von Lautstärkepegeln ersetzt. In der Grafik scheint dies eine glatte Kurve durch eine Folge von “Schritten” zu ersetzen.

Audio-Sampling synchronisieren

Ein an die Soundkarte angeschlossenes Mikrofon wird verwendet, um analoges Audio aufzunehmen und in ein digitales Format umzuwandeln.

Je dichter die diskreten Streifen in der Grafik sind, desto besser ist es letztendlich möglich, den Originalton wiederherzustellen.