Digitales Video, seine Hauptmerkmale


Free Download Mp4Gain
picture

Digitales Video, seine Hauptmerkmale

digital video

Bis vor kurzem konnten sich nur wenige vorstellen, dass es mit einem normalen Heimcomputer nicht nur möglich wäre, Ihre Lieblingsfilme anzusehen, sondern auch Ihre eigene Videobibliothek zu erstellen, den Inhalt alter Videobänder zu digitalisieren, Familienvideos zu bearbeiten und sogar Ihre eigenen zu erstellen. Filmmeisterwerke.

DIGITAL VIDEO

Alles begann 1992, als IBM und Intel die Indeo-Softwaretechnologie (kurz für Intel Video) entwickelten. Mit seiner Hilfe haben Benutzer die Möglichkeit, Videos zu digitalisieren und Videodateien auf einem PC zu erstellen und anschließend auf dem Bildschirm wiederzugeben.

Anfänglich war digitales Video ein analoges Signal, das in ein digitales Format umgewandelt wurde. Darüber hinaus führte das Umstellungsverfahren selbst zwangsläufig zu einem gewissen Qualitätsverlust. Heutzutage gehören Videorecorder und alte VHS-Kameras der Vergangenheit an, und moderne digitale Videokameras, DVD- und Blu-Ray-Player, mit denen Sie ein Signal sofort in digitaler Form empfangen können, bestimmen den Ball. Und das analoge Fernsehen weicht allmählich dem progressiveren digitalen Fernsehen.

Hauptmerkmale von digitalem Video
Digitales Video weist fünf Hauptmerkmale auf: Bildschirmauflösung, Bildrate, Farbtiefe, Bitrate (Videoübertragungsbreite) und Bildqualität.

Bildschirmauflösung (Auflösung): Gibt die Anzahl der Punkte (Pixel) horizontal und vertikal an, aus denen das Bild (Videobild) auf dem Bildschirm besteht. Bei der Aufzeichnung der Auflösung wird zuerst der Wert der Anzahl der Punkte pro Zeile (horizontale Auflösung) und dann die Anzahl der am Bild beteiligten Zeilen (vertikale Auflösung) angegeben. Für den europäischen PAL-Videostandard beträgt die Bildgröße beispielsweise 720 x 576 Pixel, für den nordamerikanischen NTSC-Standard 720 x 480, für hochauflösendes Video (HD 720p) – 1280 x 720 und für den neuen HDTV-Standard (Full HD) – 1920 x 1080 Pixel. Wie Sie wahrscheinlich verstehen, ist die Videoqualität umso besser, je höher die Bildschirmauflösung ist.

Die Bildrate ist ein Wert, der angibt, wie viele Bilder pro Sekunde geändert werden. Die Standardgeschwindigkeit für die Videowiedergabe wird als Wert gleich 30 Bildern / s angesehen. Für das Kino ist diese Zahl etwas niedriger und beträgt 24 Bilder / s.

Die Farbtiefe (Farbauflösung) ist eine Eigenschaft, die die Anzahl der Farben angibt, die an der Bildung eines Videobildes beteiligt sein können. Die Anzahl der Farben in digitalen Videos wird in Bit gemessen. 1 Bit kann also zwei verschiedene Werte annehmen (0 oder 1) und es können nur zwei Farben (normalerweise Schwarz und Weiß) codiert werden. Mit zwei Bits können Sie 4 Farben (2 2 = 4) codieren, mit drei Bits – 8 Farben (2 3), vier – 16 (2 4) und so weiter.

Typischerweise wird die Farbauflösung durch spezielle Farbmodelle beschrieben. In der Computertechnologie wird das RGB-Modell (Rot-Grün-Blau) verwendet, das durch die folgenden gängigsten Farbtiefenmodi dargestellt werden kann: 8-Bit (256 Farben), 16-Bit (65.536 Farben) und 24-Bit (16.777) .216 Farben). Übrigens kann das menschliche Auge nach verschiedenen Meinungen 5-10 Millionen Farbtöne wahrnehmen.

Bitrate (Videostreambreite): Zeigt die Anzahl der pro Sekunde verarbeiteten Videobits an. Mit anderen Worten, dies ist die Videoübertragungsgeschwindigkeit, die in Megabit pro Sekunde (Mbit / s) gemessen wird. Je höher es ist, desto besser ist die Qualität. Für den DVD-Videostandard beträgt die Bitrate beispielsweise etwa 5 Mbit / s und für das HDTV-Format bereits 10 Mbit / s. Übrigens wird der Bitratenwert meistens zur Auswertung verwendet die Qualität des über das Internet übertragenen Videos.

Die Bildqualität ist eine Eigenschaft zur Bewertung der Qualität des verarbeiteten Videos im Vergleich zum Original und wird durch eine Reihe von Werten für Auflösung, Farbtiefe und Videoübertragungsgeschwindigkeit bestimmt.

Kompressionsstandards
Eine Minute reinen, unkomprimierten und digitalisierten Tons nimmt auf der Festplatte eines Computers etwa 10 MB ein, wodurch Musikdateien für die überwiegende Mehrheit platzsparend in komprimierter Form gespeichert werden. Wie lange dauert eine Minute unkomprimiertes Video? Um beispielsweise ein 60-Sekunden-Video mit einer Rate von 30 Bildern pro Sekunde, einer Auflösung von 720 x 576 Pixel und einer Farbtiefe von 16 Bit zu platzieren, benötigen Sie ungefähr eineinhalb Gigabyte freien Speicherplatz. Und das ohne Berücksichtigung der Audiospur. Nach diesen Zahlen muss wahrscheinlich nicht erklärt werden, warum digitale Videos ausschließlich in komprimierter Form auf unseren Computern gespeichert werden.

Es gibt mehrere Dutzend gängige Komprimierungsformate, die unterschiedliche Komprimierungsalgorithmen verwenden.


Free Download Mp4Gain
picture

MPEG: Fragen und Antworten

MPEG: Fragen und Antworten

]MPEG Video

Was ist MPEG?

MPEG Video

MPEG ist eine Gruppe von Personen innerhalb der ISO (International Standards Organization), die zusammenkommen, um Standards für die digitale Video- und Audiokomprimierung zu entwickeln. Insbesondere identifizierten sie einen komprimierten Durchfluss und einen Dekompressor dafür. Die Komprimierungsalgorithmen werden von jedem Hersteller individuell festgelegt, was der Vorteil des veröffentlichten International Standard ist. Die MPEG-Gruppe trifft sich ungefähr viermal im Jahr für ungefähr eine Woche. Der größte Teil der Arbeit wird zwischen Besprechungen, Organisation und Planung für sie erledigt.

Hat es etwas mit JPEG zu tun?
Ja, die Namen sind Konsonanten und die Gruppen gehören zusammen mit JBIG und MHEG demselben ISO-Unterausschuss an und treffen sich am selben Ort und zur selben Zeit. Es sind jedoch unterschiedliche Menschen mit unterschiedlichen Zielen und Bedürfnissen. JPEG dient zum Komprimieren von Standbildern, MPEG zum Live-Video und zugehörigem Audio.

Was sind JBIG und MHEG?
JBIG dient zur Komprimierung von Binärbildern (Faxen, …) und MHEG für Multimediadaten zur Integration von Standbildern, Video, Audio, Text usw.

Wie funktioniert MPEG-Video?
Ein digitales Farbbild der komprimierten Sequenz wird in den YUV-Farbraum (YCbCr) konvertiert. Die Y-Komponente repräsentiert die Intensität und die U- und V-Komponenten repräsentieren die Chromatizität. Da das menschliche Auge weniger empfindlich auf Chroma als auf Intensität reagiert, kann die Auflösung der Farbkomponenten zweimal vertikal oder sowohl vertikal als auch horizontal reduziert werden. Bei Animationen und hochwertigen Studio-Videos wird kein Downsampling angewendet, um die Qualität zu erhalten. Bei Heimanwendungen, bei denen die Streams geringer und die Ausrüstung billiger sind, führt diese Aktion nicht zu einem spürbaren Verlust. auf visuelle Wahrnehmung, während wertvolle Daten gespeichert werden.

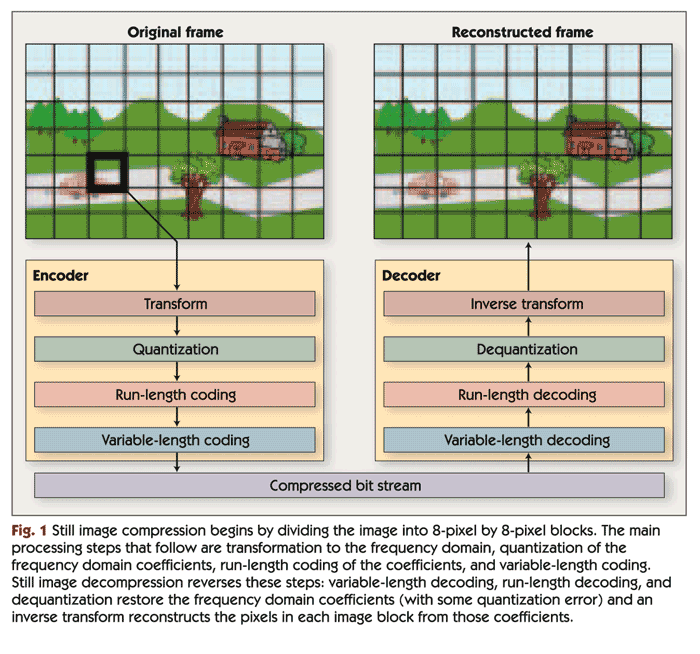
Die Grundidee des gesamten Schemas besteht darin, die Bewegung von einem Frame zum anderen vorherzusagen und dann eine diskrete Cosinustransformation (DCT) anzuwenden, um die Redundanz im Raum neu zu verteilen. Die DCT wird in 8×8-Punktblöcken durchgeführt, die Bewegungsvorhersage im Intensitätskanal (Y) in 16×16-Punktblöcken oder, abhängig von den Eigenschaften der ursprünglichen Bildsequenz (Interlaced-Scan, Inhalt), in Blöcken 16×8 Punkte. Mit anderen Worten, ein gegebener 16 × 16-Pixelblock wird in dem aktuellen Rahmen in dem entsprechenden größeren Bereich in den vorherigen oder nachfolgenden Rahmen gesucht. Die DCT-Koeffizienten (die Originaldaten oder die Differenz zwischen diesem und seinem entsprechenden Block) werden quantisiert, dh sie werden durch eine bestimmte Zahl geteilt, um unbedeutende Bits zu verwerfen. Viele Koeffizienten nach einer solchen Operation erweisen sich als Null.

Wie hängen die Frames zusammen?
Es gibt drei Arten von codierten Frames. I-Frames sind Frames, die als Standbilder ohne Bezug zum nächsten oder nächsten codiert sind. Sie werden als Ausgangspunkte verwendet. P-Frames sind vorhergesagte Frames aus vorherigen I- oder P-Frames. Jeder Makroblock in dem P-Rahmen kann mit einem Vektor und der DCT-Koeffizientendifferenz des entsprechenden Blocks vom zuletzt decodierten I oder P kommen, oder er kann wie in I codiert sein, wenn der entsprechende Block nicht gefunden wurde.

Und schließlich gibt es die B-Frames, die aus den beiden nächsten I- oder P-Frames vorhergesagt werden, einen vor und einen nach. In diesen Frames werden die entsprechenden Blöcke durchsucht und der beste ausgewählt. Der direkte Vektor wird gesucht, dann die Umkehrung, und der Durchschnitt zwischen den entsprechenden Makroblöcken in der Vergangenheit und der Zukunft wird berechnet. Wenn dies nicht funktioniert, kann der Block als I-Frame codiert werden.

Die Reihenfolge der decodierten Frames sieht im Allgemeinen so aus

IBBPBBPBBPBBIBBPBBPB …

Es gibt 12 Frames von I bis I Frame. Dies basiert auf der Direktzugriffsanforderung, dass der Startpunkt alle 0,4 Sekunden wiederholt werden muss. Die Beziehung von P nach B basiert auf Erfahrung.

Damit der Decoder funktioniert, muss der erste P-Frame in der Sequenz vor dem ersten B liegen, damit die komprimierte Sequenz folgendermaßen aussieht:

0 xx 3 1 2 6 4 5 …

Dabei sind die Zahlen die Anzahl der Frames. xx kann nichts sein, wenn es der Anfang einer Sequenz ist, oder Frames B -2 und -1, wenn es sich in der Mitte einer Sequenz befindet.

Sie müssen zuerst den I-Frame dekodieren, dann P und dann, wenn beide im Speicher sind, B dekodieren. Während der Decodierung wird P angezeigt. I-Frame, B wird sofort angezeigt und das decodierte P wird während der Decodierung des nächsten angezeigt.

Digitales Video, seine Vorteile

Digitales Video, seine Vorteile

DIGITAL VIDEO

Digitale Technologien bieten unbestreitbare Vorteile gegenüber analogen Technologien.

Digital Video

Das digitalisierte Signal kann alle in analoger Form gespeicherten Informationen speichern. Moderne digitale Datenübertragungs-, Aufzeichnungs- und Speichertechnologien verzerren das Signal praktisch nicht.

Einer der unbestreitbaren Vorteile digitaler Technologien ist die Fähigkeit, ein leistungsfähiges mathematisches Gerät anzuwenden, um Video- und Audioinformationen in ein digitalisiertes Signal zu komprimieren. Im Gegensatz zu “analog” kann “digital” jederzeit mit 100% Wiederholbarkeit reproduziert werden. Folglich eröffnet das digitalisierte Signal bequeme Nachbearbeitungs-, Analyse- und Simulationsoptionen.

Die wichtigsten Videokomprimierungsmethoden bestehen darin, Daten innerhalb eines einzelnen Frames zu komprimieren und die Übertragung von Änderungen zwischen Frames zu optimieren. Selbst wenn Sie sich ein Standbild ansehen, können Sie feststellen, dass es viele Informationen desselben Typs und doppelte Informationen enthält. Beispielsweise ist die Hintergrundintensität normalerweise ein konstanter Wert; Viele separate Bereiche des Bildes, die erhebliche Bildgrößen einnehmen, haben auch den gleichen digitalen Signalpegel. Natürlich macht es keinen Sinn, all diese Informationen ohne Komprimierung zu übertragen. Durch die Verwendung spezieller Videokomprimierungstechniken, die sich Frame für Frame reibungslos ändern, ist es möglich, die resultierende Dichte der Informationsübertragung über das Netzwerk weiter zu reduzieren.

Im Gegensatz zu universellen Archivierern (wie WinRar oder WinZip) kann die Videokomprimierung mit einem gewissen Verlust erfolgen, dessen Höhe vom ausgewählten Codec abhängt. Moderne Komprimierungsalgorithmen verwenden eine umfassende logische Analyse des Videos, um doppelte Fragmente zwischen Frames zu extrahieren und die Größe der endgültigen Datei zu reduzieren. Während der Wiedergabe werden die komprimierten Informationen “gestreckt” und dann dem Benutzer angezeigt. Auf einem Computer mit geringem Stromverbrauch kann das Dekomprimieren von mit einigen Codecs komprimierten Bildern lange dauern.

Digitale Videokomprimierungstechnologien
Es gibt viele digitale Videokomprimierungstechnologien. Einige der in Betracht gezogenen Kompressoren verwenden mehr als eine Kompressionstechnologie, jedoch eine Kombination davon. Beispielsweise verwenden sowohl Indeo 3.2 als auch Cinepak eine Vektorquantisierung. Die internationalen Standards MPEG-1, MPEG-2, MPEG-4, H.261 und H.263 verwenden eine kombinierte BDKP-Technologie und Bewegungskompensation. Einige moderne Algorithmen verwenden die DWT-Technologie (Discrete Wavelet Transform). Andere Technologien umfassen die fraktale Bildkomprimierung.

Verlustfreie Kompression

Die Bildkomprimierung kann nur dann ohne Qualitätsverlust durchgeführt werden, wenn während des Komprimierungsprozesses kein Datenverlust aufgetreten ist. Infolgedessen stimmt das nach der Dekomprimierung erhaltene Bild genau (Stück für Stück) mit dem Original überein. Beispiele für eine solche Komprimierung sind GIF für statische Grafiken und GIF89a für Videos.

Verlustbehaftete Komprimierung

Die Komprimierung kann verlustbehaftet sein, wenn während des Komprimierungsprozesses Informationen verloren gehen. Unter dem Gesichtspunkt der menschlichen Wahrnehmung sollte eine verlustbehaftete Komprimierung jedoch nur als die Komprimierung betrachtet werden, bei der es möglich ist, das Ergebnis der Komprimierung mit bloßem Auge vom Original zu unterscheiden. Obwohl zwei Bilder, das Original und das Ergebnis der Komprimierung mit dem einen oder anderen Kompressor, möglicherweise nicht nach und nach zusammenfallen, ist der Unterschied zwischen ihnen möglicherweise völlig unmerklich. Beispiele hierfür sind der JPEG-Algorithmus zum Komprimieren statischer Grafiken und der M-JPEG-Algorithmus zum Komprimieren von Videos.

Verlustfreie Komprimierung aus Wahrnehmungsperspektive

Als formal verlustbehaftete Komprimierung kann ein Komprimierungsschema gleichzeitig in Bezug auf die menschliche Wahrnehmung verlustfrei erscheinen. Die meisten verlustbehafteten Komprimierungstechnologien haben den sogenannten Compression Quality Factor (QF), der die wahrgenommene Qualitätsseite charakterisiert und zwischen 0 und 100 liegt.