Grundbegriffe der digitalen Klangtheorie


Free Download Mp4Gain
picture

Grundbegriffe der digitalen Klangtheorie

Digital Sound

Schall ist im Allgemeinen die Schwingung eines elastischen Mediums. Der Schall wird durch mechanische Vibrationen eines Objekts (dies kann eine Saite, Stimmbänder usw. sein) in Kontakt mit der Umgebung verursacht. Die Schwingungsfrequenz (gemessen in Hertz) bestimmt die Tonhöhe. Je höher die Frequenz, desto lauter der Klang. Das menschliche Ohr kann Schallschwingungen aus der Luft mit einer Frequenz von 20 Hz bis 20 kHz wahrnehmen. Das Ohr nimmt die Amplitude der Schwingung als Volumen wahr. Je höher die Amplitude, desto lauter der Klang.
Digital Sound

Elektromagnetische Wellen sind ein direktes Analogon von Schallwellen. Letztere sind weniger anfällig für die Verbreitung durch die Umwelt, die Informationen, die sie enthalten, sind einfacher zu speichern und zu verarbeiten. Elektromagnetische Wellen sind der wichtigste sekundäre Schallträger. Die Umwandlung von Schallwellen in elektromagnetische Wellen (sowie der umgekehrte Betrieb) erfolgt aufgrund des üblichen Induktionseffekts, der darin besteht, dass ein Strom in einem Leiter auftritt, wenn er in ein magnetisches Wechselfeld gebracht wird.

Einfach ausgedrückt, induziert die Schwingung des Lautsprechermembranmagneten in der Nähe der Spule einen Wechselstrom. Wenn dieser Strom an einen anderen Lautsprecher angelegt wird, bewegt sich der Magnet auf seiner Membran und erzeugt einen entsprechenden Klang.

So funktionieren Telefon und Radio.

In elektromagnetische Wellenform umgewandelter Schall kann leicht gespeichert werden. Dazu muss ein Parameter des Trägers (die Tiefe der Plattenspur oder der Magnetisierungsgrad des Films) mit der Amplitude der Schwingungen (dh der Stärke des induzierten Stroms in der Lautsprecherspule) verglichen werden. . Schall, der direkt in elektromagnetische Wellen umgewandelt wird, wird als analoger Schall bezeichnet. Sein Hauptmerkmal ist die direkte Entsprechung der übertragenen oder aufgezeichneten elektromagnetischen Wellen mit den akustischen.

Digitaler Sound ist relativ neu. Der Hauptunterschied zum Analogon liegt in der Diskretion. Beim Digitalisieren misst ein spezielles Gerät, ein Analog-Digital-Wandler (ADC), in regelmäßigen Abständen (ca. 0,001 bis 0,0001 Sekunden) die Größe der Amplitude einer elektromagnetischen Welle, die einer analogen Klangform entspricht, und schreibt ihren Wert zu einer Datei mit einer bestimmten Genauigkeit. Dieser Wert wird im Allgemeinen als Stichprobe oder im Jargon als Stichprobe (der Stichprobe in Englisch als Stichprobe) bezeichnet. Die gleiche Digitalisierung wird oft als Abtastung oder Abtastung bezeichnet.

Durch Konvertieren von Ton von digital in analog (dies erfolgt durch ein Gerät, das als Digital-Analog-Wandler (DAC) bezeichnet wird).

Die Interpolation (Approximation) der Zwischenwerte der Amplitude erfolgt nach den bekannten. Da die Abtastfrequenz normalerweise hoch ist, können Sie mit dieser Operation das ursprüngliche analoge Signal ziemlich genau rekonstruieren.

Die digitale Klangform zeichnet sich durch fünf Parameter aus.

1. die Abtastrate;
2. Bitgröße der Samples.
3. Die Anzahl der Kanäle oder Spuren.
4. Komprimierungs- / Dekomprimierungsalgorithmus (Codec).
5. Speicherformat.

Da jeder dieser Parameter sehr spezifisch ist, werden wir sie separat betrachten.

Abtastrate
Die Abtastrate bestimmt, wie viele Abtastungen pro Sekunde beim Digitalisieren entnommen werden. Wenn wir digitalen Ton mit digitalen Bildern vergleichen, entspricht die Abtastrate der Auflösung (eine “realistischere” Analogie ist die Bildrate im Kino). Je höher die Abtastfrequenz ist, desto besser ist es möglich, das analoge Signal basierend auf der digitalen Form des Klangs zu rekonstruieren (genauer gesagt, je höher die Abtastfrequenz, desto breiter ist das Frequenzspektrum, das während der Digitalisierung aufgezeichnet werden kann).
Das berühmte Nyquist-Kotelnikov-Theorem besagt, dass für die korrekte Rekonstruktion eines analogen Signals aus seiner digitalen Aufzeichnung die Abtastfrequenz mindestens doppelt so hoch sein muss wie die maximale Schallfrequenz.

Da die obere Hörgrenze 20 kHz beträgt, sollte die Abtastrate idealerweise mindestens 40 kHz betragen. Aus diesem Grund beträgt die Standard-Abtastfrequenz für die Aufnahme von CDs 44,1 kHz (sogenannte CD-Qualität). Die Samplerate kann zwar höher sein, diese Klangqualität wird jedoch nur von Aufnahmestudios und besonders anspruchsvollen Musikliebhabern verwendet.

Eine Abtastrate von 44,1 kHz ist nicht immer ideal. Bei der Übertragung von Daten über ein Netzwerk mit geringer Bandbreite muss die Klangqualität zugunsten der Größe geopfert werden. In der Praxis werden häufig Abtastfrequenzen verwendet, die zwei-, vier- und achtmal niedriger als 44,1 kHz sind.
Free Download Mp4Gain
picture

Soundinformationen auf dem Computer

Soundinformationen auf dem Computer

Digital Audio

Schall ist ein kontinuierliches Signal, eine Schallwelle mit variabler Amplitude und Frequenz.

digital wave sound

Je größer die Amplitude des Signals ist, desto stärker ist es für eine Person.

Je höher die Frequenz des Signals ist, desto höher ist die Tonhöhe.

Die Frequenz einer Schallwelle wird als Anzahl von Schwingungen pro Sekunde ausgedrückt und in Hertz (Hz, Hz) gemessen.

Das menschliche Ohr kann Geräusche im Bereich von Hz bis 20 kHz wahrnehmen, was als Schall .2020 bezeichnet wird
Die Anzahl der Bits pro Audiosignal wird als Audiocodierungstiefe bezeichnet.
Moderne Soundkarten bieten eine 16-, 32- oder 64-Bit-Audiocodierungstiefe. 163264

Beim Codieren von Audioinformationen wird ein kontinuierliches Signal durch ein diskretes ersetzt, dh es wird in eine Folge von elektrischen Impulsen (binäre Nullen und Einsen) umgewandelt.
Der Prozess der Umwandlung von Audiosignalen von einer kontinuierlichen Darstellungsform in eine diskrete digitale Form wird als Digitalisierung bezeichnet.
Ein wichtiges Merkmal beim Codieren von Audio ist die Abtastrate, die Anzahl der Signalpegelmessungen in Sekunden: 1
– (eine) Messung pro Sekunde entspricht einer Frequenz von Hz; 11
– Messungen pro Sekunde entsprechen einer Frequenz von kHz. 10001
Die Audio-Abtastrate ist die Anzahl der Audio-Lautstärkemessungen in einer Sekunde.
Die Anzahl der Messungen kann im Bereich von kHz bis kHz liegen (von der Funkübertragungsfrequenz bis zur Frequenz, die der Klangqualität von Musikmedien entspricht) .848

Je höher die Abtastfrequenz und -tiefe des Klangs ist, desto besser ist der Klang des digitalisierten Klangs. Die niedrigste Qualität des digitalisierten Tons, die der Qualität der Telefonkommunikation entspricht, wird mit einer Abtastrate von Zeiten pro Sekunde, einer Abtastrate von Bits und durch Aufzeichnen einer Audiospur (“Mono” -Modus) erhalten. Das digitalisierte Audio mit der höchsten Qualität, das der Qualität einer Audio-CD entspricht, wird mit einer Abtastrate von Zeiten pro Sekunde, einer Abtastrate von Bits und der Aufnahme von zwei Audiospuren (Stereomodus) erreicht .8000 848 000 16
Es ist zu beachten, dass das Informationsvolumen in der Audiodatei umso größer ist, je höher die Qualität des digitalen Klangs ist.
Das Informationsvolumen in einer Mono-Audiodatei () kann wie folgt geschätzt werden: VV = N⋅ f⋅ k, wobei die Gesamtdauer des Tons (Sekunden) die Abtastfrequenz (Hz) ist, ist die Codierungstiefe (Bit) .norteFk

Zum Beispiel mit einer Klangdauer von einer Minute und einer mittleren Klangqualität (Bits, kHz): 11624
V = 60 ≤ 24000 ≤ 16 Bit = 23040000 Bit = 2.880.000 Bytes = 2812,5 kB = 2,75 MB.

Bei der Codierung von Stereoton wird der Abtastvorgang für den linken und den rechten Kanal getrennt und unabhängig voneinander ausgeführt, wodurch sich die Größe der Audiodatei im Vergleich zu Monoton verdoppelt.

Lassen Sie uns beispielsweise das Informationsvolumen einer digitalen Stereo-Sounddatei mit einer Dauer von einer Sekunde und einer durchschnittlichen Klangqualität (Bits, Messungen pro Sekunde) schätzen. Für diese Codierung muss die Tiefe mit der Anzahl der Messungen pro Sekunde multipliziert und mit (Stereo) multipliziert werden: 11624 00012
V = 16 Bit ⋅ 24000⋅2 = 768000 Bit = 96000 Bytes = 93,75 KB.

Es gibt verschiedene Methoden zum Codieren von Audioinformationen mit Binärcode, wobei zwei Hauptbereiche unterschieden werden können: die FM-Methode und die Wave-Table-Methode.

Das FM-Verfahren (Frequency Modulation) basiert auf der Tatsache, dass theoretisch jeder komplexe Klang in eine Folge der einfachsten harmonischen Signale unterschiedlicher Frequenzen zerlegt werden kann, von denen jedes eine reguläre Sinuskurve ist und daher Es kann durch einen Code beschrieben werden. Die Zerlegung von Audiosignalen in harmonische Reihen und die Darstellung in Form von diskreten digitalen Signalen erfolgt durch spezielle Geräte – Analog-Digital-Wandler (ADC).

Umwandlung eines Audiosignals in ein diskretes Signal: zu – Audiosignal am ADC-Eingang; b – diskretes Signal am ADC-Ausgang.

Digital-Analog-Wandler (DACs) führen eine Rückwärtskonvertierung durch, um mit einem numerischen Code codierten Ton wiederzugeben. Der Tonumwandlungsprozess ist in Abb. Unten dargestellt. Diese Codierungsmethode bietet keine gute Klangqualität, aber kompakten Code.

Umwandlung eines diskreten Signals in ein Audiosignal: zu – diskretes Signal am DAC-Eingang; b – Audiosignal am DAC-Ausgang.

Die Tischwellenmethode (die Welle, die Tabelle) basiert auf der Tatsache, dass die zuvor vorbereiteten Tabellen Klangbeispiele aus der Welt, Musikinstrumente usw. speichern.

Schallpegel, Lautstärke, Normalisierung

Schallpegel, Lautstärke, Normalisierung

Normalize Audio

Dieser Artikel enthält eine kurze Erläuterung der Begriffe Lautstärke, Schallpegel, Normalisieren, Verstärkung und einiger anderer sowie ihrer Beziehung und Verwendung in Bezug auf das Digispot-Broadcast-Automatisierungssystem.

Volume normalization

Lautstärke
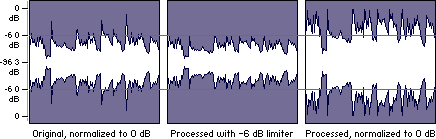
Der Begriff Schallpegel bezieht sich auf den Amplitudenpegel des Schallsignals. In Bezug auf ein Programmierelement, ein MDB-Element oder ein anderes Klangstück sprechen wir über den maximalen (maximalen) Signalpegel im gesamten Stück. Dieser Pegel wird in dBFS-Einheiten gemessen und ist fast immer negativ. Dieser Pegel ist wichtig, da er davon abhängt, um wie viel der Pegel und damit die Lautstärke des Klangs erhöht werden kann, ohne den theoretischen Schwellenwert von 0 dBFS zu überschreiten.

Die Signalpegelanzeigen dienen zur visuellen Beobachtung des aktuellen Signalpegels im realen Pegel.

Ein Diagramm der zeitlichen Änderung des Signalpegels wird als Signalgramm bezeichnet und dient zur Anzeige von Tonträgern und anderen Tonelementen in verschiedenen Fenstern des Digispot-Systems, z. B. im Spleißbearbeitungsfenster, beim Bearbeiten von Audio usw.

Im Digispot-System wird der maximale Pegel des Programmierelements und des CDM einmal berechnet und zur späteren Verwendung gespeichert, z. B. zur Normalisierung.
Die Bestimmung des Spitzensignals wird mit der gleichzeitigen Bestimmung seiner Lautstärke kombiniert, diese Werte werden immer zusammen berechnet.

Echter Schallpegel
Der Begriff True Sound Level bezieht sich auf den hypothetischen Amplitudenpegel eines analogen Tonsignals, bei dem es sich um eine Interpolation eines vorhandenen digitalisierten Soundtracks handelt. Der Unterschied zu nur “Pegel” besteht darin, dass die Abtastpunkte auf der Zeitachse beim Abtasten möglicherweise nicht die Maximalpunkte des analogen Signals erreichen. Wenn wir beispielsweise ein sinusförmiges Signal mit einer Frequenz von 11025 Hz haben und es mit einer Frequenz von 44100 digitalisieren, kann der Spitzenwert des digitalisierten Phonogrammpegels abhängig von der Phasenverschiebung des Punktes von einen Wert von -3 dBFS bis 0 dBFS haben Abtastung auf der Zeitachse. Betritt das Schild. Bei höheren Signalfrequenzen können die Peaks weiter unterschätzt werden.

ITU-R BS.1770-3 (Anhang 2) definiert den Algorithmus zur Berechnung des “True Peak Level”. Das vorgeschlagene Verfahren wird auf das 4-fache Erhöhen der Abtastfrequenz und Filtern reduziert, dann wird die maximale Amplitude aus der Interpolation des erhaltenen Signals ermittelt.

Im Digispot-System können die Spitzenindikatoren im Editor, in den Eigenschaftsfenstern und in den Spleißen den tatsächlichen Schallpegel anzeigen.

Lautstärke
Lautheit ist eine Schätzung der Intensität, mit der der Hörer das Material wahrnimmt. Dieser Wert wird mit einem speziellen Algorithmus berechnet, der die Wahrnehmung des menschlichen Klangs berücksichtigt und von ITU \ ITU-BS.1770 entwickelt wurde.

Die Lautstärke wird in LUFS-Einheiten gemessen, die physikalisch mit Dezibel identisch sind. Die Lautstärke steht in direktem Zusammenhang mit dem Signalpegel: Je höher der Signalpegel, desto höher die Lautstärke.
Numerisch ist diese Beziehung linear: Wenn der Signalpegel um 6 dB ansteigt, erhöht sich auch die Lautstärke um 6 LU. (Um mathematisch genau zu sein, ist die Beziehung nicht linear, aber für die meisten praktischen Anwendungen kann die Abweichung von der linearen Beziehung vernachlässigt werden.)

Die Lautstärkeregelung in Echtzeit erfolgt über Lautstärkeanzeigen, von denen es zwei gibt: M – Momentan und S – Kurzfristig unterscheiden sie sich in den Messintervallen: 0,4 s bzw. 3 s.

Um die Lautstärke eines Schallbereichs zu bewerten, wurde eine spezielle Technik entwickelt, die den Wert der Lautstärke des Bereichs berechnet, der mit dem Wert I bezeichnet und als integrierte Lautstärke bezeichnet wird. Dies ist der Wert, auf den Sie sich beziehen, wenn Sie über die Lautstärke eines Programmierelements oder einer MDL sprechen.

Im Digispot-System wird die integrale Lautstärke des Programmierelements und der MDB einmal berechnet und zur späteren Verwendung, z. B. zur Normalisierung, gespeichert.

In Russland wird die Methode zur Messung des Programmvolumens durch die Anordnung des Antimonopol-Bundesdienstes vom 22. Mai 2015 Nr. 374/15 festgelegt. Die Lautstärke der Programme ist im Bundesgesetz 338 geregelt.

Beziehungen zwischen dem Spitzenpegel des digitalen Audios, dem tatsächlichen Spitzenpegel, der Lautstärke und der Notation
Wenn es um den Signalpegel (genauer gesagt den Spitzenpegel) geht, wird die Notation dBFS – dB Full Scale verwendet. Diese Skala hat einen 0-dB-Punkt, der an den gesamten Bereich des in der verwendeten Bitbreite dargestellten Signals gebunden ist. Bei 16-Bit-Audio-Samples sind die darstellbaren Werte beispielsweise -32768 bis +32767, sodass der Signalpegelwert in dBFS mit 20 lg (s / 32768) berechnet wird, wobei s der Wert von ist die Stichprobe in dieser Darstellung oder der maximale Absolutwert der Stichproben im interessierenden Intervall.

Komprimieren Sie MP3 ohne Qualitätsverlust

Komprimieren Sie MP3 ohne Qualitätsverlust

Mp3

Über verlustfreie Musikkomprimierung, Theorie, Praxis, Schlussfolgerungen.
Mit diesem Material möchte ich eine Reihe von Artikeln mit allem öffnen, was mit dem Hören von Musik auf einem Computer zu tun hat. Es ist an der Zeit, Erfahrungen auszutauschen und unterschiedliche Artikel im Internet in einem zusammenzufassen, obwohl sie nicht präzise, ​​sondern relativ kurz sein sollen. Im ersten Teil sehen wir die Audioformate. Was ist FLAC, WavPack, TAK, Monkeys Audio, OptimFROG, ALAC, WMA, Shorten, LA, TTA, LPAC, MPEG-4 ALS, MPEG-4 SLS, Real Lossless? Wissen Sie, wie viele Arten von Audiodateien heute registriert sind? Bisher beschäftigen wir uns mit verlustfreien Komprimierungsformaten für Audiomaterial, und die Antwort auf die Frage nach der Anzahl der Audioerweiterungen befindet sich am Ende des Artikels. Fröhliches Lesen!

mp3

Definieren wir zunächst die Begriffe:

“Ein Algorithmus ist eine präzise Vorschrift, die den Rechenprozess definiert, der von variablen Eingaben zum gewünschten Ergebnis führt.”

„Codec (Codec in Englisch von Encoder / Decoder – Encoder / Decoder – Encoder / Decoder oder Kompressor / Decompressor) ist ein Gerät oder Programm, das Daten oder Signale konvertieren kann. Codecs können einen Stream / ein Signal (häufig zur Übertragung, Speicherung oder Verschlüsselung) codieren oder dekodieren, um diese für diese Vorgänge anzuzeigen oder in ein geeigneteres Format zu ändern. Codecs werden häufig in der digitalen Video- und Audioverarbeitung verwendet. Die meisten Codecs für Audio- und Videodaten verwenden eine verlustbehaftete Komprimierung, um eine akzeptable endgültige (komprimierte) Dateigröße zu erhalten. Es gibt auch verlustfreie Codecs “.

“Verlustfreie Datenkomprimierung. – Methode zur Datenkomprimierung unter Verwendung codierter Informationen, die in einem Bit wiederhergestellt werden können. Dadurch werden die Originaldaten vollständig aus dem komprimierten Zustand wiederhergestellt. In der Regel hat jeder Typ digitaler Informationen seine eigenen eigene verlustfreie Komprimierungsalgorithmen “.

Die verlustfreie Datenkomprimierung wird verwendet, wenn die Identität der komprimierten Daten mit dem Original wichtig ist. Häufige Beispiele sind ausführbare Dateien, Dokumente und Quellcode. Programme, die verlustfreie Komprimierungsformate verwenden, werden als Archivierer bezeichnet. Jeder kennt die beliebtesten ZIP- oder RAR-Dateiformate, das Unix Gzip-Dienstprogramm usw. Alle diese Programme unterscheiden sich in den angewandten Algorithmen (einem oder mehreren) und daher in den unterschiedlichen Komprimierungseigenschaften verschiedener Dateien.

Teil I. – THEORIE:

Komprimierungsmethoden oder verlustfreie Komprimierungsalgorithmen können nach der Art der Daten klassifiziert werden, für die sie erstellt wurden. Es gibt drei Haupttypen von Daten: Text, Bilder und Ton. Grundsätzlich kann jeder verlustfreie Mehrzweck-Datenkomprimierungsalgorithmus (Mehrzweck bedeutet, dass er jede Art von Binärdaten verarbeiten kann) für jede Art von Daten verwendet werden, aber die meisten von ihnen sind für alle Basistypen ineffizient. Audiodaten können beispielsweise mit einem Textkomprimierungsalgorithmus nicht gut komprimiert werden und umgekehrt.

Zu den Komprimierungsmethoden gehören: Entropiekomprimierung, Wörterbuchmethoden, statistische Methoden. Jede Methode eignet sich für einen bestimmten Datentyp und enthält mehrere Algorithmen.

Entropiekomprimierung: Huffman-Algorithmus Adaptiver Huffman-Algorithmus Arithmetische Codierung (Intervall-Shannon-Fano-Algorithmus) Golomb-Codes Universeller Delta-Code (Elias Fibonacci)

Wörterbuchmethoden: RLE Deflate LZ (LZ77 / LZ78 LZSS LZW LZWL LZO LZMA LZX LZRW LZJB LZT)

Statistische Algorithmusmodelle für Text (oder Text-Binärdaten als ausführbare Datei) umfassen: Burrows-Wheeler-Transformation (Block-Sort-Vorverarbeitung, die die Komprimierung effizienter macht) LZ77 und LZ78 (von DEFLATE verwendet) LZW.