H.264 Profile und Ebenen


Free Download Mp4Gain
picture

H.264 Profile und Ebenen

H.264

Die gemeinsame Gruppe, die an der Definition des H.264-Standards beteiligt ist, hat sich darauf konzentriert, eine einfache und klare Lösung zu schaffen, die Optionen und Parameter minimiert.

H.264

Der wichtigste Aspekt dieses Standards ist, wie bei anderen Videostandards, die Bereitstellung verschiedener Funktionen innerhalb von Profilen (Sätze algorithmischer Parameter) und Ebenen (Leistungsklassen), um beliebte Produkte und gängige Formate optimal zu unterstützen. .

In H.264 gibt es sieben Profile, von denen jedes auf eine bestimmte Anwendung zugeschnitten ist. Jedes Profil bestimmt, welchen Parametersatz der Codierer verwenden kann, und begrenzt die Komplexität der Decodiererimplementierung.

Netzwerkkameras und Videocodierer verwenden wahrscheinlich ein sogenanntes Basislinienprofil, das hauptsächlich für den Einsatz in Bereichen mit begrenzter Rechenleistung entwickelt wurde. Das Basisprofil eignet sich am besten für die Verwendung in modernen Echtzeit-Encodern, die in Netzwerkvideogeräte eingebettet sind. Dieses Profil bietet auch eine geringe Latenz, die eine wichtige Voraussetzung für die Videoüberwachung ist und für die Echtzeitsteuerung von Schwenken, Neigen und Zoomen von Netzwerk-PTZ-Kameras unerlässlich ist.

H.264 verfügt über 11 Stufen oder Einschränkungen in Bezug auf Funktionalität, Bandbreite und Speicheranforderungen. Jede Ebene definiert die Bitrate und Codierungsrate in Makroblöcken pro Sekunde für Auflösungen von QCIF bis HDTV und darüber hinaus. Je höher die Auflösung, desto höher die erforderliche Stufe.


Free Download Mp4Gain
picture

Wie das Video komprimiert wird
Wie das Video komprimiert wird

Video Compression

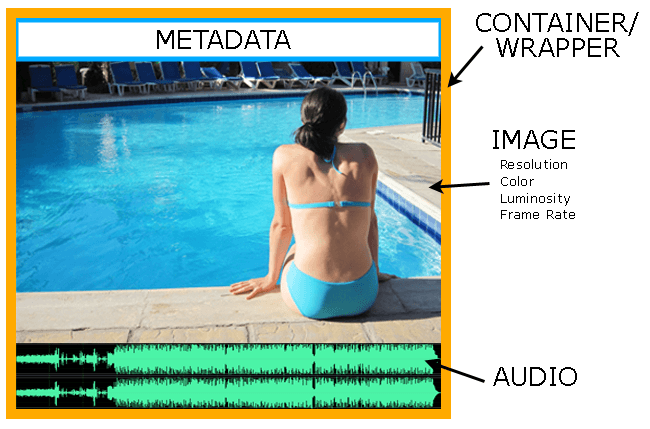
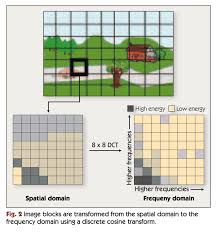
Videokomprimierung ist die Reduzierung und Eliminierung redundanter Videodaten, um die Speicherung und Übertragung digitaler Videodateien zu optimieren.
video compression

Während dieses Vorgangs wird das ursprüngliche Videosignal von einem Algorithmus verarbeitet, um eine komprimierte Datei zu erstellen, die zur Übertragung und Speicherung bereit ist. Verwenden Sie zum Abspielen einer komprimierten Datei

Ein umgekehrter Algorithmus, der tatsächlich das gleiche Videobild wie die ursprüngliche Videoquelle erzeugt. Die Zeit, die zum Komprimieren, Senden, Dekomprimieren und Anzeigen einer Datei benötigt wird, wird als Latenz bezeichnet. Bei gleicher Verarbeitungsleistung ist die Latenz umso höher, je komplexer der Komprimierungsalgorithmus ist.

Einige Algorithmen, die zusammenarbeiten, werden als Video-Codec (Encoder / Decoder) bezeichnet. Videocodecs, die unterschiedliche Standards verwenden, sind häufig nicht miteinander kompatibel.

Tabletten mit einem Standard können nicht mit einem anderen Standard dekomprimiert werden. Beispielsweise funktioniert ein MPEG-4 Part 2-Decoder nicht mit einem H.264-Encoder. Der Grund dafür ist die Tatsache, dass ein Algorithmus das mit der Arbeit eines anderen Algorithmus erzielte Ergebnis nicht korrekt dekodieren kann. Es ist jedoch möglich, Software oder Hardware mit vielen verschiedenen Algorithmen auszustatten, um verschiedene Formate zu komprimieren.

Unterschiedliche Videokomprimierungsstandards verwenden unterschiedliche Methoden, um die Größe der Daten zu reduzieren. Daher unterscheiden sich die Ergebnisse in Bitrate, Qualität und Latenz.

Die Komprimierungsergebnisse können sich auch zwischen Encodern unterscheiden, die denselben Standard verwenden, da der Entwickler des Encoders frei wählen kann, welche standarddefinierten Werkzeugsätze darin verwendet werden sollen. Solange das Ergebnis in der Encoderausgabe dem Format und Decoder des Standards entspricht, sind mehrere Implementierungsmethoden möglich. Dies ist vorteilhaft, da unterschiedliche Implementierungsmethoden unterschiedliche Ziele und unterschiedliche Budgets haben. Professionelle Software-Encoder für optische Nicht-Echtzeit-Medien sollten in der Lage sein, besser codierte Videos bereitzustellen als Hardware-Encoder für in Handheld-Geräte integrierte Echtzeit-Videokonferenzen.

Daher kann ein bestimmter Standard keine bestimmte Datengeschwindigkeit oder -qualität garantieren. Darüber hinaus kann die Leistung eines Standards nicht korrekt mit anderen Standards oder sogar mit unterschiedlichen Implementierungsmethoden desselben Standards verglichen werden, ohne zuvor eine bestimmte Implementierungsmethode definiert zu haben.

Der Decodierer muss im Gegensatz zum Codierer alle notwendigen Elemente des Standards implementieren, um den entsprechenden Bitstrom zu decodieren. Daher legt der Standard klar fest, wie genau der Dekomprimierungsalgorithmus jedes Bit des komprimierten Videobildes abrufen soll.

Die folgende Tabelle vergleicht die Bitrate bei gleicher Bildqualität für die folgenden Videostandards: Motion JPEG, MPEG-4 Teil 2 (ohne Bewegungskompensation), MPEG-4 Teil 2 (Bewegungskompensation) und H. 264 (Grundlinienprofil).

Für die ausgewählte Folge von Videobildern erzeugt der H.264-Codierer bis zu 50% weniger Bits pro Sekunde als der bewegungskompensierte MPEG-4-Codierer. Der H.264-Encoder ist mindestens dreimal effizienter als ein MPEG-4-Encoder ohne Bewegungskompensation und mindestens sechsmal effizienter als Motion JPEG.

Videokodierung, wie es funktioniert (Teil 2)

Videokodierung, wie es funktioniert (Teil 2)

video encoding

Bisher haben wir nur über Bildkomprimierung gesprochen. Ein vollständiges Video beinhaltet jedoch auch eine Audiokomponente. Es wird angenommen, dass Sound in CD-Qualität mit 44,1 kHz und 16 Bit pro Kanal digitalisiert werden muss, was 706 Kbit / s pro Kanal entspricht (1,4 Mbit / s für Stereo). Die Qualität des DAT-Signals bestimmt die Abtastrate von 48 kHz (Frequenzband 4-24000 Hz) und erhöht den Stream auf 768 Kbit / s pro Kanal.

Video Encoding


Der Ansatz der Informationskomprimierung ist der gleiche: Verwerfen des Teils, der für das menschliche Ohr nicht sehr wichtig ist. Der MPEG-Standard ermöglicht 3 Ebenen der Audiokomprimierung. Schicht 1 verwendet den einfachsten Algorithmus mit minimaler Komprimierung, wobei 192 Kbit / s pro Kanal angenommen werden. Der Layer 2-Algorithmus ist komplexer, aber die Komprimierungsrate ist höher und beträgt nur 128 Kbit / s pro Kanal. Ein leistungsstarker digitaler Audiokomprimierungsalgorithmus in CD-Qualität (11-mal verlustfrei vom menschlichen Ohr unterscheidbar) Layer 3 bietet die höchstmögliche Klangqualität bei strengen Übertragungsbeschränkungen – nicht mehr als 64 Kbit / s pro Kanal. Es ist in erster Linie für das Internet gedacht. Seine Bedeutung ist so groß, dass es eine spezielle Abkürzung MP3 erhalten hat, die für MPEG Layer 3 steht. Es gibt viele Internetseiten, die Hunderttausende von MP3-Dateien mit populärer Musik enthalten. Mit Hilfe spezieller Wiedergabeprogramme (Real Audio) kann MP3-Musik in Echtzeit über das Internet angehört, unbegrenzt kopiert (beachten Sie, dass ein typischer Song 2-8 MB groß ist) und illegal verbreitet werden. Es gibt bereits tragbare MP3-Player zum Preis von rund 200 US-Dollar (wie den Diamond Rio). Die Musikindustrie begann mit spürbaren Verlusten einen aktiven Kampf gegen MP3-Sites (die Recording Industry Association of America fand und schloss die meisten von ihnen). Aber der Gin ist raus, man kann nicht jeden schließen. Adaptec prognostiziert, dass in den kommenden Jahren Milliarden von Songs aus dem Internet heruntergeladen werden, und kündigt MP3-Unterstützung in der nächsten Version von EasyCD Creator an. Bei digitalen Bearbeitungsaufgaben wird die Audiosignalkomprimierung jedoch nicht verwendet. Daher ist es bei zulässigen Stream-Berechnungen erforderlich, der Audiokomponente bis zu 1,5 Mbit / s zuzuweisen.

MPEG2 für nichtlineare Bearbeitungsaufgaben

Der Begriff nichtlineare Bearbeitung entspricht nicht dem Wesen des Prozesses, sondern spiegelt nur eine seiner Eigenschaften wider. In der Tat sprechen wir über Videobearbeitung, die in digitalem Format auf Computern durchgeführt wird. In diesem Fall müssen die Originalvideoclips in Form entsprechender Dateien digitalisiert und auf der Festplatte aufgezeichnet werden. Im Gegensatz zu Bandlaufwerken erfordert der Zugriff auf eine dieser fragmentierten Dateien kein langwieriges Zurückspulen (und dieser Vorgang ist linear), sodass alle Videobilder in zufälliger Reihenfolge verfügbar sind. Diese wichtige Eigenschaft führte dazu, dass die digitale Bearbeitung als nichtlinear bezeichnet wurde, obwohl die Möglichkeiten der digitalen Verarbeitung offensichtlich viel breiter und umfangreicher sind.

Denken Sie daran, dass ein Fernsehbild gemäß der Empfehlung ITU-R BT.601 eine 720×576-Matrix ist. Unter Berücksichtigung der Fernsehbildrate von 25 Hz schließen wir, dass eine Sekunde digitales Video in 4: 2: 2-Darstellung 25 x 2 x 720 x 576 = 20.736.000 Byte erfordert, dh der Datenstrom beträgt 21 MBit / s. Das Aufzeichnen dieser Streams ist technisch machbar, aber schwierig, teuer und hinsichtlich der Nachbearbeitung ineffizient. Die tatsächlichen Möglichkeiten der Praxis erfordern eine erhebliche Reduzierung der Flüsse. Es ist bekannt, dass viele Algorithmen eine verlustfreie Komprimierung durchführen, aber selbst die effektivsten bieten bei typischen Bildern nicht mehr als die doppelte Komprimierung.

Bis vor kurzem war M-JPEG in der Welt der nichtlinearen Videobearbeitungssysteme führend. Die verschiedenen Lösungen unterschieden sich im Grad der Komprimierung, was unterschiedlichen Qualitätsstufen des resultierenden Videos entsprach. Unter bestimmten Bedingungen können hier 4 Ebenen unterschieden werden: Standardvideo (VHS, C-VHS, Video8), Supervideo (SVHS, C-SVHS, Hi8), Digitalvideo (Betacam SP, DV / DVCAM / DVCPRO, Mini) -DV, Digital8) und Studio Video (Digital-S, DVCPRO50). Der Einfachheit halber werden wir sie im Folgenden als Video, S-Video, DV und Studio-TV bezeichnen. Quantitativ sind sie im Allgemeinen durch eine horizontale Auflösung gekennzeichnet (die Anzahl der unterscheidbaren Elemente in einer Zeile: Fernsehleitungen). Video bietet eine Auflösung von bis zu 280 Zeilen und entspricht einem MJPEG-Stream von ca. 2 MBit / s.

MPEG-1 Audio Layer II

MPEG-1 Audio Layer II

MP3 (MPEG-1 Audio Layer III

MPEG-1 Audio Layer II oder MPEG-2 Audio Layer II (MP2, manchmal fälschlicherweise als Musicam oder MUSICAM bezeichnet) ist ein verlustbehaftetes Audiokomprimierungsformat, das von ISO / IEC 11172-3 in Verbindung mit MPEG-1 Audio Layer I definiert wird und MPEG Audio Layer -1 III (MP3). Während MP3 für PC- und Internetanwendungen viel beliebter ist, ist MP2 immer noch der dominierende Standard für das Streamen von Audio.

MP3

Entwicklungsgeschichte von MP2 bis MP3

Die MPEG-1-Audio-Layer-2-Codierung wurde von MUSICAM (Maskierungsmuster, angepasst durch Universal Subgroup Integrated Coding And Multiplexing) abgeleitet, einem Audio-Codec, der vom CCETT (Centre Commun D’études de Télévision et Télécommunications), Philips und Institut für entwickelt wurde Rundfunktechnik (IRTfunktechnik) im Jahr 1989 im Rahmen der europaweiten zwischenstaatlichen Forschungsinitiative EURECA 147 zur Entwicklung eines Audio- und Datenübertragungssystems für feste, tragbare oder mobile Empfänger (gegründet 1987).

MPEG-Audio

In den späten 1980er Jahren begann die Moving Picture Experts Group (MPEG) von ISO mit der Standardisierung der digitalen Video- und Audiokodierung, die voraussichtlich eine breite Palette von Anwendungen im digitalen Radio- und Fernsehsendungsbereich haben wird ( später TOUCH, DMB, DVB) und Verwendung auf CD-ROM (später Video-CD). Die MUSICAM-Audiokodierung war einer von 14 Vorschlägen für den MPEG-1-Audiostandard, die 1989 an ISO ausgeliefert wurden.

Der MPEG-1-Audiostandard basierte auf den vorhandenen Audioformaten MUSICAM und ASPEC.

Der MPEG-1-Audiostandard umfasste drei Audio- “Schichten” (Codierungstechniken), die jetzt als Schicht I (MP1), Schicht II (MP2) und Schicht III (MP3) bekannt sind.

Alle Algorithmen für MPEG-1 Audio Layer I, II und III wurden 1991 vom ISO 11172-Komitee als Entwurf genehmigt und 1992 als Teil von MPEG-1, dem ersten Satz von MPEG-Standards, der zum internationalen ISO-Standard führte, fertiggestellt. / IEC 11172-3 (auch bekannt als Audio MPEG-1 oder Teil 3, MPEG-1), veröffentlicht 1993. Weitere Arbeiten zu MPEG-Audio wurden 1994 als Teil des zweiten Satzes von MPEG-Standards, MPEG-2, formeller abgeschlossen bekannt als Internationaler Standard ISO / IEC 13818-3 (auch bekannt als MPEG-2 Part 3 oder MPEG-2 Audio abwärtskompatibel oder MPEG-2 BC Audio), ursprünglich 1995 veröffentlicht. MPEG-2 Part 3 (ISO / IEC 13818 -3) definierte zusätzliche Bitraten und Abtastraten für MPEG-1 Audio Layer I, II und III. Die neuen Abtastraten sind genau die Hälfte der ursprünglich für MPEG-1 Audio angegebenen. MPEG-2 Teil 3 erweiterte auch MPEG-1-Audio, sodass Audioprogramme mit mehr als zwei Kanälen in 5.1-Mehrkanal codiert werden können.

Component Layer III (MP3) verwendet einen verlustbehafteten Komprimierungsalgorithmus, der entwickelt wurde, um die Datenmenge, die für die Präsentation einer Audioaufnahme erforderlich ist, drastisch zu reduzieren und für die meisten Hörer eine anständige Wiedergabe des unkomprimierten Original-Audios zu sein.