Wie kann man Dosensound schmackhafter machen? – Über Audiokomprimierung und -codierung sprechen Teil 2


Free Download Mp4Gain
picture

Wie kann man Dosensound schmackhafter machen? – Über Audiokomprimierung und -codierung sprechen Teil 2

audio compression

SMR (Signal-to-Maskratio): bezieht sich auf den Abstand von der Maskierungskurve zu der durch die Maskierung erzeugten Schwelle innerhalb eines kritischen Frequenzbands.
audio compression

SNR (Signal-Rausch-Verhältnis): bezieht sich auf das Signal-Rausch-Verhältnis des Signals nach der Quantisierung von m Bits, das gleich dem Verhältnis der Varianz des Signals vor der Quantisierung zur Varianz des Quantisierungsrauschens ist.

MNR (mask-to-noise): bezieht sich auf die Verzerrung, die das menschliche Ohr nach der Verarbeitung wahrnehmen kann. Der Wert ist gleich der Differenz zwischen SNR und SMR.

Der graue Bereich Critical Band bezieht sich auf das kritische Band, Masking Threshold ist die Maskierungsschwellenkurve und SMR in der Abbildung bezieht sich auf den maximalen Wert von SMR im kritischen Band.

Es ist erwähnenswert, dass die oben diskutierten SMR, SNR und NMR alle auf kritischen Bändern basieren, aber der Maskierungseffekt beeinflusst nicht nur ihre eigenen kritischen Bänder, sondern auch benachbarte kritische Bänder, was als Duktilität bezeichnet wird; Die Abbildung zeigt eine Kurvenmaskierung in einem kritischen Frequenzband; Was die tatsächliche Situation betrifft, gibt es oft mehrere Maskierungskurven, dh polyphone Maskierungskurven. Diese Maskierungskurve kann als Überlagerung der jedem Grundton entsprechenden Maskierungskurven betrachtet werden. . Für spezifischere Inhalte in diesem Teil siehe Bücher zur Psychoakustik.

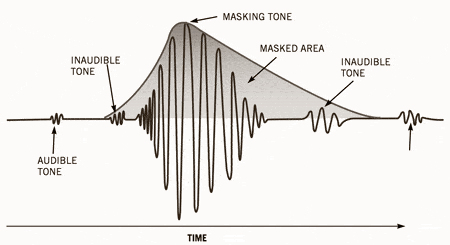
“Zeitmaskierung” bedeutet, dass ein lauter Ton vor oder nach einem schwachen Ton erscheint und der lauteste Ton zu diesem Zeitpunkt maskiert wird. Der Hauptgrund für die zeitliche Maskierung ist, dass das menschliche Gehirn eine gewisse Zeit benötigt, um die Informationen zu verarbeiten. Die spezifische Wirkung dieses Phänomens kann in diesem Bild gezeigt werden.

Abbildung 3: Schematische Darstellung der Zeitmaskierung, man sieht unterschiedliche Maskierungseffekte, die durch unterschiedliche Schallemissionszeiten verursacht werden

Ein weiteres wichtiges Konzept für Kompressionsalgorithmen ist die “kritische Bandbreite” der Maskierung: Harvey Fletcher führte ein Experiment [3] durch, um die Wirkung von Rauschbändern auf die Tonhöhenmaskierung zu entdecken. In Experimenten hat das Signal mit fester Tonhöhe verschiedene darauf zentrierte Rauschbandbreiten. Ihre Forschung zeigt, dass die kritische Bandbreite des Rauschens den größten Maskierungseffekt erzeugt und dass Energie außerhalb dieses Bandes die Maskierung nicht beeinflusst. Dies kann durch ein Hörsystem mit einem Hörfilter erklärt werden, das auf die Tonhöhenfrequenz fokussiert ist. Die Bandbreite des Maskierers innerhalb dieses Hörfilters maskiert effektiv den Ton, aber der Teil des Maskierers außerhalb des Filters hat keine Wirkung.

Dieser Effekt kann in einigen Komprimierungsalgorithmen verwendet werden, um die Gesamtdatenmenge zu reduzieren, indem die Genauigkeit der Darstellung eines Teils des Signals außerhalb der kritischen Bandbreite verringert wird (beachten Sie, dass allgemeine Algorithmen wie MP3 maskierten Ton nicht vollständig ausschließen, stattdessen reduzieren sie die Genauigkeit der maskierten Tongenauigkeit, um unnatürlichen Ton zu vermeiden).

Abbildung 4: Schematische Darstellung des Maskierungseffekts, die den Zusammenhang zwischen kritischer Bandbreite (Critical Bandwidth) und Frequenz (Signal Tone) zeigt

Hörschwelle

Die unter bestimmten Bedingungen minimale Hörintensität, bei der der Proband mehr als die Hälfte der im Test bereitgestellten multiplen Stimulussignale wahrnehmen kann, wird als Hörschwelle bezeichnet [4]. Die in der Abbildung dargestellte „Hörschwelle“ ist die minimale Schallintensität, die der Mensch bei der entsprechenden Frequenz wahrnehmen kann. Einige Komprimierungscodierungsformate entfernen Frequenzpunkte unterhalb der Hörschwelle, um eine Audiodatenkomprimierung durchzuführen.

Free Download Mp4Gain
picture

Wie kann man Dosensound schmackhafter machen? – Apropos Komprimierung und Audiocodierung

Wie kann man Dosensound schmackhafter machen? – Apropos Komprimierung und Audiocodierung

audio masking perception

Letztes Mal habe ich darüber gesprochen [Wie kann man Konserven leckerer klingen lassen? ——Eine kurze Rede über Audiokomprimierung und -codierung (Teil 1) ] besteht die Hauptaufgabe des Audiokomprimierungsalgorithmus darin, den Teil der Frequenz außerhalb des Bereichs des menschlichen Ohrs und den Teil zu komprimieren, der für den Menschen “ineffizient” ist Wahrnehmung Was wir für diese Inhalte wissen müssen: auditive Maskierungseffekte

audio masking perception

auditiver Maskierungseffekt

1894 berichtete der amerikanische Physiker Alfred M. Mayer, dass ein Ton durch einen anderen Ton niedrigerer Frequenz maskiert werden kann. 1959 beschrieb Richard Ehmer einen vollständigen Satz von Hörkurven für dieses Phänomen. Zwischen 1967 und 1974 arbeitete Eberhard Zwicker auf dem Gebiet der Abstimmung und Maskierung von Schlüsselfrequenzbändern. Auditive Maskierungseffekte können in “gleichzeitige Maskierung” und “temporäre Maskierung” unterteilt werden.

“Simultaneous Masking” bezieht sich auf das Phänomen, dass zwei Töne mit unterschiedlichen Frequenzen gleichzeitig abgespielt werden. Aufgrund der Eigenschaften der menschlichen Schallwahrnehmung wird ein schwächeres Signal durch ein anderes Signal maskiert. Zusammenfassend hat die Reintonmaskierung die folgenden Eigenschaften: Bässe sind leicht von Höhen zu maskieren, und Höhen sind schwieriger von Bässen zu maskieren; reine Töne mit ähnlichen Frequenzen können sich leicht gegenseitig maskieren; Wenn der Schalldruckpegel des maskierten Tons ansteigt, steigt die Maskierungsschwelle und der maskierte Ton nimmt zu. Der Frequenzbereich wird erweitert. Hier ist ein schematisches Diagramm, um dieses Phänomen zu beschreiben

Wie in den Abbildungen gezeigt, maskiert der Maskierungseffekt Signale bei ungefähr 0,7 kHz, 1,6 kHz und 2,3 kHz, wobei der SPL des 0,7-kHz-Signals unter der Hörschwelle liegt und ohne Maskierung nicht gehört werden kann.

Auf dieser Grundlage werden drei wichtige Konzepte SMR, SNR und MNR eingeführt. gegenseitige Beziehung

MP3-Audioverstärker – MP4-Lautstärkeverstärker

MP3-Audioverstärker – MP4-Lautstärkeverstärker

Mp3 audio booster

Die Notwendigkeit, einen Audio-Booster in eine MP3- oder MP4-Datei umzuwandeln, tritt sehr häufig auf.

Mp4 volume booster

Lautstärke-Booster

Wir leben in einer Zeit, in der Audio- und Videogeräte immer leistungsfähiger und leistungsfähiger werden. High Fidelity ist heute kein Werbeslogan. Auf vielen Computern können wir jeden Ton der Aufnahme anhören. Daher nehmen wir auch minimale Mängel wahr, z. B. bei unterschiedlichen Lautstärken, Audios und Videos mit unterschiedlicher Lautstärke, ungleichen und ungleichmäßigen Lautstärkezuwächsen.

Ungleichmäßige Lautstärken bei MP3s

Dieses Szenario, das heute auch in den Bereich von mp4 und anderen Videoformaten führt, ist etwas, das nur eine Lösung hat:

Mp4Gain ist die einzige Software, die diese ungleichmäßigen Lautstärken wirklich korrigieren kann.

Mp4Gain verfügt über ausgeklügelte und hochentwickelte Algorithmen, mit denen Sie die Qualität und Lautstärke einer Audio- und Videodatei wie nie zuvor verbessern können.

Sie können nicht nur Dinge wie Bitrate, Abtastrate, Lautstärke und Lautstärkewahrnehmung abgleichen. sondern auch der Ausgleich.

Mp4Gain wird in professionellen Schränken und auch von Musikliebhabern verwendet, die es zu Hause für ihre mp3, mp4 usw. verwenden.

Mp4Gain ist heutzutage der beste Audio-Normalisierungsalgorithmus.

Wie MP3s Ihre Ohren täuschen. Teil 2

Wie MP3s Ihre Ohren täuschen. Teil 2

mp3 human perception

Normalerweise ist die Komprimierung, die wir verstehen, eine wiederholte Komprimierung.

MP3 HUMAN PERCEPTION

Wenn Sie zum Beispiel in den Supermarkt gehen, um 5 Flaschen Coca-Cola zu kaufen, steht auf der Quittung nicht 5 Mal Coca-Cola, sondern nur „Coca-Cola*5“. Dieser Vorgang entspricht der Codierung der wiederholten Teile der Datei mit kürzeren Bytes. Die Datei selbst verliert weder Daten noch Informationen nach der Dekodierung, aber die Dateigröße wird reduziert.

Dies ist ein verlustfreier Druckabfall, der eigentlich der letzte MP3-Schritt ist, der einen Algorithmus namens Huffman-Codierung verwendet, um ihn abzuschließen. Aber wenn nur dieser Algorithmus verwendet wird, wird die MP3-Größe nicht wesentlich reduziert.

Denn Schall selbst sind extrem chaotische Daten mit sehr hoher Informationsentropie. Auf diese Weise ist es also unmöglich, es auf 10 % der Lautstärke der CD zu reduzieren.

Da eine verlustfreie Komprimierung nicht mehr praktikabel ist, sollten wir einige Informationen wegwerfen.

Welcher Sound fehlt dem MP3?

Der einfachste Weg, die Antwort zu erfahren, ist zu vergleichen.

Wir legen eine MP3 mit dem gleichen Sound und seiner verlustfreien Version nebeneinander auf zwei Spuren und invertieren eine der Spuren, sodass sie sich gegenseitig aufheben, wenn sie gleich klingen, und wir einen Mute-Effekt erhalten sollten. So funktionieren auch Noise-Cancelling-Kopfhörer.

Aber weil MP3 eine verlustbehaftete Komprimierung ist, hört es sich eigentlich so an:

Aber nur dann können wir den Unterschied zwischen MP3 und Lossless nicht erkennen. Wenn ein Musikstück ständig zwischen MP3 und verlustfrei wechselt, können Sie wirklich den Unterschied erkennen? Ich glaube, man kann es nicht hören.

Das ist die Magie des MP3-Algorithmus, seine Komprimierung besteht nicht nur darin, die Tondaten zu verlieren, sondern gleichzeitig die Daten zu verlieren, Sie können es nicht bemerken.

Die Geschichte der MP3

Die Geschichte von Brandenburg und Dieter Seitzer

Ende der 1970er-Jahre hatte plötzlich ein deutscher Professor namens Dieter Seitzer eine Idee. Er wollte, dass die Leute zu Hause sitzen, eine ISDN-Telefonleitung nutzen und auf Abruf telefonieren und Musik abspielen können, wie eine Jukebox.

ISDN war zu dieser Zeit eine beliebte digitale Leitung, auch “Single Line Communication” genannt, Sie können damit telefonieren, Faxe senden und empfangen usw., aber seine Geschwindigkeit beträgt nur 128 kbps.

Als Dieter die Idee patentieren ließ, sagten ihm die Mitarbeiter des Patentamts, sie sei nicht gut. Sofern man die Geschwindigkeit des ISDN-Netzes nicht um das Zwölffache steigern kann, reicht das aus, um die Datenmenge einer CD zu übertragen.

Als Dieter es hörte, konnte er es wahrscheinlich nicht alleine, aber wenn er ein Audioformat erfand, das nur 1/12 der Größe einer CD hatte, wäre er dann nicht in der Lage, diese „digitale Jukebox“ herzustellen? Also drehte er um und übergab die Erfindung einem seiner Schüler, Karlheinz Brandenburg.