Audiokomprimierung, wie es funktioniert Teil 2


Free Download Mp4Gain
picture

Audiokomprimierung, wie es funktioniert Teil 2

Audio compression

Redundante Informationen für Übertragungssignale
Audio compression

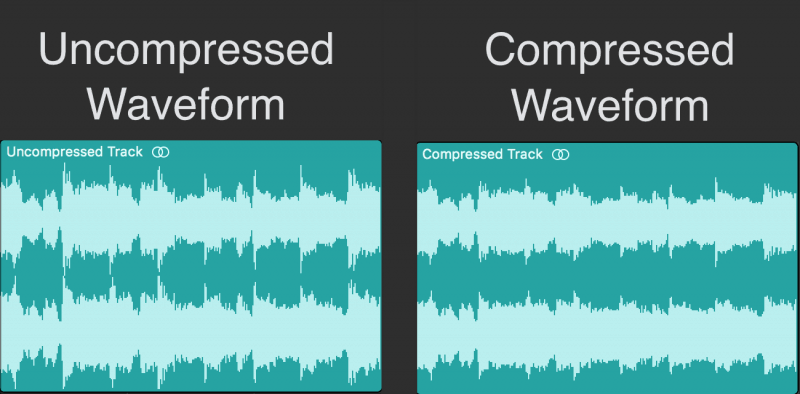
Die digitale Audiokompressionscodierung komprimiert das Audiodatensignal so weit wie möglich unter der Prämisse sicherzustellen, dass das Signal nicht hörbar verzerrt wird. Die digitale Audiokompressionscodierung wird implementiert, indem redundante Komponenten in Tonsignalen entfernt werden. Sogenannte redundante Komponenten beziehen sich auf Signale im Audio, die vom menschlichen Ohr nicht wahrgenommen werden können und nicht dazu beitragen, die Klangfarbe, Tonhöhe und andere Informationen des Klangs zu bestimmen. Redundante Signale umfassen Audiosignale außerhalb des Bereichs des menschlichen Gehörs und maskierte Audiosignale. Beispielsweise beträgt der vom menschlichen Ohr wahrnehmbare Frequenzbereich des Schallsignals 20 Hz bis 20 KHz, und andere Frequenzen als diese Frequenz, die vom menschlichen Ohr nicht wahrgenommen werden können, können als redundante Signale betrachtet werden. Außerdem wird gemäß den physiologischen und psychoakustischen Phänomenen des menschlichen Ohrs, wenn ein starkes Signal und ein schwaches Signal gleichzeitig vorhanden sind, das schwache Signal durch das starke Signal maskiert und kann nicht gehört werden, so dass das schwache Signal sein kann als redundantes Signal angesehen. Nicht senden. Dies ist der Maskierungseffekt des menschlichen Gehörs, der sich hauptsächlich in dem spektralen Maskierungseffekt und dem Zeitbereichsmaskierungseffekt manifestiert, die im Folgenden dargestellt werden:
Spektrale Maskierungseffekte.
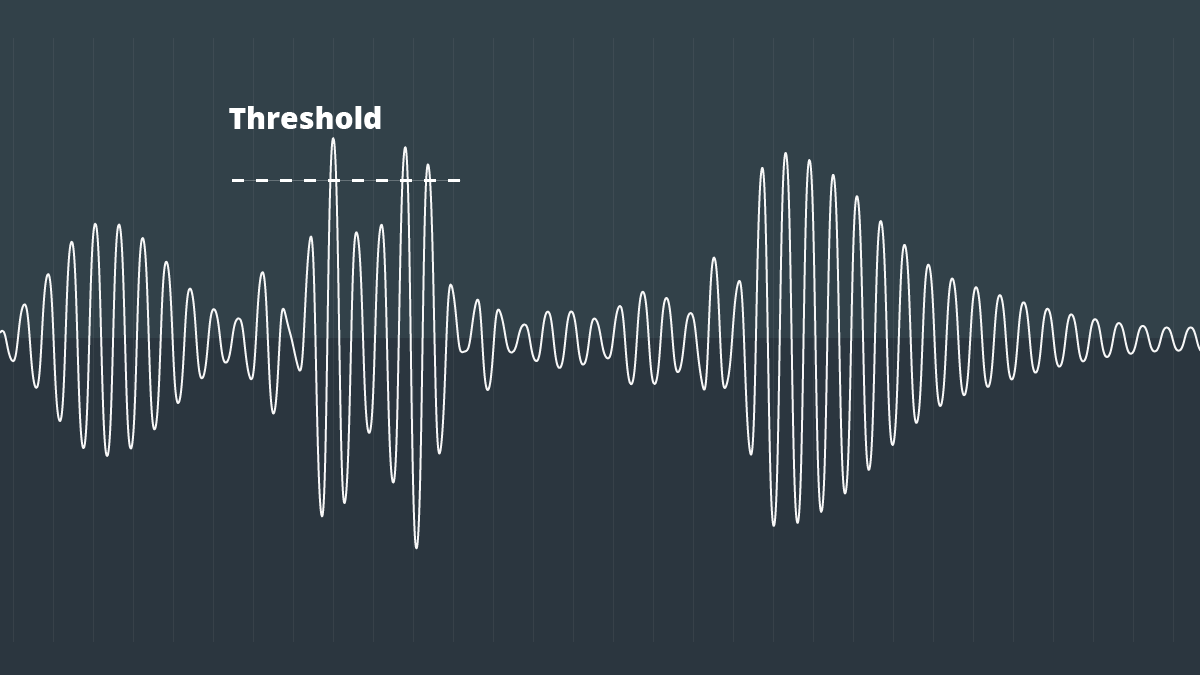
Nachdem die Schallenergie einer Frequenz unter einer bestimmten Schwelle liegt, wird sie vom menschlichen Ohr nicht mehr gehört, und diese Schwelle wird als minimale hörbare Schwelle bezeichnet. Wenn ein anderer Ton mit höherer Energie auftritt, erhöht sich der Schwellenwert nahe der Frequenz des Tons erheblich, was als Maskierungseffekt bekannt ist.

Maskierungseffekte im Zeitbereich.
Beim gleichzeitigen Auftreten von starken und schwachen Signalen kommt es auch im Zeitbereich zu einem Maskierungseffekt. Das heißt, wenn die beiden zeitlich sehr nahe beieinander liegen, tritt auch der Maskierungseffekt auf. Die Zeitdomänenmaskierung ist in drei Teile unterteilt: Vormaskierung, simultane Maskierung und Nachmaskierung. Vormaskierung bezieht sich auf die kurze Zeit, bevor das menschliche Ohr ein starkes Signal hört, das bereits vorhandene schwache Signal wird maskiert und kann nicht gehört werden. Gleichzeitige Maskierung bedeutet, dass bei gleichzeitigem Vorhandensein eines starken und eines schwachen Signals das schwache Signal durch das starke Signal maskiert wird und nicht gehört werden kann. Post-Masking bedeutet, dass es lange dauert, bis das schwache Signal wieder zu hören ist, wenn das starke Signal verschwindet, was als Post-Masking bezeichnet wird. Diese schwach maskierten Signale können als redundante Signale betrachtet werden.


Free Download Mp4Gain
picture

Audiokomprimierung, wie es funktioniert

Audiokomprimierung, wie es funktioniert

Audio compression

Audiokomprimierung

audio compression


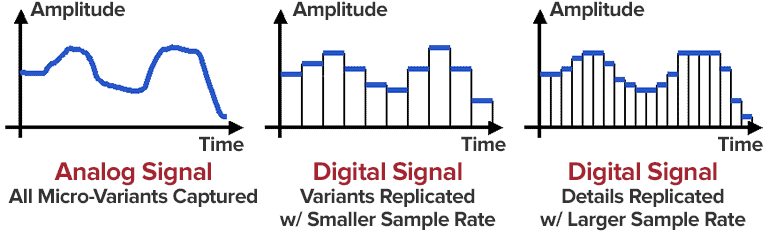
Die Audiokomprimierungstechnologie bezieht sich auf die Anwendung einer geeigneten digitalen Signalverarbeitungstechnologie auf den ursprünglichen digitalen Audiosignalstrom (PCM-Codierung), ohne die Menge nützlicher Informationen zu verlieren, oder unter der Bedingung, dass der eingeführte Verlust unbedeutend ist, seinen Code zu reduzieren (komprimieren). Rate und wird auch als Komprimierungscodierung bezeichnet.

Es muss eine entsprechende inverse Transformation haben, die als Dekomprimierung oder Dekodierung bezeichnet wird. Das Audiosignal kann viel Rauschen und einige Verzerrungen einführen, nachdem es ein Codec-System durchlaufen hat

Die Audiokomprimierungstechnologie bezieht sich auf die Anwendung einer geeigneten digitalen Signalverarbeitungstechnologie auf den ursprünglichen digitalen Audiosignalstrom (PCM-Codierung), ohne die Menge nützlicher Informationen zu verlieren, oder unter der Bedingung, dass der eingeführte Verlust unbedeutend ist, wodurch seine Coderate reduziert (komprimiert) wird , und wird auch als Komprimierungscodierung bezeichnet. Es muss eine entsprechende inverse Transformation haben, die als Dekomprimierung oder Dekodierung bezeichnet wird. Audiosignale können nach dem Passieren eines Codec-Systems viel Rauschen und einige Verzerrungen einführen. Die Vorteile des digitalen Signals liegen auf der Hand, aber es hat auch seine eigenen entsprechenden Nachteile, dh erhöhte Speicherkapazitätsanforderungen und erhöhte Kanalkapazitätsanforderungen während der Übertragung. Bei einer CD als Beispiel beträgt die Abtastfrequenz 44,1 kHz und die Quantisierungsgenauigkeit 16 Bit, sodass ein Stereo-Audiosignal für 1 Minute etwa 10 MB Speicherkapazität belegen muss, dh nur die Kapazität eines CD-Plattenspielers etwa 1 Stunde. Natürlich ist das Problem in der Welt von digitalem Video mit viel höherer Bandbreite sogar noch ausgeprägter. Sind all diese Bits notwendig? Die Studie ergab, dass es eine große Redundanz bei der direkten Verwendung des PCM-Codestroms für die Speicherung und Übertragung gibt. Tatsächlich kann Ton unter verlustfreien Bedingungen auf mindestens 4:1 komprimiert werden, dh nur 25 % der digitalen Menge werden verwendet, um alle Informationen zu erhalten, und das Komprimierungsverhältnis im Videobereich kann sogar mehrere hundert Mal betragen. Daher hat die Komprimierungstechnologie seit ihrer Einführung viel Aufmerksamkeit erhalten, um begrenzte Ressourcen zu verwenden. Die Erforschung und Anwendung der Audiokomprimierungstechnologie hat eine lange Geschichte, wie die A-Law-Codierung ist u-Law eine einfache, fast sofortige Komprimierungstechnologie und wurde bei der ISDN-Sprachübertragung angewendet. Die Erforschung von Sprachsignalen wurde zuvor entwickelt und ist ausgereift und weit verbreitet, wie z. B. adaptive differentielle PCM (ADPCM), lineare prädiktive Codierung (LPC) und andere Technologien.

In welchem ​​Format und mit welcher Qualität ist Musik im Radio zu hören?

In welchem ​​Format und mit welcher Qualität ist Musik im Radio zu hören?

Radio most used audio file formats

Tatsächlich können wir sagen, dass es derzeit zwei Haupt-Audioformate gibt: verlustbehaftet (komprimiert) und verlustfrei (unkomprimiert). Sie werden in viele Typen eingeteilt.

Radio audio file formats

Lossy benötigt weniger Speicherplatz, beeinträchtigt jedoch die Qualität der Audiospur. Bei der Komprimierung mit dem MPEG-Protokoll (daher der Name mp3 – mp4 für Dateien mit Videosequenzen) werden die für das Ohr kaum wahrnehmbaren Farbtöne und Übergangstöne abgeschnitten. Dies macht die Datei klarer, verschlechtert sie aber auch. Der letzte Platz wird von der Bitrate dieser Datei belegt: der Grad der Komprimierung jeder Sekunde der Audiospur. Je niedriger die Bitrate, desto weniger Speicherplatz nimmt die Datei ein und desto schlechter ist die Qualität. Eine Komposition von drei Minuten in MP3 mit einer Bitrate von 320 Kilobit pro Sekunde belegt somit bis zu 3 Megabyte auf der Festplatte. Eine ähnliche Zusammensetzung mit einer Bitrate von 96 Kilobit belegt etwa 400 Kilobyte.

Lossless kommt dem ursprünglichen analogen Sound * so nahe wie möglich und ist daher bei Toningenieuren sehr beliebt. Verlustfreie Formate beanspruchen sogar im Vergleich zu mp3-320 viel mehr Speicherplatz. Unter diesen Formaten sind WAV (Standard), FLAC (wirtschaftlich) und AIFF (Apple) am häufigsten. Ersteres wird am häufigsten verwendet.

Professionelle Tonaufnahmen werden nur im unkomprimierten Format durchgeführt. Nur mit ihm arbeiten Toningenieure.

Im Radio ist die Situation etwas komplizierter. Dies ist auf die Besonderheiten der Arbeit der Medien zurückzuführen, nämlich Effizienz und wirtschaftliche Rentabilität. Die Verwendung von Servern mit hoher Kapazität ist teuer und daher codieren die meisten Radiosender Audiospuren im MP3-Format mit einer Bitrate von 256 Kilobit pro Sekunde. Dies ist jedoch hauptsächlich für nationale Sender typisch. Aus dem Ausland gekaufte Geräte verfügen über Standardkonfigurationen, die eine WAV-Codierung voraussetzen.

Warum konzentrieren sich Softwareentwickler auf WAV? Weil sich das Funksignal nicht störungsfrei ausbreiten kann. Daher empfängt der Hörer immer noch ein kleines und manchmal erheblich verzerrtes Signal. Rundfunkveranstalter stehen daher vor einer vernünftigen Frage: Welche Klangqualität wird der Hörer am besten wahrnehmen: verzerrtes Ideal oder verzerrte Verzerrung? Aus diesem Grund wird in Europa und den USA der WAV-Standard (AIFF, wenn die Station mit Apple-Geräten betrieben wird) in Russland übernommen – MP3 mit einer Bitrate von 256 Kilobit pro Sekunde.

Die analoge Datenübertragung basiert auf den physikalischen Eigenschaften von Schall. Der Wiedergabemechanismus basiert auf den Prinzipien der menschlichen Hörwahrnehmung. Das heißt, die Schallwelle vibriert die Membran (in Analogie zum Trommelfell des Ohrs) und wird mit einer Nadel im Träger in der Form fixiert, in der sie erhalten wurde. Wiedergabe daher auch ohne Abweichungen und Änderungen im Zusammenhang mit der digitalen Konvertierung.

Die Kategorie Audiodateien umfasst komprimierte und unkomprimierte Audioformate, die ein Datensignal enthalten und von Audioprogrammen abgespielt werden können. Diese Kategorie umfasst auch MIDI-Dateien, Musikpartituren und Audioprojektdateien, die im Allgemeinen keine Audiodaten enthalten.

Die häufigsten Erweiterungen sind .WAV, .AIF, .MP3 und .MID.

Verlustbehaftete Audiokomprimierung

Verlustbehaftete Audiokomprimierung

MP3: Lossy compression

Ich beginne mit dem bekannten und weit verbreiteten (wenn auch nicht immer geliebten) MP3-Format.

Lossy audio format

Dieses Audioformat wird überall und überall aktiv verwendet, wo es benötigt wird und wo es nicht benötigt wird. Dies bedeutet jedoch nicht, dass es des Platzes, den es in seiner Nische einnimmt, nicht würdig ist. Sehr würdig. Obwohl er seit ungefähr zwei Jahrzehnten in seiner Nische “sitzt”, hat ihn noch niemand “rausgeschmissen”. Und es gab viele, die es sagen wollten. Und der Hauptfavorit von ihnen ist WMA (Windows Media Audio), das von Microsoft als Alternative zu MP3 konzipiert wurde. Infolgedessen ist es eine Alternative, und dies trotz der besten Bemühungen der Entwickler. Das nächste Zeichen ist OGG. Trotz der breiteren Möglichkeiten als beispielsweise MP3 wurde es nie allgemein akzeptiert. Obwohl es mit vielen Betriebssystemen kompatibel ist. Vielleicht ist das AAC-Audioformat erwähnenswert, das MP3 im Relais ersetzen sollte. Die Codierungsqualität wurde verbessert und der Komprimierungsverlust verringert. Aber ja.

Der Hauptvorteil dieser Formate ist ihre geringe Größe. Der Nachteil ist der Qualitätsverlust.

Verschiedene Formate
In der heutigen Welt finden Sie eine große Anzahl verschiedener Klangerweiterungen. Erinnern wir uns auf einen Blick:

MP3 (Na wo ohne?)
WMA
OGG
CAA
Und viele andere
Natürlich ist jedes dieser Formate gut, insbesondere MP3, das wahrscheinlich das beliebteste Format ist. Aber heute sprechen wir nicht über Popularität. MP3 und andere ähnliche Formate, egal wie gut sie klingen, sind komprimierte Originale. Und selbst wenn Sie die maximale Qualität auf 320 btrate einstellen, wird sie nicht von höchster Qualität sein. Es wurde komprimiert, reduziert, so dass es gewisse Verluste geben wird.