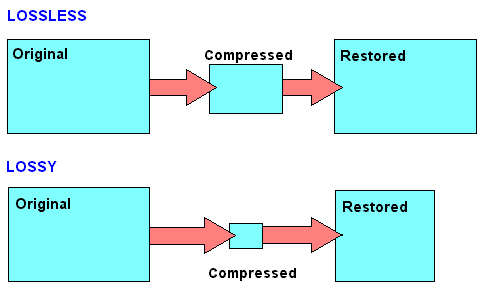
Audiokomprimierung, wie es funktioniert Teil 2

Redundante Informationen für Übertragungssignale
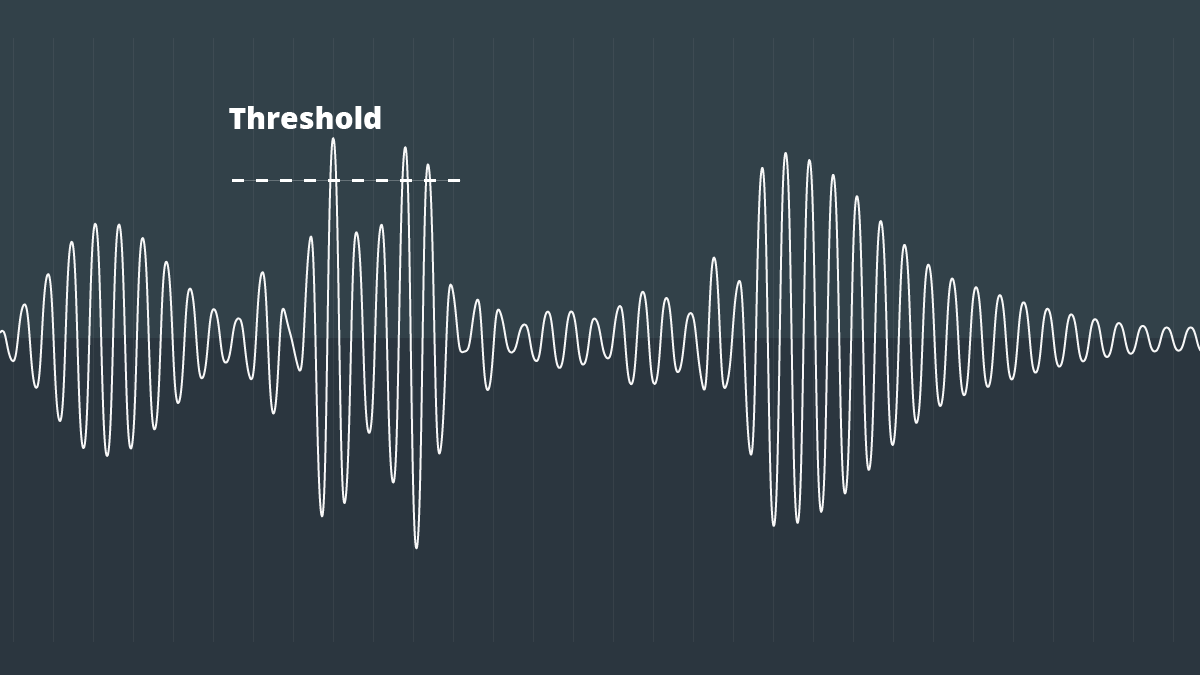
Die digitale Audiokompressionscodierung komprimiert das Audiodatensignal so weit wie möglich unter der Prämisse sicherzustellen, dass das Signal nicht hörbar verzerrt wird. Die digitale Audiokompressionscodierung wird implementiert, indem redundante Komponenten in Tonsignalen entfernt werden. Sogenannte redundante Komponenten beziehen sich auf Signale im Audio, die vom menschlichen Ohr nicht wahrgenommen werden können und nicht dazu beitragen, die Klangfarbe, Tonhöhe und andere Informationen des Klangs zu bestimmen. Redundante Signale umfassen Audiosignale außerhalb des Bereichs des menschlichen Gehörs und maskierte Audiosignale. Beispielsweise beträgt der vom menschlichen Ohr wahrnehmbare Frequenzbereich des Schallsignals 20 Hz bis 20 KHz, und andere Frequenzen als diese Frequenz, die vom menschlichen Ohr nicht wahrgenommen werden können, können als redundante Signale betrachtet werden. Außerdem wird gemäß den physiologischen und psychoakustischen Phänomenen des menschlichen Ohrs, wenn ein starkes Signal und ein schwaches Signal gleichzeitig vorhanden sind, das schwache Signal durch das starke Signal maskiert und kann nicht gehört werden, so dass das schwache Signal sein kann als redundantes Signal angesehen. Nicht senden. Dies ist der Maskierungseffekt des menschlichen Gehörs, der sich hauptsächlich in dem spektralen Maskierungseffekt und dem Zeitbereichsmaskierungseffekt manifestiert, die im Folgenden dargestellt werden:
Spektrale Maskierungseffekte.
Nachdem die Schallenergie einer Frequenz unter einer bestimmten Schwelle liegt, wird sie vom menschlichen Ohr nicht mehr gehört, und diese Schwelle wird als minimale hörbare Schwelle bezeichnet. Wenn ein anderer Ton mit höherer Energie auftritt, erhöht sich der Schwellenwert nahe der Frequenz des Tons erheblich, was als Maskierungseffekt bekannt ist.
Maskierungseffekte im Zeitbereich.
Beim gleichzeitigen Auftreten von starken und schwachen Signalen kommt es auch im Zeitbereich zu einem Maskierungseffekt. Das heißt, wenn die beiden zeitlich sehr nahe beieinander liegen, tritt auch der Maskierungseffekt auf. Die Zeitdomänenmaskierung ist in drei Teile unterteilt: Vormaskierung, simultane Maskierung und Nachmaskierung. Vormaskierung bezieht sich auf die kurze Zeit, bevor das menschliche Ohr ein starkes Signal hört, das bereits vorhandene schwache Signal wird maskiert und kann nicht gehört werden. Gleichzeitige Maskierung bedeutet, dass bei gleichzeitigem Vorhandensein eines starken und eines schwachen Signals das schwache Signal durch das starke Signal maskiert wird und nicht gehört werden kann. Post-Masking bedeutet, dass es lange dauert, bis das schwache Signal wieder zu hören ist, wenn das starke Signal verschwindet, was als Post-Masking bezeichnet wird. Diese schwach maskierten Signale können als redundante Signale betrachtet werden.