Kompressionskodierungsverfahren Teil 2


Free Download Mp4Gain
picture

Kompressionskodierungsverfahren Teil 2
Compression encoding method

Andere Unterteilungen von Kompressionsverfahren

Compression encoding method

Auf dem Gebiet der Audiokomprimierung gibt es zwei Komprimierungsverfahren, verlustbehaftete Komprimierung und verlustfreie Komprimierung. Häufig gesehene MP3, WMA, OGG werden als verlustbehaftete Komprimierung bezeichnet. Wie der Name schon sagt, reduziert die verlustbehaftete Komprimierung die Audio-Samplerate und Bitrate, und die ausgegebene Audiodatei ist kleiner als die Originaldatei. Eine andere Audiokomprimierung wird als verlustfreie Komprimierung bezeichnet, worüber wir sprechen. Die verlustfreie Komprimierung kann die Lautstärke der Audiodatei unter der Prämisse, 100 % aller Daten in der Originaldatei zu speichern, auf eine kleinere Größe komprimieren, und nach der Wiederherstellung der komprimierten Audiodatei kann sie dieselbe Größe und dieselbe Bitrate wie die Quelle erreichen Datei. Zu den verlustfreien Komprimierungsformaten gehören APE, FLAC, WavPack, LPAC, WMALossless, AppleLossless, La, OptimFROG, Shorten, während gängige und herkömmliche verlustfreie Komprimierungsformate nur APE und FLAC sind. [1]
Hauptklassifikationen und typische Vertreter von Audiokomprimierungsalgorithmen.Streaming bearbeiten
Allgemein können Audiokomprimierungstechniken in zwei Kategorien eingeteilt werden: verlustfreie Komprimierung und verlustbehaftete Komprimierung, und gemäß unterschiedlichen Komprimierungsschemata können sie in Zeitdomänenkomprimierung, Transformationskomprimierung und Zeitdomänenkomprimierung, Teilband sowie unterteilt werden hybride Komprimierung, bei der mehrere Technologien miteinander kombiniert werden. Verschiedene Komprimierungstechniken weisen große Unterschiede in der Algorithmuskomplexität (einschließlich Zeitkomplexität und Raumkomplexität), Audioqualität, Algorithmuseffizienz (dh Komprimierungsverhältnis) und Codec-Verzögerung auf. Auch die Anwendungen verschiedener Komprimierungstechniken sind unterschiedlich.
Zeitbereichskomprimierungstechnologie (oder Wellenformcodierung)
Es verarbeitet direkt die Abtastwerte des Audio-PCM-Codestroms und komprimiert den Codestrom durch Stilleerkennung, nichtlineare Quantisierung und Differenz. Gemeinsame Merkmale dieser Art von Komprimierungstechnologie sind eine geringe Algorithmuskomplexität, durchschnittliche Klangqualität, ein kleines Komprimierungsverhältnis (CD-Qualität > 400 kbps) und die kürzeste Codec-Verzögerung (im Vergleich zu anderen Technologien). Diese Art von Komprimierungstechnologie wird im Allgemeinen für Anwendungen mit Sprachkomprimierung und niedriger Bitrate (kleine Quellsignalbandbreite) verwendet. Die Zeitbereichskomprimierungstechnologie umfasst hauptsächlich G.711, ADPCM, LPC, CELP und Blockkomprimierungstechnologie, die auf diesen Technologien entwickelt wurde, wie z. B. NICAM, Subband ADPCM (SB-ADPCM)-Technologie.
Subband-Komprimierungstechnologie
Die Subband-Codierungstheorie wurde erstmals 1976 von Crochiere et al. vorgeschlagen. Die Grundidee besteht darin, das Signal in die Summe der Komponenten in mehrere Subbänder zu zerlegen und dann unterschiedliche Komprimierungsstrategien für jede Subbandkomponente gemäß ihren unterschiedlichen Layoutmerkmalen anzuwenden, um die Coderate zu reduzieren . Die unten beschriebene übliche Teilbandkompressionstechnologie und Transformationskompressionstechnologie basieren auf dem menschlichen Wahrnehmungsmodell (psychoakustisches Modell) des Tonsignals und der Quantisierungsreihenfolge der Teilbandabtastwerte oder der Abtastwerte. Der Frequenzbereich wird durch Analysieren des Spektrums des Signals bestimmt . andere Parameter ausgewählt werden, so dass es auch als wahrnehmungsbezogene Kompressionscodierung (Perceptual) bezeichnet werden kann. Im Vergleich zur Time-Domain-Kompressionstechnik sind diese beiden Kompressionsverfahren deutlich aufwendiger, gleichzeitig wird aber auch die Codiereffizienz und Tonqualität stark verbessert und die Codierverzögerung entsprechend erhöht. Im Allgemeinen ist die Komplexität der Teilbandcodierung etwas geringer als die der Transformationscodierung, und die Codierungsverzögerung ist relativ kurz.
Free Download Mp4Gain
picture

Kompressionscodierungsverfahren

Kompressionscodierungsverfahren

Compression encoding

Übertragung

Compression encoding

Die Codierung von Audiosignalen wird nach unterschiedlichen Komprimierungsprinzipien in Wellenformcodierung, Parametercodierung und Codierungsformen unterteilt, die verschiedene Technologien integrieren.
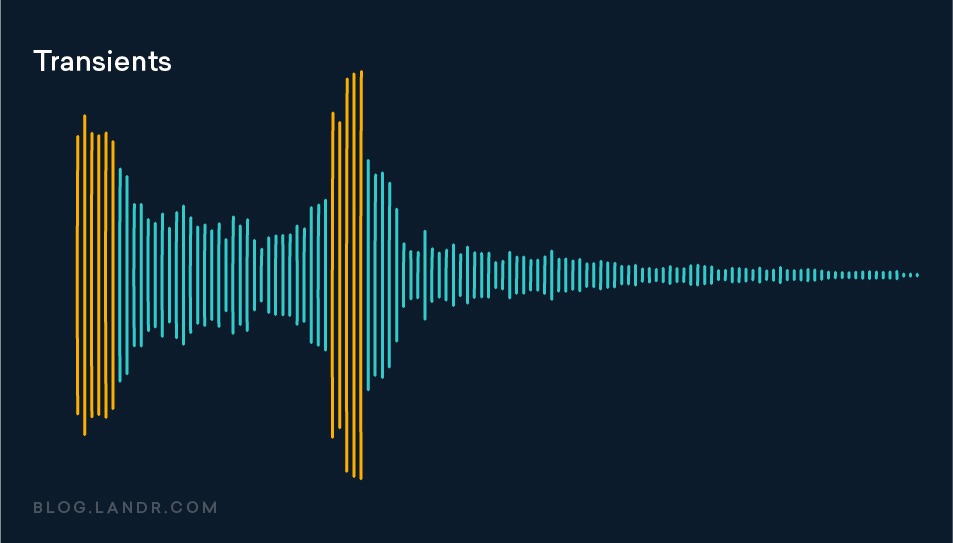
(1) Wellenformcodierung tastet direkt die Zeitdomänen- oder Frequenzdomänenwellenform des Audiosignals mit einer bestimmten Rate ab und quantisiert dann die Amplitudenabtastungen hierarchisch, wandelt sie in digitale Codes um und gibt ein aus den Wellenformdaten rekonstruiertes Signalcodierungssystem aus . , ist die Wellenform so konsistent wie möglich mit der ursprünglichen Tonwellenform, wobei detaillierte Signaländerungen und verschiedene Übergangseigenschaften erhalten bleiben.
(2) Parametrische Codierung Zunächst wird ein Merkmalsmodell basierend auf verschiedenen Signalquellen wie Sprachsignalen, natürlichen Geräuschen usw. durch Merkmalsparameterextraktion und Codierungsverarbeitung erstellt, wobei versucht wird, dass das rekonstruierte Tonsignal so laut wie möglich ist. um die Semantik des Originaltons beizubehalten, aber rekonstruiert.Die Wellenform des Signals kann sich von der Wellenform des ursprünglichen Tonsignalsstark unterscheiden. Charakteristische Parameter, die allgemein verwendet werden, sind Formant, linearer Prädiktionskoeffizient, Frequenzbandteilungsfilter und andere Parametercodierungstechnologien, die eine langsame Tonsignalcodierung realisieren können, und eine Bitrate, die auf 2 Kbit/s – 4,8 Kbit/s komprimiert werden kann. aber die Klangqualität kann nur mäßige Natürlichkeit erreichen, besonders niedrig, nur geeignet für Sprachübertragung und Ausdruck.
(3) Hybridcodierung Die Codierungsmethode, die Wellenformcodierung und Parametercodierung kombiniert, überwindet die Schwächen der ursprünglichen Wellenformcodierung und Parametercodierung und strebt danach, eine hohe Qualität der Codierung von Wellenformen und der Parametercodierung mit niedriger Rate bei einer Rate von 4–16 Kbit aufrechtzuerhalten /s Es kann ein hochqualitatives synthetisches Tonsignal erhalten werden. Die Grundlage der hybriden Codierung ist die lineare prädiktive Codierung (LPC), häufig verwendete Codierungsverfahren wie die pulserregte lineare Vorhersagecodierung (MPLPC), die zeitliche Planung der pulserregten linearen Vorhersagecodierung (KPELPC), die Codebook Excited Linear Prediction (CELPC) usw.

Audiokomprimierung, wie es funktioniert Teil 2

Audiokomprimierung, wie es funktioniert Teil 2

Audio compression

Redundante Informationen für Übertragungssignale

Audio compression

Die digitale Audiokompressionscodierung komprimiert das Audiodatensignal so weit wie möglich unter der Prämisse sicherzustellen, dass das Signal nicht hörbar verzerrt wird. Die digitale Audiokompressionscodierung wird implementiert, indem redundante Komponenten in Tonsignalen entfernt werden. Sogenannte redundante Komponenten beziehen sich auf Signale im Audio, die vom menschlichen Ohr nicht wahrgenommen werden können und nicht dazu beitragen, die Klangfarbe, Tonhöhe und andere Informationen des Klangs zu bestimmen. Redundante Signale umfassen Audiosignale außerhalb des Bereichs des menschlichen Gehörs und maskierte Audiosignale. Beispielsweise beträgt der vom menschlichen Ohr wahrnehmbare Frequenzbereich des Schallsignals 20 Hz bis 20 KHz, und andere Frequenzen als diese Frequenz, die vom menschlichen Ohr nicht wahrgenommen werden können, können als redundante Signale betrachtet werden. Außerdem wird gemäß den physiologischen und psychoakustischen Phänomenen des menschlichen Ohrs, wenn ein starkes Signal und ein schwaches Signal gleichzeitig vorhanden sind, das schwache Signal durch das starke Signal maskiert und kann nicht gehört werden, so dass das schwache Signal sein kann als redundantes Signal angesehen. Nicht senden. Dies ist der Maskierungseffekt des menschlichen Gehörs, der sich hauptsächlich in dem spektralen Maskierungseffekt und dem Zeitbereichsmaskierungseffekt manifestiert, die im Folgenden dargestellt werden:
Spektrale Maskierungseffekte.
Nachdem die Schallenergie einer Frequenz unter einer bestimmten Schwelle liegt, wird sie vom menschlichen Ohr nicht mehr gehört, und diese Schwelle wird als minimale hörbare Schwelle bezeichnet. Wenn ein anderer Ton mit höherer Energie auftritt, erhöht sich der Schwellenwert nahe der Frequenz des Tons erheblich, was als Maskierungseffekt bekannt ist.

Maskierungseffekte im Zeitbereich.
Beim gleichzeitigen Auftreten von starken und schwachen Signalen kommt es auch im Zeitbereich zu einem Maskierungseffekt. Das heißt, wenn die beiden zeitlich sehr nahe beieinander liegen, tritt auch der Maskierungseffekt auf. Die Zeitdomänenmaskierung ist in drei Teile unterteilt: Vormaskierung, simultane Maskierung und Nachmaskierung. Vormaskierung bezieht sich auf die kurze Zeit, bevor das menschliche Ohr ein starkes Signal hört, das bereits vorhandene schwache Signal wird maskiert und kann nicht gehört werden. Gleichzeitige Maskierung bedeutet, dass bei gleichzeitigem Vorhandensein eines starken und eines schwachen Signals das schwache Signal durch das starke Signal maskiert wird und nicht gehört werden kann. Post-Masking bedeutet, dass es lange dauert, bis das schwache Signal wieder zu hören ist, wenn das starke Signal verschwindet, was als Post-Masking bezeichnet wird. Diese schwach maskierten Signale können als redundante Signale betrachtet werden.

Audiokomprimierung, wie es funktioniert

Audiokomprimierung, wie es funktioniert

Audio compression

Audiokomprimierung

audio compression


Die Audiokomprimierungstechnologie bezieht sich auf die Anwendung einer geeigneten digitalen Signalverarbeitungstechnologie auf den ursprünglichen digitalen Audiosignalstrom (PCM-Codierung), ohne die Menge nützlicher Informationen zu verlieren, oder unter der Bedingung, dass der eingeführte Verlust unbedeutend ist, seinen Code zu reduzieren (komprimieren). Rate und wird auch als Komprimierungscodierung bezeichnet.

Es muss eine entsprechende inverse Transformation haben, die als Dekomprimierung oder Dekodierung bezeichnet wird. Das Audiosignal kann viel Rauschen und einige Verzerrungen einführen, nachdem es ein Codec-System durchlaufen hat

Die Audiokomprimierungstechnologie bezieht sich auf die Anwendung einer geeigneten digitalen Signalverarbeitungstechnologie auf den ursprünglichen digitalen Audiosignalstrom (PCM-Codierung), ohne die Menge nützlicher Informationen zu verlieren, oder unter der Bedingung, dass der eingeführte Verlust unbedeutend ist, wodurch seine Coderate reduziert (komprimiert) wird , und wird auch als Komprimierungscodierung bezeichnet. Es muss eine entsprechende inverse Transformation haben, die als Dekomprimierung oder Dekodierung bezeichnet wird. Audiosignale können nach dem Passieren eines Codec-Systems viel Rauschen und einige Verzerrungen einführen. Die Vorteile des digitalen Signals liegen auf der Hand, aber es hat auch seine eigenen entsprechenden Nachteile, dh erhöhte Speicherkapazitätsanforderungen und erhöhte Kanalkapazitätsanforderungen während der Übertragung. Bei einer CD als Beispiel beträgt die Abtastfrequenz 44,1 kHz und die Quantisierungsgenauigkeit 16 Bit, sodass ein Stereo-Audiosignal für 1 Minute etwa 10 MB Speicherkapazität belegen muss, dh nur die Kapazität eines CD-Plattenspielers etwa 1 Stunde. Natürlich ist das Problem in der Welt von digitalem Video mit viel höherer Bandbreite sogar noch ausgeprägter. Sind all diese Bits notwendig? Die Studie ergab, dass es eine große Redundanz bei der direkten Verwendung des PCM-Codestroms für die Speicherung und Übertragung gibt. Tatsächlich kann Ton unter verlustfreien Bedingungen auf mindestens 4:1 komprimiert werden, dh nur 25 % der digitalen Menge werden verwendet, um alle Informationen zu erhalten, und das Komprimierungsverhältnis im Videobereich kann sogar mehrere hundert Mal betragen. Daher hat die Komprimierungstechnologie seit ihrer Einführung viel Aufmerksamkeit erhalten, um begrenzte Ressourcen zu verwenden. Die Erforschung und Anwendung der Audiokomprimierungstechnologie hat eine lange Geschichte, wie die A-Law-Codierung ist u-Law eine einfache, fast sofortige Komprimierungstechnologie und wurde bei der ISDN-Sprachübertragung angewendet. Die Erforschung von Sprachsignalen wurde zuvor entwickelt und ist ausgereift und weit verbreitet, wie z. B. adaptive differentielle PCM (ADPCM), lineare prädiktive Codierung (LPC) und andere Technologien.