Ist FLAC besser als MP3? Expertenmeinung.


Free Download Mp4Gain
picture

Ist FLAC besser als MP3? Expertenmeinung.

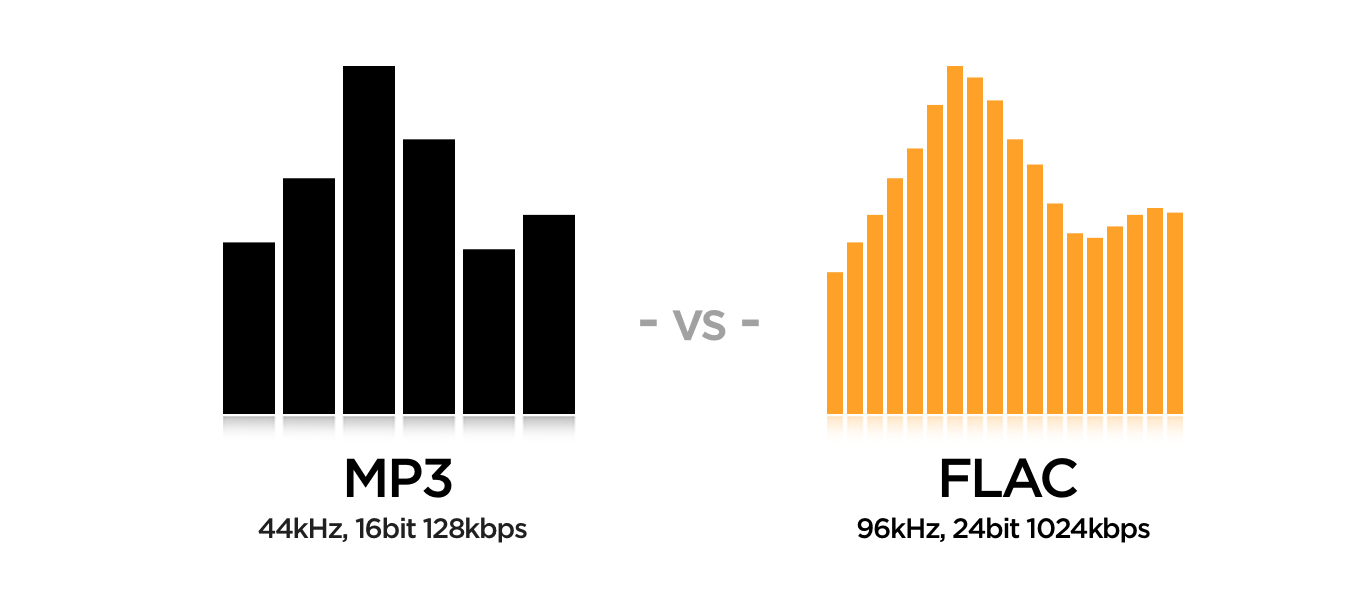
FLAC vs. MP3

Viele fragen sich, ob FLAC wirklich besser ist als mp3.

FLAC vs. MP3

Dies ist eine Frage, die wir häufig erhalten, und zwar nicht nur in Bezug auf FLAC, sondern auch auf ogg, m4a usw.

Die Antwort ist einfach, behält aber ihre Komplexität.

Einfach, weil streng mathematisch, akustisch, digital, wenn FLAC überlegen ist.

Aber die Komplexität ist: Kann eine gewöhnliche Person, die eine normale (nicht ganz professionelle) Hi-Fi- oder gewöhnliche Ausrüstung verwendet, den Unterschied erkennen?

Die Antwort lautet: In 99% der Fälle wird selbst ein Musikprofi keinen Unterschied feststellen, wenn mehr als 190 kbs und mindestens 44.100 Samplerates in der mp3 verwendet werden.

Bei dieser Qualität im mp3, die nicht ungewöhnlich oder sehr hoch ist, reicht es bereits aus, dass die meisten Menschen, einschließlich Menschen mit Audio-Training, keinen Unterschied erkennen können.

Es ist also ein puristischer Anspruch, als absolute Antwort zu sagen, dass FLAC Mp3 überlegen ist.

Für den normalen Benutzer wird es keinen großen Unterschied geben und andererseits werden sie gewisse Punkte gegen sich haben, wie die Tatsache, dass es nicht so viele Teams gibt, die FLAC akzeptieren oder gut handhaben, oder dass sie es hören werden ZB im Auto macht es nicht viel Sinn, Zeit, Geld und Mühe zu investieren, um ein Format zu verwenden, das gleich klingt. Der einzige Vorteil besteht darin, seinen Freunden zu sagen, dass er ein besseres Format verwendet.


Free Download Mp4Gain
picture

Bittiefe und Abtastrate TEIL 2

Bittiefe und Abtastrate TEIL 2

Bit Depth and Sample Rate

Fade-Verarbeitung

Bit Depth and Sample Rate

Wir wissen jetzt, dass die digitale Signalverarbeitung zwangsläufig sehr fehlerhaft ist. Die Annäherung an die Gesamtsumme wird also auch viele Fehler enthalten. Diese Fehler machen das Audio nicht nur nicht wiederherstellbar, sondern führen auch zu einem unnatürlichen Klang.

Um diese Artefakte zu entfernen, fügen wir dem Signal berechnetes Rauschen mit niedriger Amplitude hinzu, was wir Dithering nennen. Die Amplitude des Jitter-Rauschens ist sehr gering, und obwohl etwas noch zu hören ist, ist es besser als keine Hinzufügung.

Beachten Sie, dass sich Jitter-Rauschen ansammelt. Wenn Sie einem Signal Rauschen hinzufügen, verringert sich das Signal-Rausch-Verhältnis. Wenn die Operation wiederholt wird, wird dieses Verhältnis weiter abnehmen, was dem Signal Unsicherheit hinzufügt. Aus diesem Grund wird Dithering oft als letzter Schritt beim Mastering angewendet, und zwar nur einmal.

Dithering hat eine ziemlich interessante Geschichte:

Die erste Dither-Verarbeitung erschien während des Zweiten Weltkriegs. Bomber verwenden mechanische Computer für die Navigation und ballistische Berechnungen. Interessanterweise sind diese Rechner präziser in ihrer Rechenleistung in der Luft. Ingenieure erkannten, dass Vibrationen des Flugzeugs Fehler in beweglichen Teilen reduzierten. Seine Bewegungen werden eher kontinuierlich als plötzliche Vibrationen. Computer haben kleine vibrierende Motoren, und ihre Vibrationen werden Oszillation genannt, was vom mittelalterlichen englischen Wort „didderen“ abgeleitet ist, was „schütteln“ bedeutet. Moderne Wörterbücher definieren Zittern als einen Zustand hoher Anspannung, Verwirrung oder Angst. Dithering bringt digitale Systeme analogen Systemen in gewisser Weise näher.

– Ken Pohlmann, Digitale Audioregeln

Abtastrate
Die Abtastrate von 44,1 K pro Sekunde reicht theoretisch aus, um den Hörbereich des menschlichen Ohrs abzudecken. Möglicherweise haben Sie versehentlich vom Satz von Nyquist erfahren, der besagt, wie Aliasing (eine Art Verzerrung) vermieden und alle Frequenzen durch Abtasten rekonstruiert werden können, was eine Abtastung mit der doppelten höchsten Frequenz des Signals erfordert (dieser Satz gilt auch für Nicht-Audio Medien, darauf gehen wir hier nicht ein).

Das menschliche Ohr hat einen Hörbereich von bis zu 20 kHz (die meisten Studien zeigen, dass diese Zahl tatsächlich bei etwa 17 K liegt), sodass eine Abtastrate von 40 K ausreicht, um jede Frequenz klar zu hören. 44.1K ist der Industriestandard, der aus mehreren Gründen von SONY, das damals ein Oligopol war, festgelegt wurde.

Kurz gesagt, die digitalen Audio-Samples müssen über der Nyquist-Frequenz liegen, da die Samples in der Praxis während des Digital-Analog-Wandlungsprozesses tiefpassgefiltert werden, um Aliasing zu verhindern. Je glatter die Flanke des Tiefpassfilters ist, desto niedriger sind die Herstellungskosten. Ein Audiosignal, das normalerweise einen Tiefpassfilter verwendet, hat also eine glatte Flanke bei 2 kHz. Um beispielsweise das gesamte Spektrum unter 20 kHz zu halten, sollte dies mit einer Abtastrate von 44 kHz erfolgen (20 K [höchste Frequenz] + 2 K [Tiefpassfilterflanke] x 2 [Nyquist-Theorie] = 44 K).

Letztendlich wurde der 44.1K-Standard in einem Kampf zwischen Sony und Philips gelöst (beide hatten ähnliche Endziele). Dies basiert auch auf der Mathematik hinter der Audio-Abtastrate und der Videoband-Anatomie. Auf diese Weise können Audio und Video auf demselben Videoband koexistieren, was eine höhere Kostenleistung hat. 48K ist jedoch der Standard für Video im Zusammenhang mit Audio. CD-Audio bleibt bei 44,1K.

Bittiefe und Abtastrate

Bittiefe und Abtastrate

Bit depth and sample rate

Das erste, was Sie verstehen müssen, ist, dass Bittiefe und Abtastrate nur bei digitalem Audio existieren.

Bit depth and sample rate

Bei digitalem Audio beschreibt die Bittiefe die Amplitude (vertikale Achse) und die Abtastrate die Frequenz (horizontale Achse). Die Erhöhung der Anzahl der verwendeten Bits erhöht also die Auflösung der Tonamplitude, und die Erhöhung der Anzahl der Samples pro Sekunde erhöht die Auflösung der Tonfrequenz.

In einem analogen System (der natürlichen Welt) ist das Audio kontinuierlich und glatt. In digitalen Systemen können glatte analoge Wellenformen nur grob abgetastet und auf einen bestimmten Amplitudenbereich begrenzt werden. Beim Sampling eines Sounds wird das Audio in kleine Segmente (Samples) unterteilt, die auf einen festen Amplitudenpegel eingestellt sind. Der Prozess der Korrektur eines Signals auf einen bestimmten Amplitudenpegel wird als Quantisierung bezeichnet, und der Prozess der Erstellung eines Sample-Segments wird als Sampling bezeichnet.

In der folgenden Grafik wird eine natürliche Sinuswelle für bis zu 1 s angezeigt, beginnend bei 0 und endend bei 1 s. Die blauen Balken stellen Annäherungen an die digitale Quantisierung der Sinuswelle dar, und jeder Balken ist ein Sample, das auf den ungefähr verfügbaren Amplitudenpegel geclippt ist. (Natürlich ist die Grafik unvollständiger als die Realität).

Abhängig von der während der Aufnahme getroffenen Auswahl kann ein Audio von 1 s Dauer Samples von 44,1 K, 48 K haben und im Fall von 24 Bit einen Amplitudenpegel von -144 dB bei 0 dB enthalten (-96 dB bis 0 dB für 16 Bit ). Die Dynamikbereichsauflösung (die Anzahl der Amplitudenpegeleinheiten, die für ein Sample verwendet werden können, dh die Anzahl der angezeigten Rechtecke) beträgt 65536 bei 16 Bit und 16777216 bei 24 Bit.

Daher kann eine Erhöhung der Bittiefe die Amplitudenauflösung und den Dynamikbereich erheblich verbessern. Wo erscheint also die Erhöhung des Dynamikbereichs? Da die Amplitude 0 dB nicht überschreiten kann, wird das hinzugefügte dB auf Samples mit kleineren Amplituden verteilt. Man kann also mehr kleine Klänge hören (z. B. eine Reverb-Spur, die sich bei -130 dB dehnt), die bei 16 Bit, -96 dB, abgeschnitten würden.

runden und wegwerfen

Bei digitalem Audio wird jedes Sample analysiert, verarbeitet, in Audio umgewandelt und dann über Lautsprecher wiedergegeben. Wenn ein Sample in Ihrer DAW verarbeitet wird (Gain, Distortion usw.), werden grundlegende Multiplikations- und Divisionsoperationen durchlaufen, mit denen Sie die digitale Darstellung des Samples ändern können. Ganz einfach, wenn wir den Rundungsprozess nicht durchführen (die 1-dB-Verstärkung muss mit 1,122018454 multipliziert werden), überschreiten selbst 8 oder 4 Bit Sample-Präzision den 24-Bit-Raum.

Da wir also nur 24 Bit haben, müssen diese langen Zahlen in diesen Raum passen. Dazu rundet oder verwirft der DSP das niedrigstwertige Bit (LSB, die letzte Ziffer in der Anzahl der Bits, z. B. die 16. Ziffer in einem 16-Bit-Sample). Das Runden ist ziemlich einfach und verwendet Algorithmen, mit denen Sie vertraut sind. Discard verwirft die Informationen nach dem niederwertigsten Bit ohne Analyse.

Beide Prozesse haben bestimmte Fehler, sie führen Fehler in die Gleichung ein, diese Fehler akkumulieren sich durch Signalkettenverarbeitung und werden schließlich reflektiert. Auf der positiven Seite ist das LSB das digitale Bit mit der kleinsten Amplitude, sodass der Fehler bei -96 dB für 16-Bit-Samples und bei -144 dB für 24-Bit-Samples auftritt. Gleichzeitig führen auch die unterschiedlichen Strukturen und Methoden digitaler Signalprozessoren zu unterschiedlichen Ergebnissen.

Wie kann man eine mp3-Datei komprimieren, damit sie weniger Speicherplatz auf der Festplatte benötigt?

Wie kann man eine mp3-Datei komprimieren, damit sie weniger Speicherplatz auf der Festplatte benötigt?

Mp3 compression

Ein mp3 nimmt im Durchschnitt ein Elftel des Originals ein.

Mp3 compression

Manchmal ist den Leuten nicht klar, dass das buchstäbliche Komprimieren einer mp3-Datei bedeutet, dass die Daten viel weniger Platz auf der Festplatte beanspruchen.

Ein WAV nimmt normalerweise viel Platz ein, vor allem, weil es so viele Informationen wie möglich speichert.

Vor langer Zeit wurde festgestellt, dass das menschliche Ohr nicht sehr genau ist und daher viele Geräusche nicht gehört werden konnten.

Basierend auf einer Analyse all dieser Informationen über die Besonderheiten der menschlichen Wahrnehmung in Bezug auf Klang, konnte ein Algorithmus entwickelt werden, um all diese Informationen zu entfernen, die in den ursprünglichen WAVs enthalten waren, aber da sie ohne größere Auswirkungen entfernt werden konnten, erreichten dies Die Komprimierung war nicht nur zip-artig, sondern auch auditiv.

Das Ergebnis war überraschend, da ein mp3 im Durchschnitt ein Elftel der Größe des Original-Audios einnahm, wobei kaum Unterschiede wahrnehmbar waren.

Im Laufe der Zeit hat sich dies noch weiter verbessert, und laut vielen Tests, die von vielen verschiedenen Forschern durchgeführt wurden, wurde festgestellt, dass eine MP3 mit einer Bitrate von 192 oder mehr und einer Samplerate von 410 oder mehr fast unmöglich von anderen zu unterscheiden ist Audio ohne Verlust für 99,99 % der Menschen.

Vor allem, wenn wir die Qualität der heute verfügbaren Geräte und Kopfhörer berücksichtigen.