Soundcodierung
Klang ist physischer Natur. Jedes Geräusch sind Schwingungen im Raum (in diesem Fall in der Luft), die von unseren Ohren erfasst werden. Die Schwingungen sind kontinuierlich und können durch mathematische Modelle beschrieben werden. Wir werden dies natürlich nicht tun, aber wir werden die Frage stellen: Wie können Schwingungen kontinuierlicher Natur auf eine Maschine geschrieben werden, die nur mit Nullen und Einsen arbeitet?

1.1. Keine Komprimierung, kein Verlust
Das WAV (WAVE) -Format bewahrt die Audiospur in ihrer wahren Qualität, ohne die Audiodatei selbst zu manipulieren.
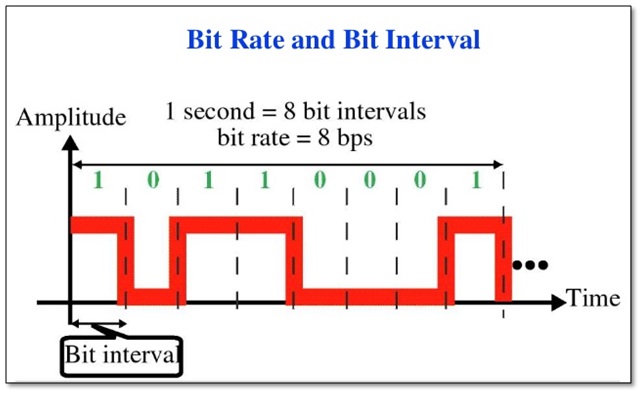
Um Ton aufzunehmen, müssen wir ihn in eine Reihe von Nullen und Einsen konvertieren. Im Fall des WAV-Formats geschieht dies auf die dümmste Weise: Der eingehende Audiostream wird in die kleinsten Segmente unterteilt (wie viele, daher die Begriffe “Abtastrate”, “Abtastrate” oder “Abtastrate”). Abtastung “) und in jedem Zeitintervall wird der aktuelle Wert des analogen Signals binär geschrieben. Formen. WAV-Dateien können mit Abtastraten von beispielsweise 8 kHz bis 192 kHz aufgezeichnet werden, der De-facto-Standard beträgt jedoch 44,1 kHz.
Es ist zu beachten, dass WAV als Container auch andere Möglichkeiten zum Speichern von Audioinformationen unterstützt: Zum Beispiel ADPCM, das in Abhängigkeit von der Bandbreite Audiodaten mit einer variablen Abtastrate codieren kann.
Die Frequenz von 44,1 kHz war kein Zufall. Wenn wir Ungenauigkeiten in der Beschreibung zugeben, dann wurde diese Zahl als Aussage von Kotelnikovs Theorem erzeugt: um die korrekteste Wellenform bei Frequenzen bis zu 20 kHz (der theoretischen Grenze der Hörbarkeit des menschlichen Ohrs) beizubehalten, eine Frequenz von Sampling doppelt so hoch: 40 kHz. Tatsächlich ist die Frequenz bei 44,1 kHz auf technische Aspekte zurückzuführen, deren Details hier gelesen werden können.
In jedem Segment dieses Typs wird die tatsächliche Spannung des analogen Signals in binärer Form codiert: Der höchste Pegel kann als “1111” dargestellt werden, der niedrigste als “0000”. Und hier kommt der zweite Parameter ins Spiel: die Tiefe des Klangs, die bestimmt, wie genau der Wellenwert über einen bestimmten Zeitraum digitalisiert wird. WAV-Dateien werden häufig in 16 oder 32 Bit geschrieben. Eine höhere Bittiefe bedeutet eine genauere Aufzeichnung.
Übrigens über PCM. Was brennt auf eine gewöhnliche CD, die nach Audiokassetten so beliebt ist? Das heißt, eine Folge von unkomprimierten Nullen und Einsen im PCM-Format. Bittiefe: 16 Bit, Abtastfrequenz: 44,1 kHz. Wie hoch ist dann die Bitrate dieser Aufnahme?
Eine 16-Bit-Nummer wird 44100 Mal pro Sekunde geschrieben. 44100 * 16 = 705600 Bit / s für einen Kanal;
Bei Stereoaufnahmen wird dieser Wert mit 2 – 1411200 Bit / s oder ~ 1411 KBit / s multipliziert.
Bei 32-Bit-Aufnahmen ist dieser Wert doppelt so hoch: ~ 2822 kbps.
Fazit: daher die Völlerei dieser Dateien für freien Speicherplatz auf der Festplatte, aber als Vorteil: das völlige Fehlen von Verlusten beim Aufnehmen und Anhören einer Audiodatei.
1.2. Verlustfreie Kompression
Ich werde nicht viel über verlustfreie Komprimierung schreiben. Dieser Begriff ist hier zu finden. Tatsächlich besteht diese Methode im Allgemeinen aus der Archivierung von Audioaufzeichnungen unter Verwendung von im Codec integrierten Algorithmen, aber die Daten gehen nicht verloren und die Fähigkeit, die Audioaufzeichnung bitweise wiederherzustellen, bleibt erhalten. Durch das Dekodieren dieser Formate erhalten wir tatsächlich das gleiche WAVE-Format, nur dass es weniger Speicherplatz beansprucht. Die Komprimierung ist ungefähr doppelt so hoch und hängt von der Art der codierten Zusammensetzung ab. Beim Anhören der Aufnahme “dekomprimiert” der Codec die Komposition und sendet eine Folge von unkomprimierten Nullen und Einsen, damit die Soundkarte sie verarbeiten kann.
Es gibt viele Codecs dieses Typs: Dies ist FLAC (Free Lossless Audio Codec), entwickelt von der Xiph-Organisation (ebenfalls entwickeltes Opus), ALAC (Apple Lossless) von der gleichnamigen Firma APE (Monkey’s Audio), WV (WavPack) und andere weniger bekannte verlustfreie Audiokomprimierungsformate.
1.3. Verlustbehaftete Kompression: Wir täuschen unsere Ohren
Wissenschaftler begannen zu denken, dass es im Prinzip oft nicht sinnvoll ist, vollständige Informationen über eine Audioaufnahme zu speichern, da unser Gehör nicht perfekt ist. Möglicherweise hören Sie nach lauten Tönen keine leisen Töne, möglicherweise keine zu hohen oder zu niedrigen Frequenzen usw. Diese Phänomene werden als Maskierungseffekt bezeichnet.
Als Ergebnis haben wir verstanden: Schließlich können Sie es hier werfen, dort schneiden, und der Hörer wird praktisch nichts bemerken – ein unvollkommenes Ohr gibt dem Hörer einfach die Möglichkeit, sich selbst zu täuschen. Daher ist es möglich, die psychoakustische Redundanz in der Datei zu beseitigen.
Tatsächlich existiert die Psychoakustik als Disziplin und untersucht die psychologischen und physiologischen Eigenschaften der menschlichen Wahrnehmung von Geräuschen.