Audiokomprimierung, wie es funktioniert Teil 2


Free Download Mp4Gain
picture

Audiokomprimierung, wie es funktioniert Teil 2

Audio compression

Redundante Informationen für Übertragungssignale
Audio compression

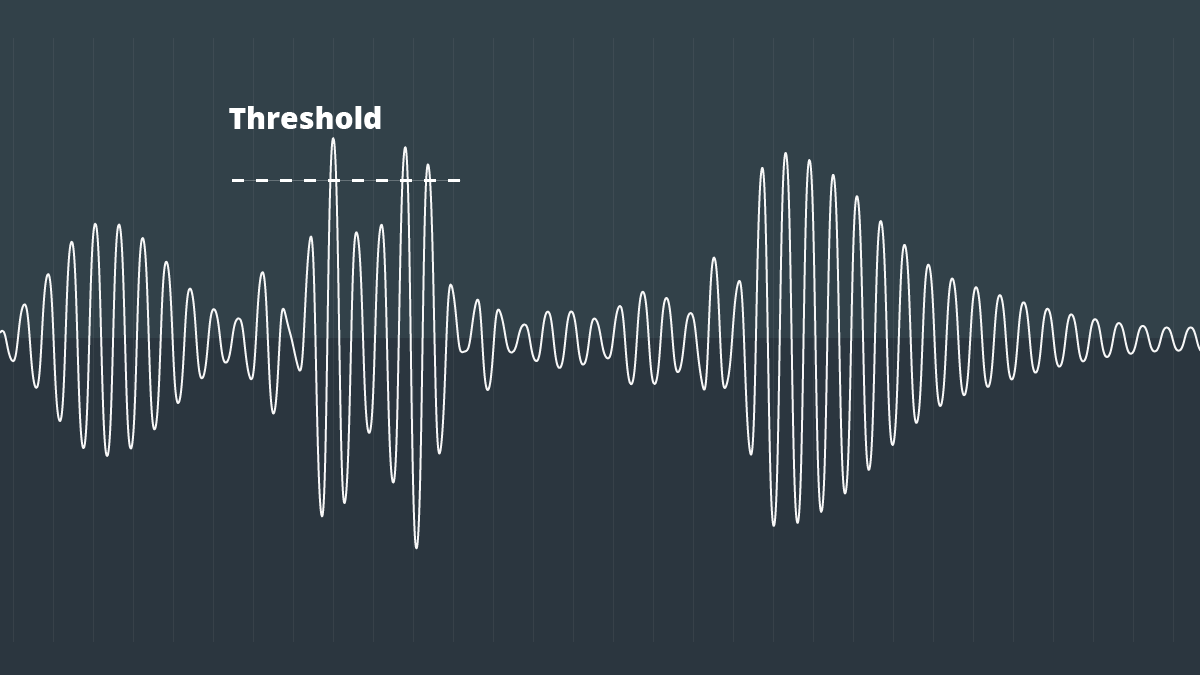
Die digitale Audiokompressionscodierung komprimiert das Audiodatensignal so weit wie möglich unter der Prämisse sicherzustellen, dass das Signal nicht hörbar verzerrt wird. Die digitale Audiokompressionscodierung wird implementiert, indem redundante Komponenten in Tonsignalen entfernt werden. Sogenannte redundante Komponenten beziehen sich auf Signale im Audio, die vom menschlichen Ohr nicht wahrgenommen werden können und nicht dazu beitragen, die Klangfarbe, Tonhöhe und andere Informationen des Klangs zu bestimmen. Redundante Signale umfassen Audiosignale außerhalb des Bereichs des menschlichen Gehörs und maskierte Audiosignale. Beispielsweise beträgt der vom menschlichen Ohr wahrnehmbare Frequenzbereich des Schallsignals 20 Hz bis 20 KHz, und andere Frequenzen als diese Frequenz, die vom menschlichen Ohr nicht wahrgenommen werden können, können als redundante Signale betrachtet werden. Außerdem wird gemäß den physiologischen und psychoakustischen Phänomenen des menschlichen Ohrs, wenn ein starkes Signal und ein schwaches Signal gleichzeitig vorhanden sind, das schwache Signal durch das starke Signal maskiert und kann nicht gehört werden, so dass das schwache Signal sein kann als redundantes Signal angesehen. Nicht senden. Dies ist der Maskierungseffekt des menschlichen Gehörs, der sich hauptsächlich in dem spektralen Maskierungseffekt und dem Zeitbereichsmaskierungseffekt manifestiert, die im Folgenden dargestellt werden:
Spektrale Maskierungseffekte.
Nachdem die Schallenergie einer Frequenz unter einer bestimmten Schwelle liegt, wird sie vom menschlichen Ohr nicht mehr gehört, und diese Schwelle wird als minimale hörbare Schwelle bezeichnet. Wenn ein anderer Ton mit höherer Energie auftritt, erhöht sich der Schwellenwert nahe der Frequenz des Tons erheblich, was als Maskierungseffekt bekannt ist.

Maskierungseffekte im Zeitbereich.
Beim gleichzeitigen Auftreten von starken und schwachen Signalen kommt es auch im Zeitbereich zu einem Maskierungseffekt. Das heißt, wenn die beiden zeitlich sehr nahe beieinander liegen, tritt auch der Maskierungseffekt auf. Die Zeitdomänenmaskierung ist in drei Teile unterteilt: Vormaskierung, simultane Maskierung und Nachmaskierung. Vormaskierung bezieht sich auf die kurze Zeit, bevor das menschliche Ohr ein starkes Signal hört, das bereits vorhandene schwache Signal wird maskiert und kann nicht gehört werden. Gleichzeitige Maskierung bedeutet, dass bei gleichzeitigem Vorhandensein eines starken und eines schwachen Signals das schwache Signal durch das starke Signal maskiert wird und nicht gehört werden kann. Post-Masking bedeutet, dass es lange dauert, bis das schwache Signal wieder zu hören ist, wenn das starke Signal verschwindet, was als Post-Masking bezeichnet wird. Diese schwach maskierten Signale können als redundante Signale betrachtet werden.

Free Download Mp4Gain
picture

Audiokomprimierung, wie es funktioniert

Audiokomprimierung, wie es funktioniert

Audio compression

Audiokomprimierung

audio compression


Die Audiokomprimierungstechnologie bezieht sich auf die Anwendung einer geeigneten digitalen Signalverarbeitungstechnologie auf den ursprünglichen digitalen Audiosignalstrom (PCM-Codierung), ohne die Menge nützlicher Informationen zu verlieren, oder unter der Bedingung, dass der eingeführte Verlust unbedeutend ist, seinen Code zu reduzieren (komprimieren). Rate und wird auch als Komprimierungscodierung bezeichnet.

Es muss eine entsprechende inverse Transformation haben, die als Dekomprimierung oder Dekodierung bezeichnet wird. Das Audiosignal kann viel Rauschen und einige Verzerrungen einführen, nachdem es ein Codec-System durchlaufen hat

Die Audiokomprimierungstechnologie bezieht sich auf die Anwendung einer geeigneten digitalen Signalverarbeitungstechnologie auf den ursprünglichen digitalen Audiosignalstrom (PCM-Codierung), ohne die Menge nützlicher Informationen zu verlieren, oder unter der Bedingung, dass der eingeführte Verlust unbedeutend ist, wodurch seine Coderate reduziert (komprimiert) wird , und wird auch als Komprimierungscodierung bezeichnet. Es muss eine entsprechende inverse Transformation haben, die als Dekomprimierung oder Dekodierung bezeichnet wird. Audiosignale können nach dem Passieren eines Codec-Systems viel Rauschen und einige Verzerrungen einführen. Die Vorteile des digitalen Signals liegen auf der Hand, aber es hat auch seine eigenen entsprechenden Nachteile, dh erhöhte Speicherkapazitätsanforderungen und erhöhte Kanalkapazitätsanforderungen während der Übertragung. Bei einer CD als Beispiel beträgt die Abtastfrequenz 44,1 kHz und die Quantisierungsgenauigkeit 16 Bit, sodass ein Stereo-Audiosignal für 1 Minute etwa 10 MB Speicherkapazität belegen muss, dh nur die Kapazität eines CD-Plattenspielers etwa 1 Stunde. Natürlich ist das Problem in der Welt von digitalem Video mit viel höherer Bandbreite sogar noch ausgeprägter. Sind all diese Bits notwendig? Die Studie ergab, dass es eine große Redundanz bei der direkten Verwendung des PCM-Codestroms für die Speicherung und Übertragung gibt. Tatsächlich kann Ton unter verlustfreien Bedingungen auf mindestens 4:1 komprimiert werden, dh nur 25 % der digitalen Menge werden verwendet, um alle Informationen zu erhalten, und das Komprimierungsverhältnis im Videobereich kann sogar mehrere hundert Mal betragen. Daher hat die Komprimierungstechnologie seit ihrer Einführung viel Aufmerksamkeit erhalten, um begrenzte Ressourcen zu verwenden. Die Erforschung und Anwendung der Audiokomprimierungstechnologie hat eine lange Geschichte, wie die A-Law-Codierung ist u-Law eine einfache, fast sofortige Komprimierungstechnologie und wurde bei der ISDN-Sprachübertragung angewendet. Die Erforschung von Sprachsignalen wurde zuvor entwickelt und ist ausgereift und weit verbreitet, wie z. B. adaptive differentielle PCM (ADPCM), lineare prädiktive Codierung (LPC) und andere Technologien.

Was ist das MP3-Kompressionsprinzip?

Was ist das MP3-Kompressionsprinzip?

MP3 compression

Tatsächlich gibt es viele Audiokomprimierungstechnologien, und die MP3-Komprimierungstechnologie ist nicht die beste.

MP3 compression

Aber jetzt scheint es, dass es immer noch Mainstream ist.
Musiksignale haben viele redundante Komponenten, einschließlich Abstände und Informationen, die das menschliche Ohr nicht unterscheiden kann (z. B. schwache Signale gemischt mit einem starken Hintergrund). Der CD-Sound ist nicht komprimiert und verwendet eine feste Abtastfrequenz von 44,1 kHz, was eine gute Wiedergabe von maximal dynamischer Musik gewährleisten kann. Natürlich ist auch die Datenmenge dort gleich, wo die Informationsmenge geringer ist, also besteht die Möglichkeit der Komprimierung. Die Audiobandbreite von 20 ~ 20 kHz (oberer CD-Player kann bis auf 2 Hz erweitert werden) ist zum aktuellen Musikstandard geworden. Um Klangverzerrungen zu reduzieren, verwendet MP3 einen Codierungsalgorithmus namens „sensorische Codierungstechnologie“: Führen Sie beim Codieren zuerst eine Spektrumanalyse der Audiodatei durch, verwenden Sie dann einen Filter, um den Rauschpegel zu reduzieren, und quantisieren Sie dann das Rauschen. Die verbleibenden Bits werden gestreut und angeordnet, und schließlich wird eine MP3-Datei mit einem höheren Komprimierungsverhältnis gebildet, und die komprimierte Datei kann während der Wiedergabe einen Klangeffekt erzielen, der näher an der ursprünglichen Klangquelle liegt. Obwohl es sich um eine verlustbehaftete Komprimierung handelt, ist ihr größter Vorteil eine sehr geringe Klangverzerrung im Austausch für eine höhere Komprimierungsrate. Und jetzt verwendet MP3 eine VBR-Komprimierungstechnologie (Variable Compression Ratio), ähnlich wie Dolby AC-3. Die Sampling-Komprimierungsrate hängt von der Informationsmenge in der Musik ab, und der Maskierungseffekt des menschlichen Ohrs wird verwendet, um redundante Daten zu reduzieren.

Wie funktioniert eine MP3?

Wie funktioniert eine MP3?

Mp3 Compression

Warum ist eine mp3 kompakter?

Mp3 Compression

Das als mp3 bekannte Format wurde mit der Absicht erstellt, das Audio, das beispielsweise ein WAV enthielt, aufzunehmen, aber viel weniger Platz zu beanspruchen.

Das heißt, es handelt sich nicht um eine Audio-Container-Variante, die für andere Zwecke erstellt wurde. Es wurde speziell entwickelt, erstellt und gedacht, um ein Audio zu komprimieren, das für menschliche Ohren genauso klingen würde wie das ursprüngliche WAV, aber das auf verschiedene Weise viel weniger Platz beanspruchen würde.

Offensichtlich ist das erste Tool die Zip-Komprimierung und die Redundanzkomprimierung.

Wenn zum Beispiel ein zu komprimierendes Stück das Folgende wäre:

00000111110000011111

Der mathematische Weg, es zu komprimieren (vereinfacht gesehen), wäre:

0(5)1(5)0(5)1(5)

Das heißt, fünf Nullen, gefolgt von 6 Nullen, gefolgt von 4 Nullen und endend mit 6 Nullen.

Es ist viel einfacher, es auf diese Weise zu entziffern, und es nimmt viel weniger Platz ein, da es die Nullen und Einsen verwendet.

Das ist die grundlegende Art, Platz zu sparen: nach einer Möglichkeit suchen, dasselbe auszudrücken, aber viel weniger Zeichen oder Elemente zu verwenden.

Stellen Sie sich vor, die ersten drei Sekunden sind stumm:

00000000000000000000000 und so weiter für 200 Nullen. Es ist einfacher, auf irgendeine Weise zu schreiben, dass es am Anfang 324 Nullzahlen geben wird.

Später, und das werden wir später sehen, nutzt das mp3 die bekannte Art und Weise, wie das menschliche Ohr Schall aufnimmt, um zu entscheiden, welche Elemente eliminiert werden können (zum Beispiel Frequenzen, die das menschliche Ohr nicht unterscheiden kann) und so mehr Platz sparen.