Warum kann der Unterschied in der Bitrate dazu führen, dass es großartig klingt (hoch, mittel, niedrig)?


Free Download Mp4Gain
picture

Warum kann der Unterschied in der Bitrate dazu führen, dass es großartig klingt (hoch, mittel, niedrig)?

Bit Depth vs. Bit Rate

Antworten:
Um sicherzugehen, dass dies klar ist, wollen wir differenzieren

BIT RATE BIT DEPTH

Abtastrate gegen Bittiefe

so viel wie

Bitrate

wie sie sich auf Audio im digitalen Bereich beziehen …

Abtastfrequenz:

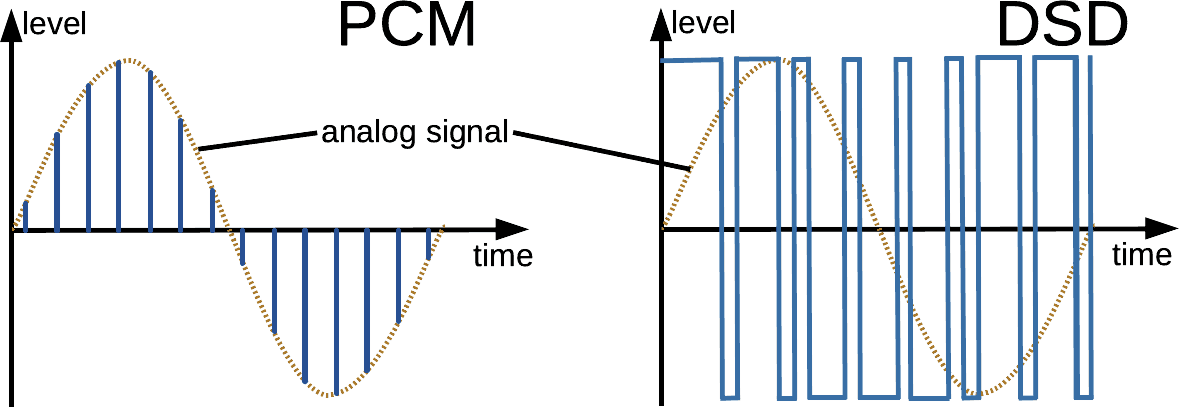
Die Abtastrate wird als Frequenz (Abtastungen pro Sekunde) angegeben, beispielsweise 44,1 kHz für CD. Andere übliche Werte sind 48, 88,2, 96, 176,4 und 196 kHz, obwohl einige Formate (wie DSD) Abtastraten von mehr als 2,8 MHz aufweisen. Die Abtastrate gibt an

wie oft das Audiosignal gemessen wird

Während einige Leute niedrigere Messwerte als abgestuftes Balkendiagramm anzeigen, ziehe ich es vor, sie als untergeordnete Bitmap anzuzeigen. Wenn Sie den Umriss eines Pferdes auf 20 Punkte vereinfachen, damit sich das Kind verbinden kann, führt dies nicht zu Schritten (die Verwendung von geraden und gekrümmten Linien zum Verbinden von 20 Punkten mit korrektem Abstand kann zu einer anständigen Figur führen), aber dies wird nicht der Fall sein ohne Subtilität. Während Sie mit 200 (oder 2000) Punkten die Wellenstränge entlang der Mähne des Pferdes approximieren können.

Bei Audio macht eine niedrigere Abtastrate den Ton nicht “schlecht” (z. B. unscharf, unscharf oder verzerrt), sondern begrenzt die maximale Frequenz (Tonhöhe), die wie beabsichtigt aufgenommen / wiedergegeben werden kann.

Nyquist-Theoremformel

Die Abtastrate von 44,1 kHz wurde für CD gewählt, da sie Frequenzen bis zu 20 kHz aufnehmen und wiedergeben kann. Um ein gesprochenes Wort (wie eine Rede, eine Predigt oder ein Hörbuch) aufzuzeichnen, wäre es schwierig, eine viel niedrigere Abtastrate zu erkennen, da die menschliche Stimme über 10 kHz immer weniger harmonische Informationen enthält.

Tiefenbits:

Berücksichtigt man, dass die Abtastfrequenz bestimmt, wie

häufig

Das Audiosignal wird gemessen, die Bittiefe zeigt an

Skalengenauigkeit

Da es sich um digitales Audio handelt, beschreiben wir diese Messskala in Bits, wobei jedes Bit 0 oder 1 ist, und verketten eine bestimmte Anzahl davon, um den Wert darzustellen. Wenn wir 8 Bits haben, gibt es 256 mögliche numerische Werte, einschließlich Null. Mit 16 Bit gibt es 65.536 mögliche Werte. Ein 24-Bit-Register kann 16.777.216 Werte verwenden.

Wenn wir analoges Audio in digitale Darstellung (A-zu-D) und umgekehrt (D-zu-A) umwandeln, finden wir interessante mathematische Beziehungen. Jedes Bit (digital) verdoppelt die Anzahl der möglichen Werte … Und die Verdoppelung der Amplitude (ungefähr das 4-fache der Leistung) der Schallwelle (analog) entspricht + 6 dB Lautstärke. Daher können wir den maximalen Dynamikbereich * einer digitalen Aufzeichnung auf 6 dB / Bit schätzen. Daher hat die 8-Bit-Aufnahme einen Dynamikbereich von ~ 48 dB, die 16-Bit-Aufnahme (wie eine CD) einen ~ 96 dB und die 24-Bit-Aufnahme einen ~ 144 dB.

* Für diejenigen unter Ihnen, die mit diesem Begriff nicht vertraut sind, beschreibt der Dynamikbereich im Wesentlichen den Unterschied zwischen den leisesten und lautesten Schallwellen, die aufgenommen / wiedergegeben werden können. Die CD hat eine Differenz von ungefähr 96 dB, die verwendet werden kann, um die subtilste Pause im Vergleich zu dem unglaublich lauten Platzen der Kanone bei Tschaikowskys Höhepunkt darzustellen.

1812 Ouvertüre

,

Drei kurze Notizen für alle, die sich mit dem Rhythmus beschäftigen möchten …

Es gibt eine Formel für den tatsächlichen Dynamikbereich einer digitalen Aufzeichnung, die geringfügig von der vorherigen Schätzung abweichen kann, jedoch eine relativ geringe Abweichung darstellt. Daher wird eine Schätzung von 6 dB / Bit normalerweise in Anführungszeichen angezeigt.
Die neuesten 32-Bit-Gleitkomma-Darstellungen kombinieren eine 24-Bit-Zahl und einen 8-Bit-Exponenten, um viel mehr mögliche Werte als 24-Bit-Register darzustellen. Die Schätzung des Dynamikbereichs wird etwas zweifelhaft, reicht jedoch aus, um zu sagen, dass sie deutlich über 144 dB liegt.
Die Verwendung einer geringeren Bittiefe muss, obwohl Sie vielleicht an Warp-Plugins mit Namen wie “Bit-Grinder” denken, nicht “schlecht” klingen (z. B. Fuzzy, Fuzzy oder verzerrt), sondern nur repräsentiert einen reduzierten Dynamikbereich. Da jedoch eine 16-Bit-Aufzeichnung mit einem Dynamikbereich von 96 dB (65.536 numerische Werte) nicht in 8 Bit (48 dB und 256 numerische Werte) dargestellt werden kann, um die Bittiefe des bereits digitalisierten Audios zu verringern, a mathematische Korrektur der Zahlen nach unten. (65535 wird beispielsweise zu 255) Verwenden eines Kompressors oder Begrenzers, wodurch die leisesten Aufnahmebits verloren gehen können, sodass der Unterschied zwischen leisen und lauten Teilen <48 dB beträgt. Ohne ein solches Schema führt die Transformation zu Übersteuerungen (numerische Werte über dem Maximum).
Bitrate:

Bei digitalem Audio ist die Bitrate ein Maß für

Wie viele Bits werden pro Sekunde übertragen / verarbeitet?


Free Download Mp4Gain
picture

Vorteile von “digitalem Audio”

Vorteile von “digitalem Audio”

Digital Audio

Das digitalisierte Audiosignal hat folgende Vorteile:

DIGITAL AUDIO

-die Möglichkeit einer unendlich langen Lagerung ohne Verlust der Originalqualität,

-die Fähigkeit, lange Zeit zu reproduzieren, ohne die ursprüngliche Qualität zu verlieren,

-die Möglichkeit einer unendlichen Reproduktion ohne Verlust der Originalqualität,

-Einfachheit und breite Verarbeitungsmöglichkeiten mit modernen Mitteln,

-Resistenz gegen Störungen in Signalübertragungsleitungen.

Von CD zu Super Audio CD und DVD Audio

CD (Compact Disk) ist eine Art austauschbarer Kunststoffdiskette mit optischem Lesen von Informationen.

1979 schlugen Sony und Philips den Red Book-Standard für digitale Audioaufnahmen vor.

Analoger Ton wird digitalisiert und als spiralförmige Spur abwechselnder Nullen und Einsen (Mikronlöcher und eine glatte Oberfläche) auf einer 12-cm-Polycarbonatscheibe aufgezeichnet, die etwas dicker als ein Millimeter ist und mit der dünneren Schicht bedeckt ist Gold (später Aluminium).

Der Laser des Players beleuchtet die Disc und erkennt binäre “Nullen” und “Einsen”, die nach der Verarbeitung wieder in Ton umgewandelt werden. Es ist fast unmöglich, Null mit Eins zu verwechseln. Mögliche Probleme im Zusammenhang mit Lesefehlern und Kratzern auf der Disc-Oberfläche wurden durch digitale Fehlerkorrektur ausgeglichen.

Infolgedessen verringerten sich nicht nur die physischen Abmessungen des Plattenhalters im Vergleich zur Schallplatte, sondern auch die musikalische Kapazität erheblich: bis zu 74 Minuten (der damalige Besitzer von Sony wollte, dass seine Lieblings-Neunte Symphonie von Beethoven in eine passt Scheibe).

1982 begann in Langenhagen (Deutschland) die Massenproduktion von CDs mit der “Alpensinfonie” von I. Strauss.

Echt

Hochwertiges Audio wird jetzt in den Super Audio CD- und DVD-Audioformaten aufgenommen, die:

Verwenden Sie ein DVD-Medium.

Mehrkanalaufzeichnung verwenden (bis zu 5.1),

Abtastrate bis 192 kHz,

Quantisierungspegel: bis zu 24 Bit (jedes Bit verdoppelt die Genauigkeit der Schallübertragung, und bei einer solchen Quantisierungstiefe kann der Dynamikbereich der wiedergegebenen Töne 130 dB überschreiten).

Die neuen Aufnahmeformate bieten die höchste Qualität, sind teuer (15 US-Dollar pro Disc) und nicht beliebt, da sich die meisten Hörer leider nicht allzu sehr um die Klangqualität kümmern.

Digitale Audiooptionen

Die wichtigen Parameter der digitalen Darstellung von Ton sind die Abtastrate der Audiosignale und die Quantisierung von Bits.

Quantisierungsraten geben an, wie oft pro Sekunde ein Signal zur Umwandlung in digitalen Code abgetastet (gemessen in der Amplitude) wird.
Für den CD-Standard sind es 44 kHz (44.000 Mal pro Sekunde), für SACD 192 kHz

Das Quantisierungsbit charakterisiert die Anzahl der Signalschritte und wird durch die Potenz von 2 gemessen.

Für den CD-Standard werden 16-Bit-Audioadapter verwendet, die 65.536 Quantisierungsschritte (2 bis 16 Potenzen) aufweisen, wie bei einer Audio-CD. Für Standard- und 24-Bit-SACD.

Digitaler Audiospeicher

Informationen zum Digitalisieren von Ton enthält eine Reihe von Signalamplitudenwerten, die in regelmäßigen Abständen erfasst werden und in Dateisequenznummern (Amplitudenwerte) geschrieben werden können.

Zwei Methoden werden häufig zum Codieren von Audioinformationen verwendet:

PCM (Pulscodemodulation)

ADPCM (Adaptive Relative Pulse Code Modulation)

PCM (Pulse Code Modulation) ist ein Verfahren zum digitalen Codieren eines Signals durch Aufzeichnen der Absolutwerte der Amplituden. So werden Daten auf allen Audio-CDs aufgezeichnet.

ADPCM (Adaptive Delta PCM) – Zeichnet Signalwerte in relativen Amplitudenänderungen (Inkrementen) auf, sodass Sie Daten vereinfachen können, um weniger Speicherplatz zu beanspruchen.

Die verlustfreie Codierung (für verlustfreie Daten-Odirovanie) ermöglicht die Datenwiederherstellung aus einem vollständig komprimierten Stream (20-50%).

Beliebte verlustfreie Codierungsalgorithmen:

Windows Wave (WAV) ist das primäre Audiodateiformat für Windows.
Das Audio Interchange File Format (AIFF) ist das primäre Audioformat für den Macintosh.

Mit der Verlustcodierung (verlustbehaftete Datencodierung) können Sie eine Klangähnlichkeit des rekonstruierten Signals zum Original mit der höchstmöglichen Datenkomprimierung (10-1 5-mal) erzielen.

Die Basis von Lossy-Encodern ist die Verwendung von psychoakustischen Modellen: Bestimmte Teile des Signals in bestimmten Frequenzbereichen, die für das menschliche Ohr nicht hörbar sind, Nuancen (maskierte oder unhörbare Frequenzen) und treten auf, um sie aus dem ursprünglichen Signal zu entfernen.

Analoges Audio und digitales Audio

Analoges Audio und digitales Audio

Analog vs Digital Audio

Eine Schallwelle ist eine Art komplexe Funktion, die Abhängigkeit der Amplitude einer Schallwelle von der Zeit.

Analog Audio vs. Digital Audio

Die in der Schallwelle enthaltenen Informationen werden nicht durch die Parameter des Mediums, in dem sich die elastische Welle ausbreitet, und die Schwingungsparameter (Amplitude und Frequenz, Ton und Harmonische) bestimmt.

Jede Form der Aufzeichnung (mechanisch und Skye, magnetisch, optisch, Laser) basiert auf der vorherigen Umwandlung der Schallwelle in einen elektrischen Wechselstrom mit den gleichen Parametern der Schwingungen (über ein Mikrofon).

Analoger Ton wird auf dem Gerät als kontinuierliches elektrisches Signal dargestellt.

Die Klangqualität hängt von der Wiedergabetreue der Wellenform ab, die sehr schwer aufrechtzuerhalten ist.

Bis 1982 konsumierte die Welt “Dosenmusik” nur von analogen Medien: Schallplatten und Magnetbändern.

Gute Schallplatten, die mit guter Ausrüstung gespielt wurden, boten eine hervorragende Klangqualität, die sich leider bei jedem Hören aufgrund mechanischer Abnutzung ein wenig verschlechterte, wenn sich der Stift entlang der Klangrille in den Klang bewegte Staub, der alles durchdrang.

Bandrekorder erforderten präzise Leseköpfe und hohe Bandvorschubgeschwindigkeiten, um eine reibungslose Wiedergabe zu gewährleisten. Mit der Zeit entmagnetisierte sich das Band, die Magnetschicht brach zusammen.

Der Hauptnachteil der analogen Audioaufnahme ist jedoch der unvermeidliche Qualitätsverlust beim Kopieren.

Das Geheimnis der Trigonometrie

Nach der Theorie des Mathematikers Jean Baptiste Fourier kann eine Schallwelle als ein darin enthaltenes Frequenzspektrum dargestellt werden.

Die Frequenzkomponenten des Spektrums sind sinusförmige Schwingungen (reine Töne), von denen jede ihre eigene Amplitude und Frequenz hat.

Nach dem Satz von Kotelnikov kann jede Schwingung, selbst die komplexeste Form (zum Beispiel eine menschliche Stimme), eindeutig und ohne Verlust aus ihren diskreten Abtastwerten mit einer Frequenz wiederhergestellt werden, die der doppelten Maximalfrequenz entspricht.

Vladimir Aleksandrovich Kotelnikov (1908-2005) – ein bekannter sowjetischer und russischer Wissenschaftler auf dem Gebiet der Funktechnik, Funkkommunikation und Radioastronomie.

Überwachung . Das Signal mit endlicher Dauer hat ein unendlich breites Spektrum. Wenn ein Signal mit einer endlichen Dauer abgetastet wird, ist es daher unmöglich, es ohne Qualitätsverlust aus den Abtastwerten wiederherzustellen.

Digitalisierung von Audioinformationen

Die Digitalisierung von Schall ist die Aufzeichnung der Amplitude des Signals in bestimmten Intervallen und die Aufzeichnung der Amplitudenwerte, die in Form gerundeter digitaler Werte erhalten werden.
Jeder Computer enthält ein Motherboard und einen Audioadapter (Soundkarte).

Zu den Soundkarten gehören: ADC (Analog-Digital-Wandler), Synthesizer, Mixer, DAC-Verstärker (Digital-Analog-Wandler), MIDI-Schnittstellenanschluss für Spielgeräte.

Um digitalen Ton aufzunehmen, erzeugt der ADC:

zeitliche Abtastung eines kontinuierlichen Signals (bestimmt den Wert der Amplitude des Signals mit der Frequenz, die erforderlich ist, um seine ursprüngliche Form wiederherzustellen = die doppelte maximale Frequenz der Schallwelle);

Quantisierung durch die Pegel der gemessenen Signalwerte (bestimmt die Anzahl der festen Werte (Pegel, Abstufungen) der Amplitude des Signals);

Signalcodierung (Schreiben in ein Binärzahlensystem).

Der umgekehrte Vorgang wird vom DAC (Digital-Analog-Wandler) ausgeführt.

Bitrate

Bitrate (Bitrate): buchstäblich Informationsbits der Übertragungsrate.

Die Bitrate ist die effektive Informationsübertragungsrate durch den Kanal (die Übertragungsrate von “nützlichen Informationen” zusätzlich zu den Dienstinformationen), ausgedrückt in Kilobit pro Sekunde (Kilobit pro Sekunde, kbps).

In verlustbehafteten Komprimierungsvideo- und Audioübertragungsformaten drückt der Bitratenparameter den Komprimierungsgrad des Streams aus und bestimmt somit die Größe des Kanals, für den der Datenstrom komprimiert wird.

P-Modus-Komprimierungsdatenstrom:

mit konstanter Bitrate (konstante Bitrate, CBR) – Die erforderliche Bitrate wird anfänglich eingestellt, die sich in der gesamten Datei nicht ändert. Es ermöglicht eine recht genaue Vorhersage der endgültigen Dateigröße, bietet jedoch kein optimales Verhältnis von Größe zu Qualität für Musikwerke, deren Klang sich im Laufe der Zeit dynamisch ändert.

mit variabler Bitrate (VBR): Der Codec ändert den Wert der Bitrate basierend auf dem gewünschten Qualitätsniveau gemäß dem psychoakustischen Modell. Es bietet die beste Qualität der Ausgabedatei, ist jedoch nicht vorhersehbar (es kann sich mehrmals unterscheiden).

mit einer durchschnittlichen Bitrate (ABR): eine Mischung aus konstanten und variablen Bitraten: Der Benutzer stellt die Bitrate in kbit / s ein und das Programm variiert sie innerhalb bestimmter Grenzen.

DRM ist ein moderner Standard für digitale Sendungen

DRM ist ein moderner Standard für digitale Sendungen

DRM

Betrachten Sie das Problem einer kompakten Darstellung der Audiosignale von Nia in Standard-DRM, dem neuen Wespenstandard mit dem Som-Index ISO / IES 14496 (MPEG-4-Standard).

DRM

Der dritte Teil dieser Norm (“Sound”) beschreibt die codierte Darstellung natürlicher und synthetischer Klangbeispiele. Diese Unterscheidung ermöglicht es, den Hauptteil, der ein individuelles Merkmal des gegebenen Signals ist, von den übertragenen Klangkompositionen und den Teil zu unterscheiden, der auf einem Computer synthetisiert werden kann. Bei der Übertragung eines Audiosignals müssen dessen Hauptteil und Beschreibung übertragen werden. Dies ist der Teil des Signals, der am Empfangsende synthetisiert werden kann. Die Übertragung einer Beschreibung des Signals anstelle von sich selbst ermöglicht es, auf der Empfangsseite in Echtzeit eine exakte Analogie des ursprünglichen Klangfragments wiederherzustellen
bei niedrigen Verkehrsflussgeschwindigkeiten. Dies war eines der Probleme, die die DRM-Community basierend auf dem MPEG-4-Standard löste.

DRM verwendet Advanced Audio Coding (AAC) und Linear Predictive Speech Coding (CELP und HVXC) für harmonische Vektoren. Für eine spürbare Verbesserung der Klangqualität (insbesondere bei AAS) kann eine spezielle Methode verwendet werden, um die Effizienz (Hochfrequenzrekonstruktion) der Klangcodierung (SBR) zu erhöhen.

Das codierte Audioübertragungssignal wird als Superframes (Superframes) konstanter Länge dargestellt. In Superframes wird ein Informationsdienst UEP bereitgestellt (dh reine Sprache). Spezifische Informationen zur Konfiguration des Audiodatenstroms werden auf dem DEZA-Kanal übertragen. Beachten Sie, dass, wenn beim Codieren eines Kanals keine besonderen Maßnahmen ergriffen werden, alle Informationsbits gleichermaßen gegen Kanalfehler geschützt sind (EEP-Algorithmus), dh der Schutz wird mit dem gleichen Grad an Redundanz ausgeführt. Gleichzeitig ist bekannt, dass die menschliche Wahrnehmung von Schall durch eine ungleichmäßige Empfindlichkeit gegenüber Fehlern gekennzeichnet ist, die im digitalen Informationsstrom am Ausgang des Codierers auftreten. Daher ist es ganz natürlich, einen ungleichen Schutz gegen Fehler bieten zu wollen, dh einen höheren Schutzgrad für diesen Teil der Informationsbits zu erweitern.

MPEG-4 AAC
Abbildung 1. Struktur des AAC-Audio-Superframes Für die universelle Audio-Codierung wird der MPEG-4-AAC-Algorithmus verwendet, der beste ähnliche Algorithmus, der für die Verwendung in DRM-Systemen geeignet ist. Bei der Standardanwendung eines Mono-AAC-Codierers auf dem Kurzwellenkanal (KB) wird eine Bitrate von 20 kbps bereitgestellt. Von den möglichen Erweiterungen des Standards ist nur die SBR-Technologie zulässig.

Der MPEG-4 AAC-Audiocodierungsstandard ist Teil des MPEG-4-Audiostandards (ISO / IEC 14496-3 + ISO / IEC 14496-3 / Amd1). Der digitale AAC-Stream im DRM-System ist ein digitaler Stream des MPEG-4-Audiostandards, Version 2 (für die Verwendung auf Kanälen mit hoher Interferenz). Von den möglichen Arten von Audio-Encodern (ISO / IEC-Standardobjekte) gehört nur die LC-Version (Low Complexity) des ER AAC-Encoders zu den hochwertigen Codierungsalgorithmen – sie wird im DRM-System verwendet. Unter den vorhandenen Methoden zum Organisieren eines digitalen Streams MPEG-4 AAC, Version 2, wird die Version ausgewählt, die gegen Rauschen HCR (Huffman Codeword Reordering) immun ist und sich durch eine geringe Empfindlichkeit der Audiodaten gegenüber Fehlern im Übertragungskanal auszeichnet und eine minimale digitale Bitrate.

Die Eigenschaften der digitalen Strombildung am Ausgang des AAC-Codierers im DRM-System sind wie folgt:

Die Bitrate kann beliebig sein, muss jedoch in Schritten von 20 Bit / s geändert werden, um die Ausrichtung des 400-Millisekunden-Audio-Overframes sicherzustellen.
Abtastfrequenzwerte (f d) – 12 und 24 kHz;
Die Konvertierungslänge beträgt 960 Samples, was je nach Samplerate der Dauer eines Soundframes von 80 oder 40 ms entspricht. Diese Auswahl stellt sicher, dass die Dauer der Audio-Frames mit dem logischen Frame bei der MSC übereinstimmt.
Geräuschunempfindlichkeit. Der MPEG-4-Encoder verfügt über die Mittel zum Schutz des digitalen AAC-Streams auf Kanälen mit hoher Interferenz.
Super-Audio-Frames: 5 (fd = 12 kHz) oder 10 (fd = 24 kHz) Audio-Frames bilden einen Super-Frame. Ein Audio-Superframe hat eine konstante Länge (400 ms), die die Möglichkeit bestimmt, ihn mit einer Anzahl (5 oder 10) der einfachsten Audio-Frames zu füllen, von denen jeder auch aus zwei Teilen bestehen muss. Ein Audio-Superframe wird immer in einem logischen Frame übertragen (siehe Teil 2, BC Nr. 8). Aus diesem Grund ist während der Audiokodierung keine zusätzliche Synchronisation erforderlich. Die Struktur des Audio-Superframes sieht auch die Implementierung der Funktion für ungleichmäßigen Schutz vor.